
多个 VLA 在 LIBERO 仿真基准上的成功率已经超过 95%,但这些分数里有多少需要超出训练示范的泛化,一直不清楚。Sereact GmbH(斯图加特)的 Denis Grachev、Damien LaRocque 与 Omar Moured 在预印本 How Much of Your VLA Is kNN(arXiv 2611.13160,2026-11-09)里给出一个直接的参照:不训练任何策略,只在示范里找与当前观测最近的几帧,把它们后面的动作块加权平均后执行。作者报告,这个最近邻(kNN)策略在 LIBERO 上达到 91.7%;换到 LIBERO-Plus 的扰动变体后,它的成功率下降幅度是所测策略中最小的。论文据此建议,VLA 的基准成绩应与检索基线一起报告。以下数字均为作者报告 [R],本站没有运行作者的代码。
做法:把示范变成一张查找表
离线阶段,作者把每条示范每隔一帧存一次:观测、它后面长度为 H 的动作块、以及来自哪条示范。LIBERO 的 1693 条示范共得到约 137k 条记录。执行时,当前观测与每条记录算一个加权距离,分项包括图像特征、机器人状态、语言指令、回合内时间步和最近几帧的历史;视觉、状态和时间项除以同任务内距离的中位数(语言项按不同指令之间的距离中位数归一化,夹爪项不归一化),使量纲不同的分项可以相加。取距离最小的 k 条记录,且每条示范最多取一条,避免整段照搬某一条示范;再按距离做 softmax 加权,平均它们的动作块。
图像特征来自冻结的 ImageNet 预训练 ResNet-18(第 3 层的 4 × 4 空间网格),语言用归一化的 CLIP 向量。作者比较了三个变体,执行的动作都是示范动作的加权组合:
- kNN(ResNet):只用图像距离,只在当前指令对应任务的示范里检索,k = 8,执行完整个加权动作块后再检索。
- kNN(multimodal):在全部示范里用完整的多项距离检索,k = 13,另加 mode seeking(降低偏离主导动作模式的近邻的权重)和时间集成(每个控制步重新规划,并合并重叠的预测)。
- kNN(LAC key):检索和执行与上一个相同,但在 ResNet 特征上加一个学出来的线性投影,训练目标是第五节介绍的 LAC 指标的可微替代。它是三者中唯一经过训练的。
超参数用 Optuna 搜索。LIBERO 没有单独的验证集,搜索用的是每个任务的初始状态 40–49(共 400 回合),这些状态也属于官方评测协议。作者在从未用于搜索的初始状态 0–39 上复核,multimodal 变体为 91.6%,全部 50 个状态上为 91.7%。
LIBERO 与 LIBERO-Plus 上的成绩
LIBERO 部分用 Spatial、Object、Goal、Long 四个套件共 40 个任务,按官方协议每个任务 50 回合,每个策略 2000 回合。LIBERO-Plus 对同样的任务施加七类扰动,作者固定选了 420 个变体(每类 60 个),所有策略共用,且不参与训练和调参。九个 VLA 都是 LeRobot 上公开的 LIBERO 检查点,按发布时的观测、动作与推理约定原样评测。下表是论文表 1 的平均列(%),Δ 是 LIBERO-Plus 平均值减 LIBERO 平均值,单位为百分点(pt),按舍入前的值计算;VLA 按 LIBERO-Plus 平均值排序,与原表相同。
| 策略 | LIBERO 平均 | LIBERO-Plus 平均 | Δ(pt) |
|---|---|---|---|
| π0.5 | 97.7 | 85.5 | -12.2 |
| MolmoAct2 | 97.5 | 82.6 | -14.9 |
| GR00T N1.7 | 94.9 | 80.2 | -14.6 |
| VLA-JEPA | 97.2 | 74.0 | -23.1 |
| Evo-1 | 95.4 | 71.4 | -24.0 |
| X-VLA | 94.5 | 64.5 | -30.0 |
| π0 | 71.9 | 42.9 | -29.0 |
| SmolVLA | 82.2 | 27.9 | -54.3 |
| π0-FAST | 90.6 | 25.7 | -64.8 |
| kNN(ResNet),免训练 | 88.7 | 75.5 | -13.2 |
| kNN(multimodal),免训练 | 91.7 | 82.4 | -9.3 |
| kNN(LAC key),训练了检索键 | 93.0 | 81.7 | -11.3 |
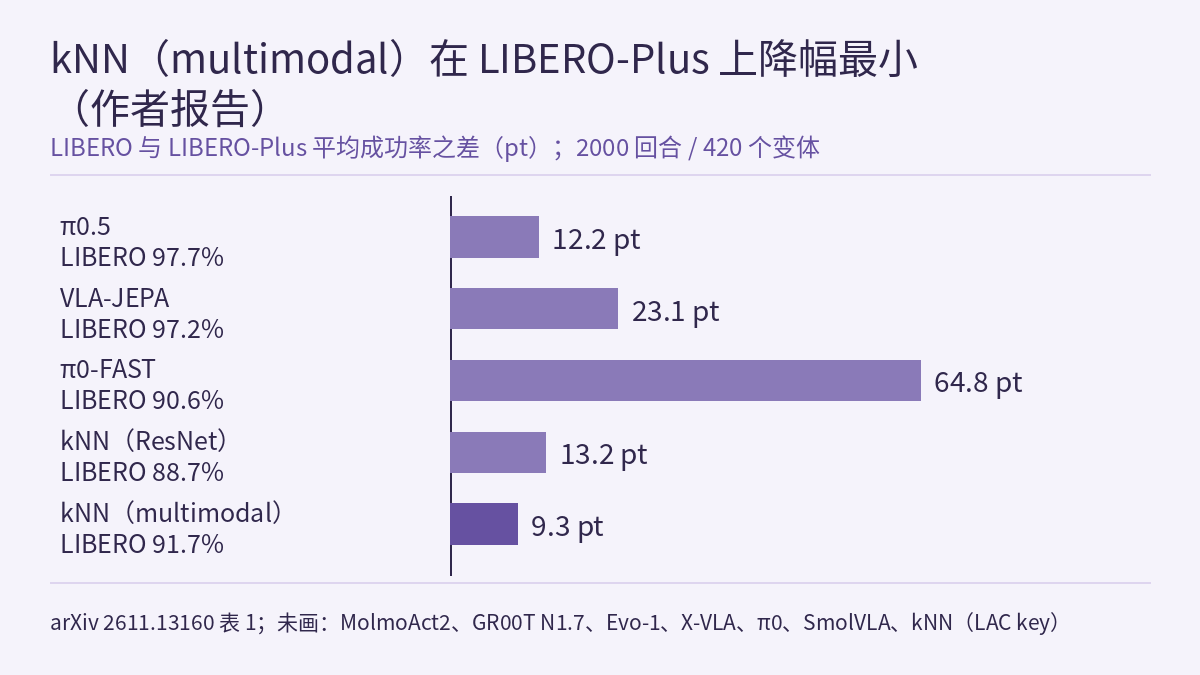
文中的图画出其中五行的降幅,即 LIBERO 平均减 LIBERO-Plus 平均,等于表中 Δ 的绝对值,顺序与表相同:π0.5 12.2 pt,VLA-JEPA 23.1 pt,π0-FAST 64.8 pt,kNN(ResNet)13.2 pt,kNN(multimodal)9.3 pt。
两个基准上成功率最高的都是 π0.5。kNN 策略在 LIBERO 上与 π0-FAST 相当,高于 SmolVLA 和 π0。VLA-JEPA、Evo-1、X-VLA 在 LIBERO 上都超过 94%,到 LIBERO-Plus 却低于免训练的 ResNet 变体(75.5%)。multimodal 变体在 LIBERO-Plus 上高于 9 个 VLA 中的 7 个,9.3 pt 的降幅是所有策略中最小的。作者的解读是,LIBERO 上的高分不一定意味着在 LIBERO-Plus 扰动下同样稳健。附录 C 按扰动类别拆分后还有一个细节:相机扰动使所有策略的成功率下降,只有 LAC key 变体例外,达到 88%,其余策略最高 73%。
读这张表时有两点要注意。第一,论文只给了 LIBERO 的区间:2000 回合下 95% 置信区间约为 ±1.2 pt;LIBERO-Plus 没有给区间,所读正文也没有写每个变体跑几次。若每个变体只跑一次,成功率在 80% 左右时,420 次的 95% 区间半宽约为 3.8 pt(本站按二项分布粗算)。kNN(multimodal)与 π0.5 的降幅相差 2.9 pt,不宜读成确定的排序。第二,π0 和 SmolVLA 的复现成绩低于其作者报告的数字,论文认为这可能反映公开检查点与原论文所用检查点的差别;表中的 VLA 数字是“公开检查点原样运行”的结果,不是各模型的最好成绩。
检索靠什么:消融结果
作者每次只改 multimodal 变体的一个部件(附录表 3,LIBERO 2000 回合):
- 只保留 10% 的示范,成功率从 91.7% 降到 77.4%;保留 25% 和 50% 时为 82.6% 和 88.5%。
- 用 16 × 16 的原始像素代替 ResNet-18 特征,降到 57.2%,其中 LIBERO-Object 为 0.0%。这个套件的 10 个任务共用一个放着多个小物体的场景。
- 忽略语言指令,下降 27.1 pt,主要落在 LIBERO-Goal(8.8%)。Goal 套件的 10 个任务也共用一个场景(附录 D),因此主要靠指令区分(本站推断)。
- 去掉 mode seeking、时间集成、历史匹配、机器人状态或时间步特征,平均成功率的变化都不超过 1 pt,在 ±1.2 pt 的区间以内。
- k 在 4 到 32 之间,成功率在 89.4% 到 92.7% 之间;k = 1,即只回放最近的那条示范,降到 78.6%。
作者的归纳是:视觉表示、语言指令和示范数量决定了大部分成绩,其余细节贡献较小。超参数重要性分析(fANOVA)也指向同一方向:k 和“每条示范最多一个近邻”的约束分别占 57% 和 25%。
用检索去量 VLA
同一套查找方法也可以用来检查 VLA 本身。作者把 ResNet 变体的图像特征换成某个 VLA 的 VLM 主干在某一层的图像 token 隐状态,比较 LIBERO 微调前后这个主干作为“检索键”的效果(论文表 2):
- 微调后检索成功率提高的,LIBERO 上是 8 个经过微调的 VLA 中的 5 个,LIBERO-Plus 上是 7 个,提高 5 到 37 pt。这些 VLA 从 LIBERO 到 LIBERO-Plus 的降幅也从微调前的 20.9–34.7 pt 缩小到 10.4–21.0 pt。GR00T N1.7 冻结 VLM,所以前后相同,不计入这 8 个。
- 效果并不普遍:π0 的主干微调后,LIBERO 检索成功率从 86.9% 跌到 17.9%(LIBERO-Plus 从 56.7% 到 2.4%)。它的检索键在 t-SNE 图上塌缩成每个任务一团,最近邻仍属同一任务,但一帧与另一条同任务示范中最近帧的进度差中位数从 0.028 增大到 0.052。
- 有些模型只用微调后的主干做检索,就超过完整的 VLA:LIBERO 上 9 个中有 2 个,LIBERO-Plus 上有 4 个,差距最大 48 pt。例如 π0-FAST 的主干检索在 LIBERO-Plus 上为 74.0%,完整模型为 25.7%。作者认为这说明这些模型的动作头没有用上主干里全部与动作相关的信息。
作者还比较了 VLA 在自己的 LIBERO rollout 中输出的动作块与 kNN 预测(同任务 8 个最近示范帧的动作块加权平均)。作为参照,这个 kNN 预测与留出的真实动作块之间的 R² 为 0.78。VLA 的动作块与 kNN 预测之间的 R² 在 0.63 到 0.93 之间,8 个 VLA 中有 5 个比真实动作块更接近 kNN 预测。所有 VLA 的动作块与同任务最近训练动作块的平方误差中位数,是留出真实动作块对应值的 0.62–0.99 倍。X-VLA 输出绝对位姿,不在这项比较里。作者的表述是,这些结果提示 VLA 在 LIBERO 上的动作仍贴近示范动作。
附录 D 还有一个与“忽略指令”消融对应的观察:在 LIBERO-Goal 里,只有图像 token 能注意到指令的表示(π0、π0.5、π0-FAST 所用 PaliGemma 的双向前缀注意力,以及 X-VLA 的 Florence-2 编码器)能把 10 个任务分开,同任务最近邻比例为 96–100%;图像 token 排在指令前面的因果注意力 VLM 只有 76–82%,ResNet-18 为 79%。
LAC:不跑 rollout 先评检索键
闭环评测一个检索键要跑上千回合。作者提出局部动作一致性(Local Action Consistency,LAC)做离线估计:对每个留出的查询帧,比较它在表示空间里 k 个最近邻的未来动作块与它自己的动作块有多接近,再除以它与同任务全部记录的平均动作差距,用 1 减去这个比值。值越高,表示空间里挨得近的帧,后续动作也越相似。论文报告 LAC@8。
结果分三点。排除在留出示范上训练过的微调 VLM 主干后,LAC 与闭环检索成功率的 Pearson r 为 0.78,但 Spearman ρ 只有 0.61,对质量相近的检索键排不准顺序。它能标出退化的 π0 微调主干:0.55,其余检索键为 0.76–0.88。用 LAC 的可微替代训练 ResNet 特征上的线性投影,普通 kNN 查找的成功率从 88.7% 提高到 93.0%,即表中的 LAC key 变体。
对读 VLA 评测表的意义
作者在结论里建议,把检索基线与 VLA 成绩一起报告,用来区分基准记忆和泛化。两个免训练变体在 LIBERO 上是 88.7% 和 91.7%;按本站的读法,一个 VLA 在 LIBERO 上的分数如果只比这条参照线高几个百分点,就很难单凭它说明超出示范的泛化。物理AI实验室 1.6 讲过模仿学习的误差怎样把机器人带出示范覆盖的范围;这篇论文从另一侧补充:作者认为,在 LIBERO 这类示范密集的基准上,把测试状态匹配到示范状态、复用其动作,就能复现大部分成功行为。怎样用配对表和随机种子判断两个成功率的差异,见 物理AI实验室 1.8。
本站介绍过的两篇论文与此相关。RESETTLE 在策略持续出现分歧时检索同任务示范帧来纠正,把检索当作冻结策略的补充;本篇把检索本身当作策略和测量工具。Is Success All You Need? 同样基于 LIBERO-Plus 扰动基准,只看成功轨迹的执行质量,本篇的数字仍是任务成功率,不涉及轨迹质量。
想复核的读者可以从两处入手:论文附录表 4 列出了每个 VLA 检查点的 Hugging Face 仓库和提交号(例如 π0.5 为 lerobot/pi05_libero_finetuned_v044,修订 8e174154);作者称评测和源代码发布在 github.com/sereact/lerobot_knn。本站没有打开或运行这个仓库。
局限 / 注意
- 这是 arXiv 预印本,全部数字为作者报告 [R],本站没有复现,也没有运行作者发布的代码。
- 结论只限于 LIBERO 及相关基准。作者指出,这些基准示范覆盖较密,可能对检索方法有利;LIBERO-Plus 的扰动大体保留了原任务和解法轨迹,所以这里的鲁棒性主要是对观测和指令变化的鲁棒性,不涉及需要新轨迹的情况。
- 作者明确写道,检索无法外推到记忆覆盖范围之外,这些基准上的好成绩不应被解读为 kNN 策略能在机器人问题上广泛泛化。
- 九个 VLA 都是公开检查点原样运行,部分低于其原论文报告的成绩(π0 和 SmolVLA 尤其明显)。
- kNN 的超参数搜索用到了官方评测中的初始状态 40–49;作者在 0–39 上的复核(91.6% 对 91.7%)显示影响很小。LIBERO-Plus 没有给出区间,降幅之间几个百分点的差距要谨慎解读。
- 所有结果都来自仿真,是任务成功率,不是真机或硬件安全验证。


