
LIBERO シミュレーションベンチマークでは、すでに複数の VLA が 95% を超える成功率を出しています。しかし、そのスコアのうち学習用お手本を超えた汎化を必要とする部分がどれだけあるのかは、はっきりしていませんでした。Sereact GmbH(シュトゥットガルト)の Denis Grachev、Damien LaRocque、Omar Moured はプレプリント How Much of Your VLA Is kNN(arXiv 2611.13160、2026-11-09)で、直接的な比較基準を示しています。方策はまったく学習せず、現在の観測に最も近いお手本のフレームをいくつか探し、その後に続く動作チャンクを重み付き平均して実行するというものです。著者の報告では、この最近傍(kNN)方策は LIBERO で 91.7% に達し、LIBERO-Plus の摂動バリアントに移ったときの成功率の低下幅は、評価したすべての方策の中で最小でした。論文はこれを根拠に、VLA のベンチマーク結果は検索ベースラインと並べて報告すべきだと提案しています。以下の数値はすべて著者報告 [R] で、本サイトは著者のコードを実行していません。
手法:お手本を検索表にする
オフラインでは、各お手本を 1 フレームおきに保存します。保存するのは観測、その後に続く長さ H の動作チャンク、そしてどのお手本から来たかです。LIBERO の 1693 件のお手本から約 137k 件のエントリができます。実行時には、現在の観測と各エントリの間で重み付き距離を計算します。項は画像特徴、ロボットの状態、言語指示、エピソード内の時間ステップ、直近の観測履歴です。視覚、状態、時間の項は同じタスク内での距離の中央値で割り、スケールの異なる項を足し合わせられるようにしています(言語の項は異なる指示同士の距離の中央値で正規化し、グリッパーの項は正規化しません)。距離が最も小さい k 件を取りますが、1 件のお手本からは最大 1 件までとし、特定のお手本を丸ごとなぞらないようにします。そのうえで距離に対する softmax で重みを付け、動作チャンクを平均します。
画像特徴は凍結した ImageNet 事前学習済み ResNet-18(第 3 層の 4 × 4 空間グリッド)から、言語は正規化した CLIP 埋め込みから取ります。著者は 3 つの変種を比べています。いずれも、実行する動作はお手本の動作の重み付き組み合わせです。
- kNN(ResNet):画像距離のみを使い、指示されたタスクのお手本だけから検索します。k = 8 で、重み付きチャンクをすべて実行してから再検索します。
- kNN(multimodal):全お手本から、すべての項を含む距離で検索します。k = 13 で、mode seeking(主要な動作モードから外れた近傍の重みを下げる)と時間アンサンブル(制御ステップごとに再計画し、重なった予測を合成する)を加えます。
- kNN(LAC key):検索と実行は前の変種と同じですが、ResNet 特徴に学習した線形射影をかけます。学習目標は第 5 節で紹介する LAC 指標の微分可能な代替です。3 つのうち学習を含むのはこれだけです。
ハイパーパラメータは Optuna で探索しました。LIBERO には独立した検証用の分割がないため、探索には各タスクの初期状態 40〜49(計 400 エピソード)を使っています。これらの状態は公式評価プロトコルにも含まれます。著者が探索に一度も使っていない初期状態 0〜39 で確認したところ、multimodal 変種は 91.6% で、50 状態すべてでの 91.7% とほぼ同じでした。
LIBERO と LIBERO-Plus での成績
LIBERO の評価には Spatial、Object、Goal、Long の 4 スイート、計 40 タスクを使い、公式プロトコルどおり各タスク 50 エピソード、方策ごとに 2000 エピソードを実行します。LIBERO-Plus は同じタスクに 7 種類の摂動を加えるもので、著者は 420 のバリアント(各種類 60)を固定して選び、全方策で共有し、学習と調整からは外しています。9 つの VLA はいずれも LeRobot で公開されている LIBERO 用チェックポイントで、公開時の観測・動作・推論の約束事のまま評価しています。下の表は論文の表 1 の平均列(%)です。Δ は LIBERO-Plus の平均から LIBERO の平均を引いた値で、単位はポイント(pt)、丸める前の値から計算しています。VLA は元の表と同じく LIBERO-Plus の平均の順に並んでいます。
| 方策 | LIBERO 平均 | LIBERO-Plus 平均 | Δ(pt) |
|---|---|---|---|
| π0.5 | 97.7 | 85.5 | -12.2 |
| MolmoAct2 | 97.5 | 82.6 | -14.9 |
| GR00T N1.7 | 94.9 | 80.2 | -14.6 |
| VLA-JEPA | 97.2 | 74.0 | -23.1 |
| Evo-1 | 95.4 | 71.4 | -24.0 |
| X-VLA | 94.5 | 64.5 | -30.0 |
| π0 | 71.9 | 42.9 | -29.0 |
| SmolVLA | 82.2 | 27.9 | -54.3 |
| π0-FAST | 90.6 | 25.7 | -64.8 |
| kNN(ResNet)、学習なし | 88.7 | 75.5 | -13.2 |
| kNN(multimodal)、学習なし | 91.7 | 82.4 | -9.3 |
| kNN(LAC key)、検索キーを学習 | 93.0 | 81.7 | -11.3 |
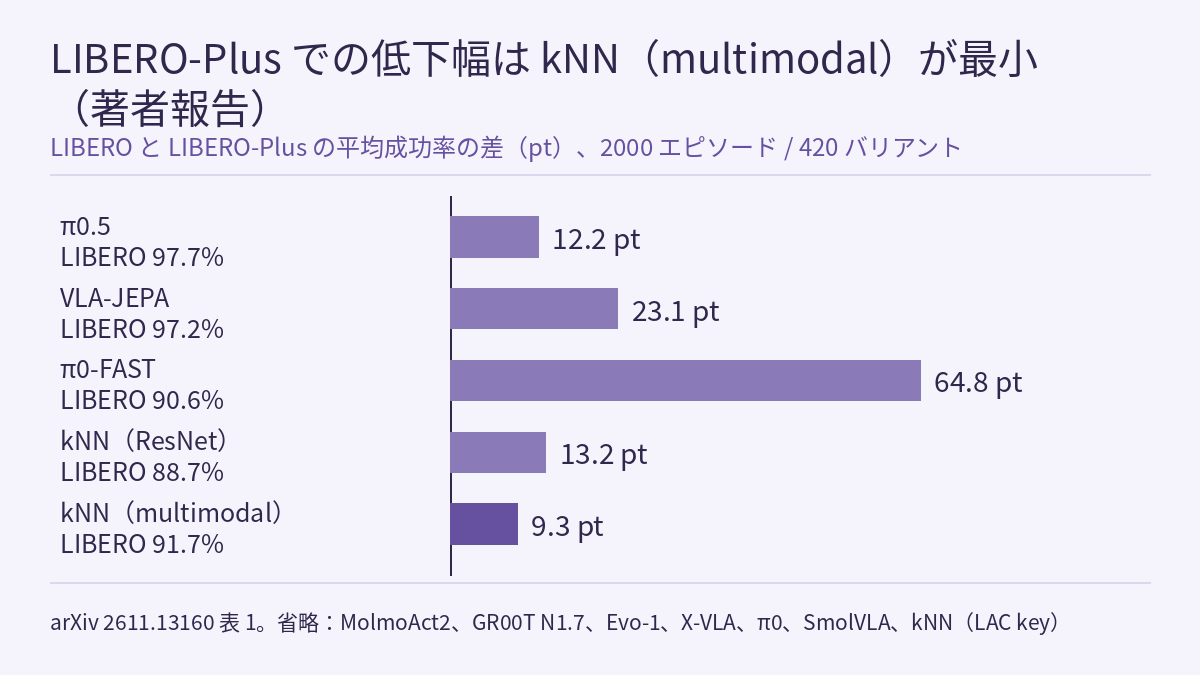
本文の図は、このうち 5 行の低下幅を表と同じ順に描いています。低下幅は LIBERO の平均から LIBERO-Plus の平均を引いた値で、表の Δ の絶対値に等しく、π0.5 が 12.2 pt、VLA-JEPA が 23.1 pt、π0-FAST が 64.8 pt、kNN(ResNet)が 13.2 pt、kNN(multimodal)が 9.3 pt です。
両方のベンチマークで成功率が最も高いのは π0.5 です。kNN 方策は LIBERO で π0-FAST と同程度で、SmolVLA と π0 を上回ります。VLA-JEPA、Evo-1、X-VLA は LIBERO ではいずれも 94% を超えますが、LIBERO-Plus では学習なしの ResNet 変種(75.5%)を下回ります。multimodal 変種は LIBERO-Plus で 9 つの VLA のうち 7 つを上回り、9.3 pt という低下幅は全方策の中で最小です。著者はこれを、LIBERO での高いスコアが LIBERO-Plus の摂動下での頑健さに必ずしもつながらないことを示すものと読んでいます。摂動の種類別に分けた付録 C には、もう 1 つ細かい結果があります。カメラの摂動ではすべての方策の成功率が下がりますが、LAC key 変種だけは例外で 88% に達し、他の方策は最高でも 73% でした。
この表を読むときの注意点が 2 つあります。1 つ目に、論文が区間を示しているのは LIBERO だけで、2000 エピソードでの 95% 信頼区間は約 ±1.2 pt です。LIBERO-Plus には区間がなく、読んだ本文には各バリアントを何回実行したかも書かれていません。各バリアントを 1 回ずつ実行したとすると、成功率 80% 前後で 420 回の 95% 区間の半幅は約 3.8 pt になります(本サイトによる二項分布での概算)。kNN(multimodal)と π0.5 の低下幅の差は 2.9 pt で、確定した順位として読むべきではありません。2 つ目に、π0 と SmolVLA の再現成績はそれぞれの著者が報告した値より低く、論文はこれを公開チェックポイントと元論文で使われたチェックポイントの違いによる可能性があるとしています。表の VLA の数値は「公開チェックポイントをそのまま実行した」結果で、各モデルの最高成績ではありません。
検索を支えるもの:アブレーション
著者は multimodal 変種の部品を 1 つずつ変えて比べています(付録の表 3、LIBERO 2000 エピソード)。
- お手本を 10% だけ残すと、成功率は 91.7% から 77.4% に下がります。25% と 50% では 82.6% と 88.5% です。
- ResNet-18 特徴の代わりに 16 × 16 の生ピクセルを使うと 57.2% になり、LIBERO-Object では 0.0% です。このスイートの 10 タスクは、小さな物体がいくつも置かれた 1 つの場面を共有しています。
- 言語指示を無視すると 27.1 pt 下がり、その大部分は LIBERO-Goal(8.8%)で起きます。Goal スイートの 10 タスクも 1 つの場面を共有しているため(付録 D)、主に指示で区別されます(本サイトの推論)。
- mode seeking、時間アンサンブル、履歴マッチング、ロボットの状態、時間ステップ特徴のどれを外しても、平均成功率の変化は最大 1 pt で、±1.2 pt の区間内に収まります。
- k が 4 から 32 の範囲では成功率は 89.4% から 92.7% の間にとどまり、k = 1、つまり最も近いお手本 1 件を再生するだけだと 78.6% に下がります。
著者のまとめでは、成績の大部分を決めるのは視覚表現、言語指示、お手本の数で、残りの工夫の寄与は小さいとしています。ハイパーパラメータの重要度分析(fANOVA)も同じ方向を示し、k と「お手本 1 件につき近傍は最大 1 件」という制約がそれぞれ 57% と 25% を占めます。
検索で VLA を測る
同じ検索の仕組みは、VLA そのものを調べるのにも使えます。著者は ResNet 変種の画像特徴を、ある VLA の VLM バックボーンの 1 つの層における画像トークンの隠れ状態に置き換え、LIBERO でのファインチューニング前後で、そのバックボーンを「検索キー」として使ったときの結果を比べています(論文の表 2)。
- ファインチューニング後に検索の成功率が上がったのは、ファインチューニングされた 8 つの VLA のうち LIBERO で 5 つ、LIBERO-Plus で 7 つで、上がり幅は 5 から 37 pt です。これらの VLA では、LIBERO から LIBERO-Plus への低下幅も、ファインチューニング前の 20.9〜34.7 pt から後の 10.4〜21.0 pt に縮みます。GR00T N1.7 は VLM を凍結しているため前後で同じで、この 8 つには含まれません。
- この効果は一様ではありません。π0 のバックボーンはファインチューニング後、LIBERO での検索成功率が 86.9% から 17.9% に落ちます(LIBERO-Plus では 56.7% から 2.4%)。t-SNE の図では、その検索キーがタスクごとに 1 つの塊につぶれています。最近傍は同じタスクのままですが、あるフレームと、同じタスクの別のお手本で最も近いフレームとの進捗の差の中央値は 0.028 から 0.052 に広がります。
- 一部のモデルでは、ファインチューニング後のバックボーンだけで検索したほうが VLA 全体より成績が上です。LIBERO では 9 つのうち 2 つ、LIBERO-Plus では 4 つで、差は最大 48 pt です。たとえば π0-FAST のバックボーンによる検索は LIBERO-Plus で 74.0% ですが、モデル全体では 25.7% です。著者は、これらのモデルの動作ヘッドがバックボーンにある動作関連の情報を使い切っていないことを示唆すると見ています。
著者はさらに、各 VLA が自身の LIBERO ロールアウトで出力した動作チャンクと、kNN の予測(同じタスクで最も近い 8 つのお手本フレームのチャンクの重み付き平均)を比べています。参照として、この kNN 予測と取り置いた正解チャンクの R² は 0.78 です。VLA のチャンクと kNN 予測の R² は 0.63 から 0.93 で、8 つの VLA のうち 5 つは、kNN 予測との一致度が正解チャンクの一致度(R² = 0.78)より高くなっています。すべての VLA で、同じタスクの最も近い学習用チャンクとの二乗誤差の中央値は、取り置いた正解チャンクの値の 0.62〜0.99 倍です。X-VLA は絶対姿勢を予測するため、この比較から除かれています。著者の表現では、これらの結果は、LIBERO では VLA の動作がお手本の動作の近くにとどまっていることを示唆しています。
付録 D には、指示を無視したアブレーションと対応する観察もあります。LIBERO-Goal で 10 タスクをはっきり分けられるのは、画像トークンが指示に注意を向けられる表現だけです。π0、π0.5、π0-FAST が使う PaliGemma の双方向プレフィックス注意と、X-VLA の Florence-2 エンコーダーがこれに当たり、同じタスクの最近傍の割合は 96〜100% です。画像トークンが指示より前に並ぶ因果的注意の VLM は 76〜82% にとどまり、ResNet-18 は 79% です。
LAC:ロールアウトなしで検索キーを評価する
検索キーを 1 つ閉ループで評価するには数千エピソードが必要です。著者はオフラインの推定として局所動作一貫性(Local Action Consistency、LAC)を提案しています。取り置いた各クエリフレームについて、表現空間での k 個の最近傍の将来の動作チャンクが自身のチャンクにどれだけ近いかを求め、それを同じタスクの全エントリとの平均的な動作の差で割り、1 からその比を引きます。値が高いほど、表現空間で近いフレームの後には似た動作が続くことを意味します。論文は LAC@8 を報告しています。
結果は 3 点にまとめられます。取り置いたお手本で学習済みのファインチューニング後 VLM バックボーンを除くと、LAC と閉ループでの検索成功率の Pearson r は 0.78 ですが、Spearman ρ は 0.61 にとどまり、質の近いキー同士の順位は確実には付けられません。劣化した π0 のファインチューニング後バックボーンは検出でき、その値は 0.55 で、他のキーは 0.76〜0.88 です。LAC の微分可能な代替で ResNet 特徴上の線形射影を学習すると、通常の kNN 検索の成功率は 88.7% から 93.0% に上がります。これが表の LAC key 変種です。
VLA の評価表を読むうえでの意味
著者は結論で、ベンチマークでの記憶と汎化を区別するため、検索ベースラインを VLA の成績と並べて報告するよう提案しています。学習なしの 2 変種は LIBERO で 88.7% と 91.7% です。本サイトの読み方では、ある VLA の LIBERO のスコアがこの参照線を数ポイント上回る程度なら、そのスコアだけでお手本を超えた汎化を示すのは難しいと考えます。フィジカルAIラボ 1.6 では、模倣学習の誤差がロボットをお手本のカバー範囲の外へ連れ出す仕組みを扱いました。この論文はその反対側を補います。著者は、LIBERO のようにお手本が密なベンチマークでは、テスト時の状態をお手本の状態に照合してその動作を再利用するだけで、成功した振る舞いの大部分を再現できると述べています。対応表と乱数シードを使って 2 つの成功率の差を判断する方法は フィジカルAIラボ 1.8 を参照してください。
本サイトで以前紹介した 2 本の論文も関係します。RESETTLE は、凍結した方策のサンプルが食い違い続けたときに同じタスクのお手本フレームを検索して補正するもので、検索を方策の補助として使います。本論文は検索そのものを方策として、また測定の道具として使っています。Is Success All You Need? は同じく LIBERO-Plus の摂動ベンチマークを使い、成功軌道の実行品質だけを見ています。本論文の数値はタスク成功率で、軌道の品質には触れていません。
結果を確かめたい読者には 2 つの手がかりがあります。付録の表 4 には各 VLA チェックポイントの Hugging Face リポジトリとコミットが載っています(たとえば π0.5 は lerobot/pi05_libero_finetuned_v044、リビジョン 8e174154)。また著者は、評価とソースコードを github.com/sereact/lerobot_knn で公開しているとしています。本サイトはこのリポジトリを開いても実行してもいません。
制約と注意点
- arXiv のプレプリントで、数値はすべて著者報告 [R] です。本サイトは再現しておらず、著者が公開したコードも実行していません。
- 結論は LIBERO と関連ベンチマークに限られます。著者は、これらのベンチマークはお手本のカバーが比較的密で検索手法に有利かもしれないこと、また LIBERO-Plus の摂動は元のタスクと解の軌道をおおむね保つため、ここでの頑健性は主に観測と指示の変化に対するもので、新しい軌道が必要な状況は扱っていないことを指摘しています。
- 著者は、検索は記憶のカバー範囲の外へは外挿できず、これらのベンチマークでの好成績を kNN 方策がロボットの問題全般に広く汎化する証拠と解釈すべきではないと明記しています。
- 9 つの VLA はすべて公開チェックポイントをそのまま実行したもので、一部は元論文の報告値を下回っています(特に π0 と SmolVLA)。
- kNN のハイパーパラメータ探索には公式評価の初期状態 40〜49 を使っています。著者による 0〜39 での確認(91.6% 対 91.7%)では影響は小さいとされています。LIBERO-Plus には区間が示されていないため、低下幅の数ポイントの差は慎重に読む必要があります。
- 結果はすべてシミュレーションでのタスク成功率で、実機やハードウェアの安全性の検証ではありません。
リンク
- How Much of Your VLA Is kNN(arXiv 2611.13160)
- 論文の HTML 全文
- フィジカルAIラボ 1.6:模倣学習――誤差がお手本のカバー範囲からはみ出すまでを手で計算し、ACT・拡散方策・データのスケーリング則の数字をそれぞれの条件に照らして読む
- フィジカルAIラボ 1.8:評価――「差し引き +2」を対応表に分解し、失敗ラベルと乱数シードを計算で確かめる
- フロンティア・レーダー|RESETTLE:凍結した方策の 2 つの動作サンプルが食い違い続けたときだけ介入し、デモを参照して補正動作を 1 回だけ実行する
- フロンティア・レーダー|Is Success All You Need?:成功率が同程度の 2 つの VLA でも、成功軌道は大きく違いうる


