
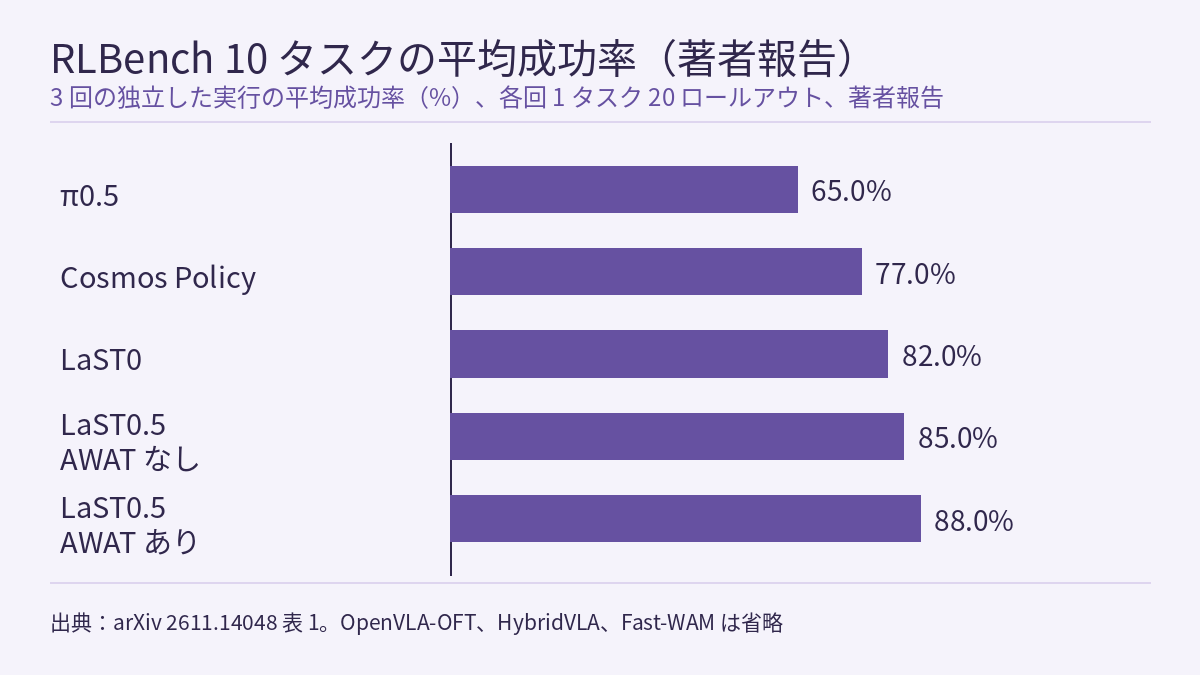
プレプリント LaST0.5(arXiv 2611.14048、2026-11-10。著者の所属は北京大学計算機学院のマルチメディア情報処理国家重点実験室、香港中文大学、Simplexity Robotics)は世界行動モデル(WAM)です。動画の世界モデルと動作生成の間に、インタラクションを中心とする潜在変数の層を加え、エンドエフェクタの軌跡と対象物体の枠を描き込んだ未来フレームでこの層を教師付けします。推論時には、世界モデルが予測した未来の各区間にタスク進捗の値を付け、進捗が上がらなくなった時点で残りの動作を止めて観測し直します。著者は LIBERO の平均成功率 99.5%、RLBench の 10 タスクで 88.0%、実機の双腕 4 タスクで平均 63.8%(π0.5 は 52.5%)を報告しています。本記事では、この 2 つの設計と対応するアブレーションを整理し、論文が示す評価回数から各差の大きさを見積もります。以下の数値はすべて著者報告 [R] で、本サイトは再現しておらず、モデルも動かしていません。
著者が埋めようとする隙間:シーン全体の表現と局所的なインタラクション
著者は既存の WAM を 2 種類に分けます。Imagine-then-Execute は先に未来フレームを予測し、逆動力学で動作を求めます。Joint Modeling は未来フレームと動作を同時に予測します。論文によれば、どちらも「世界の変化を予測するよう最適化された表現は、そのまま動作生成に向いている」と前提しています。著者の見方では、全体を予測する目的関数はロボットと物体の細かなインタラクションを軽く扱いがちなので、世界の表現と動作の間にインタラクション専用の抽象を置きます。これは論文の動機づけの議論で、その裏付けとして示されるのは後のアブレーションとアテンションマップです。
本サイトで以前紹介した Forward Dynamics Models は別の道をとります。未来予測が動作特徴を読み、動作は未来を読まず、推論時には未来生成を省きます。LaST0.5 は推論時にも未来を予測し、動作は潜在変数を通じてそれを読みます。WAM の事前学習データの組み立て方は昨日の SWAM の記事で、世界モデルが何を条件に何を出力するかは講座の フィジカルAIラボ 3.2 で扱いました。
3 つのエキスパートと一方向のアテンションの流れ
LaST0.5 は世界エキスパート、潜在エキスパート、動作エキスパートを Mixture-of-Transformers(MoT)構造に置きます。3 つは 1 本のグローバルなアテンションの流れを共有し、重みはそれぞれ独立です。論文は同時分布を、まず未来の動画を予測し、次に動画からインタラクションの潜在変数を、最後に両者から動作を生成する形に分解しています。
- 世界エキスパート:事前学習済みの拡散 transformer、Cosmos-Predict2.5-2B で実装します。256×256 のメインカメラ映像の履歴 5 フレームを因果的な動画トークナイザで潜在コンテキストに圧縮し、指示はクロスアテンションで注入します。出力はデノイズで得る 12 フレームの未来です。付録によれば、履歴 5 フレームは 2 つ、未来 12 フレームは 3 つの潜在フレームに圧縮され、各潜在フレームは 256 トークンです。学習には Cosmos 本来の生成目的関数をそのまま使います。
- 潜在エキスパート:統合型マルチモーダルモデル Janus から初期化します。学習可能な少数のクエリトークンが世界エキスパートの未来表現を読み、1 回の並列フォワードで M 個のインタラクション潜在トークンを出力します。既定値は M = 3 です。
- 動作エキスパート:潜在エキスパートと同じ言語バックボーンから初期化しますが、パラメータは別で、flow matching で動作チャンク全体をまとめて洗練します。各時間ステップに 2 つのノイズトークンと対応する MLP ヘッドがあり、手首の動きとアクチュエータ指令をそれぞれ予測します。次元は各身体の最大値にそろえ、足りない次元はゼロで埋めます。各腕の動作は相対的な 6 自由度のエンドエフェクタ姿勢と、身体ごとのアクチュエータ指令(二値のグリッパ状態や多指ハンドの構成など)です。
12 ステップの予測範囲は 3 区間に分かれ、各区間が未来 4 フレーム、潜在トークン 1 個、動作 4 ステップに対応します。ブロック単位の因果マスクにより、第 i 区間の潜在変数と動作は、第 1〜i 区間の世界と潜在変数にだけ直接アテンションできます。世界エキスパートの key と value は detach され、潜在エキスパートと動作エキスパートからの勾配は世界エキスパートに戻りません。著者はこれを事前学習済みの物理的な事前知識を守るためと説明しています。付録はさらに、世界エキスパートの内部では双方向アテンションが残るため、後の区間の世界予測が前の区間の表現に間接的に影響しうると述べています。つまりこのマスクが制限するのはエキスパート間の直接の条件付けで、厳密な時間的分離は保証しません。
潜在変数の学習目標:未来フレームに軌跡と枠を描く
教師信号の作り方は、この論文で最も具体的な部分です。各区間の最後のフレームに 2 種類の視覚的な手がかりを重ねます。1 つは 2D の曲線で、デモの 3D エンドエフェクタ軌跡をカメラパラメータで画像平面に投影したものです。もう 1 つは枠で、Grounding DINO がタスク指示から候補の物体枠を出し、グリッパの開閉時点で投影したツール中心点(TCP)と空間的に照合してインタラクションの対象を選び、その物体を直前の動作区間に割り当てます。この注釈は学習データの準備段階でオフラインに行い、推論時には不要です。
手がかりを描いたフレームは凍結した SigLIP でパッチトークンに変換され、学習可能な MLP が 1 × d_v のベクトル 1 本に集約し、射影と正規化を経て 3 個の潜在ターゲットになります。潜在エキスパートの出力とターゲットは、コサイン類似度の損失でそろえます。全体の損失は世界・潜在・動作の 3 つの損失の重み付き和で、係数は数値のスケールをそろえるためだけに使います。
アブレーションは LIBERO-Spatial で行い、基準は AWAT なしの LaST0.5(成功率 99.6%)です。
| 変種 | LIBERO-Spatial の成功率 |
|---|---|
| 基準(LaST0.5、AWAT なし) | 99.6% |
| 世界エキスパートを除去 | 96.0% |
| 潜在エキスパートを除去 | 97.8% |
| 手がかりを描かない未来フレームを潜在ターゲットに使用 | 98.6% |
| 軌跡の曲線を除去 | 99.0% |
| 対象の枠を除去 | 99.0% |
向きは著者の議論と一致しますが、どの差も LIBERO-Spatial の満点近くの範囲にあり、最小の差は 0.6 ポイントです。本サイトが読んだ本文には、このアブレーションの評価エピソード数も乱数シード数も書かれていないため、0.6〜1.0 ポイントの差が評価のばらつきを超えるかどうかは判断できません。
AWAT:予測した進捗で、動作チャンクのどこまでを実行するか決める
著者は、世界エキスパートが予測する未来は範囲全体で一様に信頼できるわけではないと述べ、LIBERO で世界モデルが失敗した把持を生成し、ボウルがテーブルに残ったままになる例を挙げています。Adaptive World-to-Action Transfer(AWAT)の手順は次のとおりです。
- 同時学習の後にベースモデルを凍結し、世界エキスパートがデノイズした未来フレームの特徴に軽量な MLP の価値ヘッドを付けます。4 フレームの各区間は動画トークナイザで 1 つの潜在フレームに圧縮され、価値ヘッドは対応する DiT の隠れトークンをプーリングして進捗値を 1 つ回帰します。
- 進捗の目標値は t_i / T です。t_i はその区間の 4 フレームの環境タイムステップの中央値、T はエピソード全体の長さです。デモの進捗はほぼ単調に増えるため、著者は学習クリップの一部を時間反転したりフレームを繰り返したりし、ラベルも減少または一定に変えて、価値ヘッドが停滞や後退を学べるようにしています。
- 実行時は、次の区間の進捗値が前の区間より高い限り、その区間の動作を実行します。値が下がった時点で止め、新しいカメラ観測を取得して推論し直します。
- 最初の区間の進捗値がすでに前のサイクルの進捗推定より低ければ、その予測全体を信頼できないとみなします。このときモデルは複数の世界の未来を並列にサンプリングし、価値が最も高いものを選んで、その KV キャッシュを潜在エキスパートと動作エキスパートに渡します。
付録 A.3 によれば、推論時の世界エキスパートはデノイズを 2 ステップだけ行って KV をキャッシュし、動作エキスパートは 24 個の連続動作トークンに既定で 10 ステップの反復デノイズを行います。進捗値の粒度もアブレーションされています(LIBERO-Spatial、AWAT あり)。固定の 12 ステップの範囲で 1、2、4、12 ステップごとに進捗値を 1 つ付けた場合、成功率は 98.9%、99.3%、99.7%(既定の 4 ステップ)、98.2% でした。著者は、ステップごとの推定は高周波のゆらぎを生み、範囲全体で 1 回だけの推定では打ち切りに必要な時間分解能が足りないと説明しています。
本サイトでは近い発想を 2 つ紹介しました。PAV は VLA 自身の表現空間で各動作プレフィックスの結果を予測し、スコアでチャンクをどこまで実行するかを決めます。VeriVLA は JEPA の潜在世界モデルで、予測した進捗の増分により 10 個の候補動作チャンクから 1 つを選びます。LaST0.5 の進捗値は自身の世界エキスパートの特徴から直接得られ、動作区間と 1 対 1 で対応し、再サンプリングは最初の区間の進捗が前のサイクルより低いときだけ起こります。チャンク長と制御周波数・遅延の関係は フィジカルAIラボ 2.6 で扱っています。
結果と、各差の大きさ
| 評価 | LaST0.5 | AWAT なし | 主な比較手法 | 評価方法 |
|---|---|---|---|---|
| LIBERO 4 スイートの平均 | 99.5% | 99.2% | InternVLA 98.9%、Cosmos Policy 98.5% | 学習中に得られた最高の成功率 |
| RLBench 10 タスクの平均 | 88.0% ± 3.0 | 85.0% ± 2.0 | LaST0 82.0% ± 3.0、Cosmos Policy 77.0% ± 2.0、π0.5 65.0% ± 4.0 | 3 回の独立した実行の平均 ± 標準偏差、各回 1 タスクあたり 20 ロールアウト |
| 実機 4 タスクの平均 | 63.8% | 報告なし | π0.5 52.5%、Cosmos Policy 43.8%、LaST0 43.8% | 1 タスクあたり 20 ロールアウト、タスク全体の完了で集計 |
LIBERO:4 スイートは Spatial 99.7%、Object 100.0%、Goal 99.1%、Long 99.3% で、表中で最も高いベースラインの InternVLA を 0.6 ポイント上回ります。論文は LIBERO の値を学習中に得られた最高の成功率と明記しています。評価結果でチェックポイントを選んでいることになり、数値は楽観的です。本サイトが読んだ本文には LIBERO の評価エピソード数がありません。
RLBench:CoppeliaSim のシミュレーション上の Franka Panda で 10 タスクを選び、正面の RGB カメラ 1 台、1 タスクあたり 100 件のデモ、300 エポックで学習しています。ベースラインはそれぞれの公式の事前学習チェックポイントから、各論文の推奨ハイパーパラメータでファインチューニングしました。AWAT による上積みは 3.0 ポイントで、3 回の実行間の標準偏差は 2.0〜3.0 なので、この差は実行間のばらつきと同程度です。論文は区間も検定も示していません。LaST0.5 がすべてのタスクで最高というわけでもありません。Toilet Seat Down は 95.0% で、HybridVLA、Cosmos Policy、LaST0 はいずれも 100.0% です。Sweep to Dustpan は 80.0% で HybridVLA は 90.0%、Wine at Rack は 80.0% で LaST0 は 85.0% です。
実機:プラットフォームは双腕の Tianji Marvin で、頭部カメラ 1 台と手首カメラ 2 台を使います。4 タスクは袋の引き出し、物品の整理、ねじ締め、小包の箱詰めで、それぞれ PICO VR 遠隔操作で 150 件のデモを集めました。すべての方策を同じデモと同じマルチビュー入力で学習し、各タスクを物体の初期姿勢と配置を変えて 20 回実行しています。ねじ締めの挿入段階では LaST0.5 が 50.0%、π0.5 が 30.0%、箱詰めの最後の封かん段階では 30.0% 対 20.0% です。
以下は論文の回数をもとにした本サイトの見積もりで、論文の数値ではありません。4 タスク × 20 回で計 80 回なので、63.8% と 52.5% はそれぞれ 51/80 と 42/80 回のタスク完了に当たります。2 群を独立な標本とみなすと、差の 95% Wald 区間の半幅は約 15 ポイントで、11.3 ポイントのリードより大きくなります。1 タスクは 20 回しかなく、50% 付近では 1 群の半幅が約 22 ポイントです。挿入段階の 50.0% 対 30.0% は 10/20 対 6/20 です。各モデルが同じ初期配置を共有したかは論文に書かれていないため、対応のある比較はできません。区間の手計算は フィジカルAIラボ 2.8 で解説しています。
分布外テストは袋の引き出しと物品の整理の 2 タスクだけで、物体の位置、物体そのもの、背景をそれぞれ変えています。2 タスクの平均で、位置を変えたときの LaST0.5 は 40.0%、π0.5 は 15.0%、Cosmos Policy は 17.5% です。物体を変えたときは 55.0% で π0.5 と同じ、背景を変えたときは 72.5% で π0.5 は 67.5% です。袋の引き出しで物体を変えた場合は、π0.5 の 60.0% が LaST0.5 の 45.0% を上回ります。本サイトが読んだ本文には、このテストの各セルの試行回数が書かれていません。
制約と注意点
- arXiv のプレプリントで、数値はすべて著者報告 [R] です。本サイトは再現していません。本サイトが読んだ本文と付録の前半には、コードやモデル重みの公開についての記述がありません。
- LIBERO は学習中の最高成功率です。構造と潜在ターゲットのアブレーションは満点近くの LIBERO-Spatial で行われ、変種ごとに数値が 1 つで、エピソード数やシード数はありません。実行間の標準偏差が報告されているのは RLBench だけです。
- 事前学習コーパスは 14k 時間を超え、遠隔操作のデモ、UMI のようなハンドヘルドグリッパで集めたデータ、人の一人称データを含みます。詳しい内訳は付録 B.1 にあり、本サイトが読んだ資料には含まれていません。インタラクションの手がかりには 3D のエンドエフェクタ軌跡とカメラパラメータが必要ですが、人の一人称データでこれらをどう得るかは、読んだ本文に説明がありません。
- AWAT は動作チャンクを早めに打ち切り、必要なら複数の未来を並列にサンプリングするため、推論の回数が変わります。読んだ本文には推論遅延、再サンプリングの頻度、計算コストの報告がありません。学習には NVIDIA H20 を 8 基使っています。
- 実機評価は双腕プラットフォーム 1 台、4 タスク、各 20 回です。著者の言うゼロショット汎化は 2 タスクの結果にもとづきます。シミュレーションや実験室の実機での成功率は、ハードウェアの安全性検証ではありません。
リンク
- LaST0.5: A Generalist World Action Model with Interaction-Centric Latent Reasoning(arXiv 2611.14048)
- 論文の HTML 版全文
- フィジカルAIラボ 3.2:世界モデル――Cosmos でデータをつくる。生成ごとの条件を書き出し、78.3% を人の評価に戻し、生成データの受け入れ基準を決める
- フィジカルAIラボ 2.6:エッジへ――遅延のログから制御周波数の上限を求め、量子化で減るのが容量か時間かを見分け、動作チャンクの長さを決める
- フィジカルAIラボ 2.8:再現できる評価――Wald 区間と Wilson 区間を手で計算し、1/√n から評価回数を決め、失敗ゼロのあとの失敗率の上限を求める
- フロンティア・レーダー|PAV:VLA 自身の表現空間で各動作プレフィックスの結果を予測し、動作チャンクをどこまで実行するかを決める
- フロンティア・レーダー|VeriVLA:2 つのサンプルで追加計算の要否を判断し、潜在世界モデルが予測進捗で 10 個の候補動作チャンクから 1 つを選ぶ
- フロンティア・レーダー|Forward Dynamics Models:未来予測が動作特徴を読み、動作は未来を読まない――推論時は未来生成を省略する
- フロンティア・レーダー|SWAM:47,000 時間の動画とデモを世界行動モデルにどう与えるか――キャプションの詳しさ、UMI の動作ラベル、データ混合比を一つずつ検証
- フィジカルAIラボ:すべての数字を確認できるフィジカルAI講座(講座の概要)


