
预印本 LaST0.5(arXiv 2611.14048,2026-11-10,作者来自北京大学计算机学院多媒体信息处理全国重点实验室、香港中文大学和 Simplexity Robotics)是一个世界动作模型(WAM)。它在视频世界模型和动作生成之间加了一层以交互为中心的潜变量,用画上末端轨迹和目标物体框的未来帧来监督这层潜变量;推理时,世界模型还给每段预测的未来打一个任务进度值,进度不再上升,就停下剩余动作、重新观测。作者报告 LIBERO 平均成功率 99.5%、RLBench 十项任务 88.0%、四项真机双臂任务平均 63.8%(π0.5 为 52.5%)。本文整理这两处设计和对应的消融,并按论文给出的评测次数估算各个差距的大小。以下数字均为作者报告 [R],本站没有复现,也没有运行这个模型。
作者要补的一段:全局场景表征与局部交互
作者把现有 WAM 分成两类:先想象再执行(Imagine-then-Execute),即先预测未来画面,再用逆动力学推出动作;联合建模(Joint Modeling),即同时预测未来画面和动作。论文认为两类都默认了一件事:为预测世界演化而优化的表征,天然适合生成动作。作者的看法是,全局预测目标可能低估精细的机器人–物体交互,所以在世界表征和动作之间加一层专门描述交互的抽象。这是论文的动机论证,支撑它的证据是后文的消融和注意力图。
本站此前介绍的 Forward Dynamics Models 走的是另一条路:未来预测读取动作特征,动作不读未来,推理时跳过未来生成。LaST0.5 保留推理时的未来预测,并让动作经由潜变量去读它。WAM 预训练数据怎样组织,见昨天的 SWAM;世界模型本身以什么为条件、输出什么,课程 物理AI实验室 3.2 讲过。
三个专家,一条单向的注意力流
LaST0.5 把世界专家、潜变量专家和动作专家放进一个 Mixture-of-Transformers(MoT)结构:三者共享一条全局注意力流,权重各自独立。论文把联合分布分解为先预测未来视频,再由视频推出交互潜变量,最后由两者生成动作。
- 世界专家:用预训练扩散 transformer Cosmos-Predict2.5-2B 实例化。输入 5 帧 256×256 的主视角历史画面,由因果视频分词器压成潜上下文,指令经交叉注意力注入;输出是去噪得到的 12 帧未来画面。附录写明,5 帧历史压成 2 个潜帧,12 帧未来压成 3 个潜帧,每个潜帧 256 个 token。训练沿用 Cosmos 原有的生成目标。
- 潜变量专家:从统一多模态模型 Janus 初始化。一小组可学习的查询 token 读取世界专家给出的未来表征,一次并行前向输出 M 个交互潜 token,默认 M = 3。
- 动作专家:与潜变量专家用同一个语言骨干初始化,但参数独立,用 flow matching 一起精修整个动作块。每个时间步有两个噪声 token 和对应的 MLP 头,分别预测腕部运动和执行器指令;维度取各本体的最大值,缺的维度补零。每只手臂的动作是相对的 6 自由度末端位姿,加上本体专属的执行器指令,例如二值夹爪状态或多指手构型。
12 步预测视野被切成 3 段,每段对应 4 帧未来画面、1 个潜 token 和 4 步动作。块状因果掩码规定:第 i 段的潜变量和动作只能直接关注第 1 到 i 段的世界与潜变量。世界专家的 key 和 value 被 detach,潜变量专家和动作专家的梯度不回传给它,作者说这是为了保护预训练的物理先验。附录还补了一句:世界专家内部保留双向注意力,后段的世界预测仍可间接影响前段表征,所以这个掩码限制的是直接的跨专家条件,不保证严格的时间隔离。
潜变量的训练目标:在未来帧上画轨迹和框
监督目标的构造是这篇论文最具体的部分。每段取最后一帧,叠加两种视觉线索:一条 2D 曲线,由示范中的 3D 末端轨迹按相机参数投影到图像平面得到;一个框,先由 Grounding DINO 按任务指令给出候选物体框,再在夹爪开合时刻与投影的工具中心点(TCP)做空间匹配,选出交互目标,并把它归给前一段运动。这些标注在准备训练数据时离线完成,推理时不需要。
画好线索的帧经冻结的 SigLIP 编码成 patch token,再由一个可训练的 MLP 聚合成一个 1 × d_v 的向量,投影、归一化后得到 3 个潜目标。潜变量专家的输出与目标之间用余弦相似度损失对齐。总损失是世界、潜变量、动作三项损失的加权和,系数只用来平衡数值尺度。
消融在 LIBERO-Spatial 上完成,基线是不带 AWAT 的 LaST0.5,成功率 99.6%:
| 变体 | LIBERO-Spatial 成功率 |
|---|---|
| 基线(LaST0.5,不带 AWAT) | 99.6% |
| 去掉世界专家 | 96.0% |
| 去掉潜变量专家 | 97.8% |
| 潜目标用不加线索的未来帧 | 98.6% |
| 去掉轨迹曲线 | 99.0% |
| 去掉目标框 | 99.0% |
方向与作者的论证一致,但所有差距都在 LIBERO-Spatial 接近满分的区间里,最小的只有 0.6 个百分点。本站读到的正文没有给出这组消融的评测回合数或随机种子数,因此无法判断 0.6 到 1.0 个百分点的差是否超出评测波动。
AWAT:用预测进度决定一个动作块执行到哪一段
作者认为世界专家预测的未来并非整段都可靠,举的例子是 LIBERO 中世界模型生成了一次失败的抓取,碗仍留在桌上。自适应世界到动作迁移(AWAT)的做法如下:
- 联合训练结束后冻结基础模型,在世界专家去噪后的未来帧特征上接一个轻量 MLP 价值头。每段 4 帧被视频分词器压成一个潜帧,价值头把对应的 DiT 隐 token 池化后回归出一个进度值。
- 进度目标是 t_i / T:t_i 是该段四帧的环境时间步中位数,T 是整个回合的长度。示范里的进度几乎单调上升,作者因此把一部分训练片段时间倒放或重复若干帧,标签相应改为下降或不变,让价值头见过停滞和倒退。
- 执行时,只要后一段的进度值高于前一段,就继续执行这一段对应的动作;一旦下降,立即停止,取新的相机观测重新推理。
- 如果第一段的进度值已经低于上一轮的进度估计,整次预测被视为不可靠:模型并行采样多个世界未来,选价值最高的一个,把它的 KV cache 交给潜变量专家和动作专家。
附录 A.3 写明,推理时世界专家只做两步去噪并缓存 KV,动作专家对 24 个连续动作 token 做默认 10 步的迭代去噪。进度值的粒度也做了消融(LIBERO-Spatial,开启 AWAT):在固定 12 步视野内,每 1、2、4、12 步给一个进度值,成功率分别为 98.9%、99.3%、99.7%(默认的 4 步)和 98.2%。作者的解释是逐步估计带来高频波动,整段只估一次则时间分辨率不够。
站内已有两种相近思路。PAV 在 VLA 自己的表征空间里预测各个动作前缀的后果,打分后决定动作块执行多长;VeriVLA 用 JEPA 潜世界模型按预测进度增量从 10 个候选动作块中选一个。LaST0.5 的进度值直接取自自身世界专家的特征,与动作段一一对齐,重采样只在首段进度低于上一轮时触发。动作块长度与控制频率、时延之间怎样取舍,见 物理AI实验室 2.6。
结果,以及各个差距有多大
| 评测 | LaST0.5 | 不带 AWAT | 部分对比方法 | 评测方式 |
|---|---|---|---|---|
| LIBERO 四个套件平均 | 99.5% | 99.2% | InternVLA 98.9%,Cosmos Policy 98.5% | 训练过程中取得的最好成功率 |
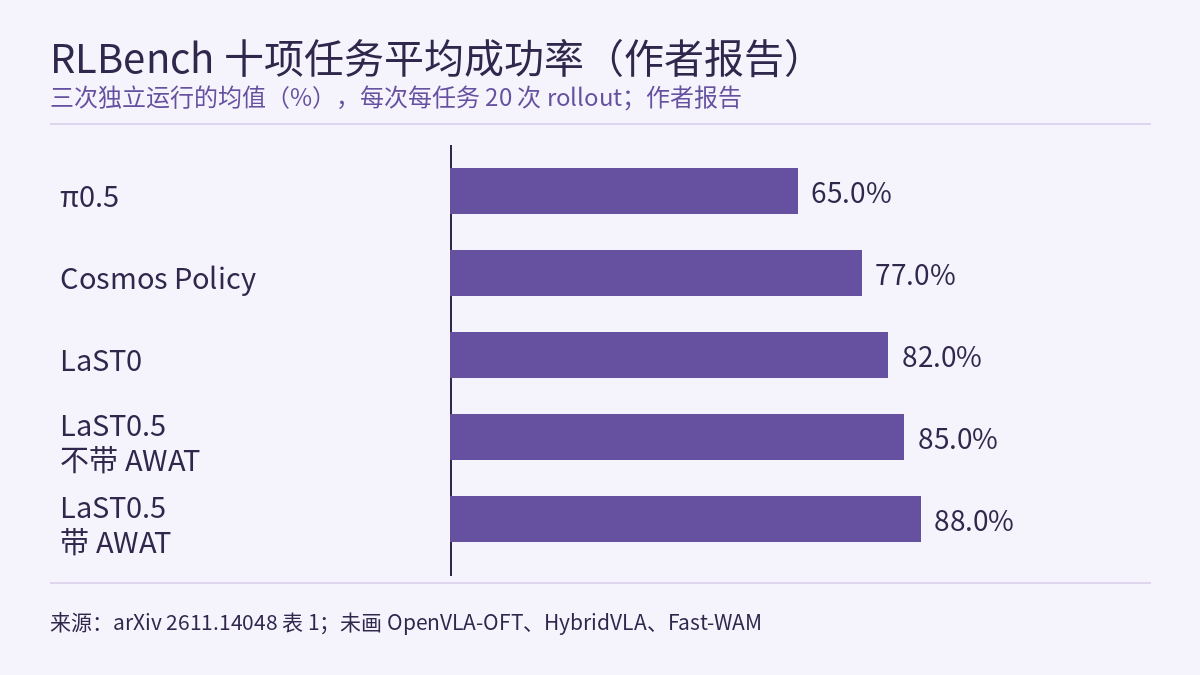
| RLBench 十项任务平均 | 88.0% ± 3.0 | 85.0% ± 2.0 | LaST0 82.0% ± 3.0,Cosmos Policy 77.0% ± 2.0,π0.5 65.0% ± 4.0 | 3 次独立运行的均值 ± 标准差,每次每任务 20 次 rollout |
| 真机四项任务平均 | 63.8% | 未报告 | π0.5 52.5%,Cosmos Policy 43.8%,LaST0 43.8% | 每项任务 20 次 rollout,按整任务完成计 |
LIBERO:四个套件为 Spatial 99.7%、Object 100.0%、Goal 99.1%、Long 99.3%,比表中最高的基线 InternVLA 高 0.6 个百分点。论文写明 LIBERO 报告的是训练过程中取得的最好成功率,也就是在评测结果上挑检查点,数字偏乐观;本站读到的正文没有给出 LIBERO 的评测回合数。
RLBench:在 CoppeliaSim 的模拟 Franka Panda 上选了 10 项任务,单个前视 RGB 视角,每项任务 100 条示范,训练 300 个 epoch;基线从各自官方预训练检查点出发,按其论文推荐的超参数微调。AWAT 带来的提升是 3.0 个百分点,而三次运行的标准差在 2.0 到 3.0 之间,这个差距与运行间的波动同一量级;论文没有给出区间或检验。LaST0.5 也不是每项任务都最高:Toilet Seat Down 为 95.0%,HybridVLA、Cosmos Policy 和 LaST0 都是 100.0%;Sweep to Dustpan 为 80.0%,HybridVLA 为 90.0%;Wine at Rack 为 80.0%,LaST0 为 85.0%。
真机:平台是双臂 Tianji Marvin,用一个头部视角和两个腕部视角。四项任务为拉袋子、整理物品、拧螺丝和包裹装箱,每项用 PICO VR 遥操作采集 150 条示范;所有策略用同一份示范数据和相同的多视角输入训练,每项任务在不同的初始物体位姿和摆放下跑 20 次。拧螺丝的插入阶段 LaST0.5 为 50.0%,π0.5 为 30.0%;装箱的最后封箱阶段为 30.0% 对 20.0%。
以下是本站按论文给出的次数做的估算,不是论文的数字。四项任务各 20 次,共 80 次,63.8% 和 52.5% 分别对应 51/80 和 42/80 次整任务成功。把两组当作独立样本,差值的 95% Wald 区间半宽约 15 个百分点,大于 11.3 个百分点的领先;单项任务只有 20 次,50% 附近的单组半宽约 22 个百分点,插入阶段的 50.0% 对 30.0% 即 10/20 对 6/20。论文没有说明各模型是否共用同一批初始摆放,因此无法做配对比较。区间的手算方法见 物理AI实验室 2.8。
分布外测试只在拉袋子和整理物品两项任务上做,分别改变物体位置、物体实例和背景。两项平均下,位置变化时 LaST0.5 为 40.0%,π0.5 为 15.0%,Cosmos Policy 为 17.5%;换物体时 55.0%,与 π0.5 持平;换背景时 72.5%,π0.5 为 67.5%。拉袋子换物体时,π0.5 的 60.0% 高于 LaST0.5 的 45.0%。本站读到的正文没有写明这组测试每格的试验次数。
局限 / 注意
- 这是 arXiv 预印本,全部数字为作者报告 [R],本站没有复现。本站所读的正文和附录前段没有提到代码或模型权重的发布。
- LIBERO 取训练过程中的最好成功率;结构与潜目标的消融都在接近满分的 LIBERO-Spatial 上做,每个变体一个数字,没有回合数或种子数。RLBench 是唯一给出运行间标准差的结果。
- 预训练语料超过 14k 小时,包括遥操作示范、UMI 这类手持夹爪采集的数据和人类第一视角数据,具体构成在附录 B.1,本站读到的材料没有包含这部分。交互线索需要 3D 末端轨迹和相机参数,所读正文没有说明人类第一视角数据怎样得到这两样东西。
- AWAT 会提前截断动作块、必要时并行采样多个未来,推理调用次数随之变化;所读正文没有报告推理时延、重采样的触发频率或计算开销。训练在 8 张 NVIDIA H20 上完成。
- 真机只有一个双臂平台、四项任务,每项 20 次;作者所说的零样本泛化来自两项任务。仿真和实验室真机的成功率都不是硬件安全验证。
链接
- LaST0.5: A Generalist World Action Model with Interaction-Centric Latent Reasoning(arXiv 2611.14048)
- 论文 HTML 全文
- 物理AI实验室 3.2:世界模型,用 Cosmos 造数据,写清每种生成以什么为条件,把 78.3% 放回人类评审,再给生成数据定验收规则
- 物理AI实验室 2.6:上边缘,从时延日志算出控制频率上限,分清量化省下的是体积还是时间,再给动作块定长度
- 物理AI实验室 2.8:可复现评测,手算 Wald 与 Wilson 区间,从 1/√n 定评测次数,再给零失败算出失败率上界
- 前沿雷达|PAV:先在 VLA 自己的表征空间预测每个动作前缀的后果,再决定一个动作块执行多长
- 前沿雷达|VeriVLA:两次采样判断何时值得多算,再用潜世界模型按预测进度从 10 个候选动作块中选一
- 前沿雷达|Forward Dynamics Models:未来预测读取动作特征、动作不读未来,推理时跳过未来生成
- 前沿雷达|SWAM:4.7 万小时视频与示范怎样喂给世界动作模型,作者逐项消融了标注细度、UMI 动作标签和数据配比
- 物理AI实验室:一套每个数字都能核对的物理 AI 课程(课程大纲)


