
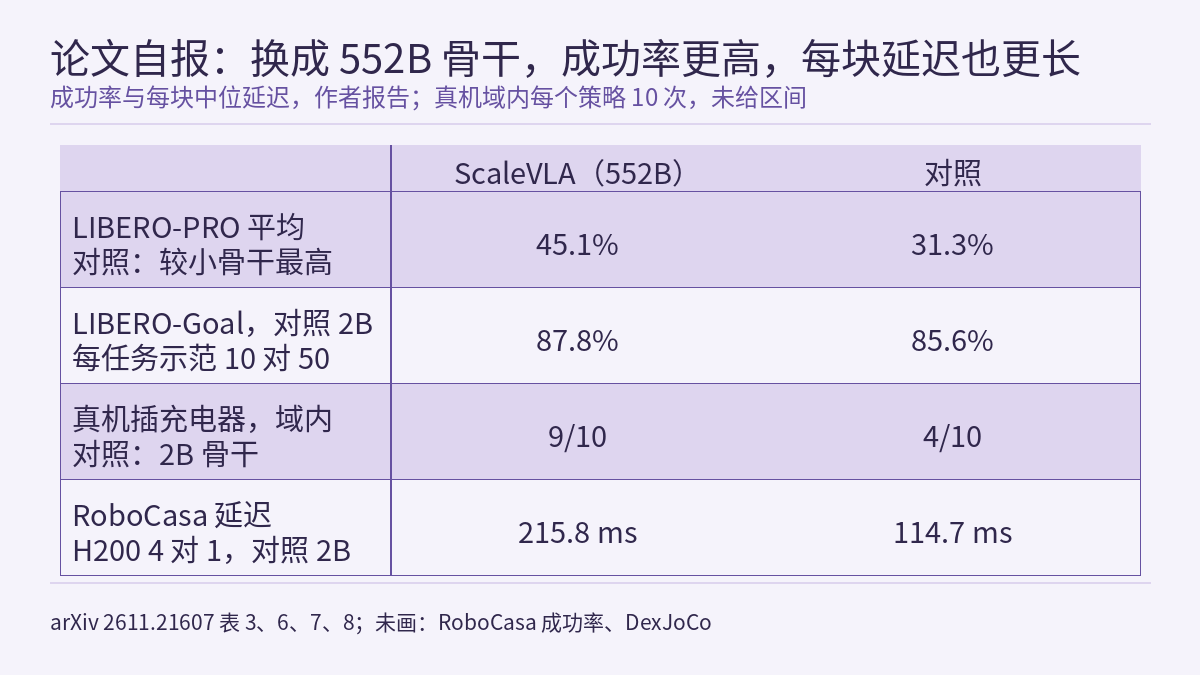
论文指出,多数 VLA 用的视觉-语言骨干比前沿模型小得多,举的例子是 GR00T N1.7 用的 2B Cosmos-Reason2。arXiv 2611.21607(2026-11-16,清华大学、北京大学、上海交通大学与 Galbot)提出 ScaleVLA:把 552B 的混合专家模型 DeepSeek-V4.1-Flash-1017 冻结作骨干,只读取它前半段的特征,后面接一个从零训练的动作 DiT;再让动作头、初始化、示范数据和训练预算保持相同,与 2B 到 32B 的五个骨干对照。作者报告:LIBERO-PRO 扰动下平均成功率 45.1%,较小骨干最高 31.3%;LIBERO-Goal 上每任务 10 条示范达到 87.8%,高于 2B 骨干用 50 条的 85.6%;真机插充电器的域内试验成功 9/10,2B 骨干 4/10;RoboCasa 上每个动作块的中位延迟为 215.8 ms(摘要写作 216 ms),用的是 4 块 H200,2B 骨干在 1 块 H200 上是 114.7 ms。下文数字均为作者报告 [R],本站没有运行代码,也没有复现。本站读到的论文文本包括正文、结论和部分参考文献,没有附录 A–C(训练配方、计时方法、评测设置)。
结构:冻结的骨干只跑因果编码器,动作头从零训练
骨干一侧,视觉编码器把相机图像变成视觉 token;语言骨干分成 20 层因果编码器和 20 层解码器,按模型的参考对话格式处理视觉 token 和指令。ScaleVLA 只运行因果编码器,读取送进下一层注意力的特征,每个 token 5120 维。计算到这里就停,解码器从不运行,也不生成文本。token 保持原有顺序,并带着模态标签,动作头可以分别关注图像 token 和非图像 token。语言骨干和视觉骨干都冻结,梯度只更新动作头,所以作者把骨干特征预先算好一次,训练中反复使用。
动作头按 GR00T N1.7 的架构搭建,全部随机初始化,只用机器人示范训练:
- 特征适配器:层归一化加两层线性投影,把每个骨干 token 从 5120 维映射到 2048 维,再接一个 4 层自注意力 transformer。
- 动作 DiT:32 层,自注意力与交叉注意力交替。自注意力作用于机器人状态 token 和带噪动作 token;交叉注意力读取适配后的骨干特征,相邻的交叉注意力层轮流看非图像 token 和图像 token。
- 训练与推理:用流匹配训练。推理时从高斯噪声出发积分 4 步得到一个动作块,4 步共用同一份骨干特征,所以每个动作块只跑一次骨干。LIBERO 上一块 16 步,执行 8 个指令后重新规划;DexJoCo 上一块 30 步,控制器执行现有动作的同时异步生成替换块。
GR00T N1 的快慢双系统和流匹配动作头,物理AI实验室 3.1 拆过;GR00T N1.7 本身怎样微调,见 物理AI实验室 3.5。ScaleVLA 保留了这类动作头,换掉的是前面的骨干。作者以 GPT-6 Astra 的研究作为出发点:这类通用模型能直接生成机器人动作,但作者认为反复推理和审查动作让每次决策又慢又贵。站内 One Policy for 100 Household Tasks 一文里,GPT-6 Astra 是被调用的智能体;ScaleVLA 只取前沿模型的内部特征,不让它推理。
对照实验固定了什么,没固定什么
六个骨干见论文表 1:Qwen3-VL-2B、Cosmos-Reason2-2B、Cosmos-Reason2-8B、Qwen3-VL-32B、Cosmos-Reason2-32B 是密集模型,DeepSeek-V4.1-Flash-1017 是 552B 的混合专家模型;规模都按源模型的总参数计。作者写明的固定项:同一基准内,动作 DiT、它的初始化和训练数据在各骨干间相同;除单独标注的训练变体外,训练预算和检查点选择规则相同;不加载任何预训练的机器人动作专家;只有适配器的输入宽度随骨干变化。
按论文的表格和正文,下面几项没有固定,读结果时要一起记住:
- 552B 是总参数。混合专家模型每个 token 只激活其中一部分,本站读到的文本没有给出激活参数量。552B 骨干也是表中唯一的 DeepSeek 模型,规模和模型家族是一起变的。
- 推理硬件不同:ScaleVLA 用 4 块 GPU,做张量并行和专家并行;其他骨干各用 1 块。
- 输入 token 数不同:RoboCasa 计时中,ScaleVLA 每个观测 568 个 token,其他骨干 212 个。作者写明没有拆分这一项对延迟的贡献。
- 不是每张表都有全部骨干:RoboCasa 表和 DexJoCo 表没有 Cosmos-Reason2-32B;示范数量实验只比较 Cosmos-Reason2 的 2B、8B、32B 和 552B;真机只比较三个策略。
仿真结果:提升集中在扰动和少示范,有几格没有领先
LIBERO(表 2,每个套件用全部示范训练):ScaleVLA 四套件平均 96.1%,Cosmos-Reason2-32B 为 94.0%,Qwen3-VL-32B 为 93.6%,两个 2B 骨干为 90.7% 和 91.2%。Spatial 和 Object 两个套件接近饱和,ScaleVLA 的 Spatial 98.6% 低于 Cosmos-Reason2-8B 的 99.8%;差别主要在 Goal(96.8%)和 Long(90.2%)。表中 π0、OpenVLA、CoT-VLA 三行是已发表的结果,不在同一设置下重训。
LIBERO-PRO(表 3)用上面的 LIBERO 策略直接测试,不重新训练,加入环境(Env.)和物体(Obj.)扰动:
| 骨干 | Goal,Env. | Goal,Obj. | Object,Env. | 平均 |
|---|---|---|---|---|
| Qwen3-VL-2B | 24.2 | 38.4 | 25.2 | 29.3 |
| Cosmos-Reason2-2B | 20.6 | 37.6 | 11.8 | 23.3 |
| Cosmos-Reason2-8B | 32.6 | 37.6 | 23.6 | 31.3 |
| Qwen3-VL-32B | 11.6 | 44.2 | 12.6 | 22.8 |
| Cosmos-Reason2-32B | 19.2 | 38.8 | 32.4 | 30.1 |
| ScaleVLA(552B) | 47.8 | 56.4 | 31.2 | 45.1 |
所有策略都比表 2 掉了很多。ScaleVLA 平均 45.1%,比最好的密集骨干(Cosmos-Reason2-8B,31.3%)高约 14 个百分点,两个 Goal 扰动列都领先。Object 套件的环境扰动是例外:最好的是 Cosmos-Reason2-32B 的 32.4%,ScaleVLA 为 31.2%。密集骨干之间也不随规模单调上升,Qwen3-VL-32B 的平均 22.8% 低于两个 2B 骨干。作者据此认为前沿模型的特征在训练分布之外迁移得更好,这是作者的解读。
RoboCasa(表 4,分布外厨房场景):每任务 30 条和 100 条生成示范时,2B 到 32B 的骨干分别在 22–26% 和 43–46%,ScaleVLA 为 30.7% 和 54.9%,领先幅度从约 5 个百分点扩大到约 9 个。DexJoCo(表 5,五项双臂灵巧手任务共训一个策略):物体随机化下平均 42.1%,较小骨干最高 38.1%;完全随机化下 24.4%,较小骨干最高 22.1%。逐任务看,物体随机化下的 Microwave,ScaleVLA 为 73.3%,低于 Qwen3-VL-32B 的 89.3%;Assembly 在完全随机化下所有骨干都不超过 1.3%。
示范数量(表 7):Goal 和 Long 两个套件上,每任务示范数 N 取 5、10、25、50,各骨干用相同的嵌套子集,训练固定 5,000 步。2B、8B、32B 都是 Cosmos-Reason2:
| N | Goal 2B | Goal 8B | Goal 32B | Goal 552B | Long 2B | Long 8B | Long 32B | Long 552B |
|---|---|---|---|---|---|---|---|---|
| 5 | 39.4 | 60.6 | 61.2 | 77.4 | 24.0 | 40.0 | 37.6 | 62.2 |
| 10 | 55.0 | 70.0 | 83.0 | 87.8 | 56.0 | 65.2 | 66.4 | 75.0 |
| 25 | 85.2 | 83.0 | 90.4 | 97.6 | 69.6 | 65.6 | 83.6 | 84.6 |
| 50 | 85.6 | 88.6 | 95.2 | 95.4 | 82.4 | 87.2 | 83.8 | 86.8 |
差距在示范少时最大:N = 5 时 Goal 从 39.4% 到 77.4%。摘要里“10 条胜过 50 条”指 552B 在 N = 10 时的 87.8% 高于 2B 在 N = 50 时的 85.6%。示范多了差距收窄:N = 50 时 Goal 上 552B 的 95.4% 与 32B 的 95.2% 只差 0.2 个百分点,Long 上 8B 的 87.2% 还略高于 552B 的 86.8%。另外,表 7 中 2B 在 N = 50 时 Goal 为 85.6%,表 2 中同一骨干用全部示范的 Goal 为 83.2%。表 7 固定 5,000 步,表 2 用附录 A 的基准专用配方,两张表的训练设置不同,数字不能混用。
延迟、硬件与真机:每块更慢,插头插得更快
表 6 是 RoboCasa 上每个动作块的中位延迟,计时从发送观测开始,到客户端收到动作块为止(具体方法在附录 B,本站没有读到)。下面摘三行:
| 骨干 | GPU | token | 骨干(ms) | 动作头(ms) | 合计(ms) |
|---|---|---|---|---|---|
| Cosmos-Reason2-2B | 1 | 212 | 44.7 | 67.1 | 114.7 |
| Cosmos-Reason2-32B | 1 | 212 | 68.4 | 69.0 | 140.7 |
| ScaleVLA(552B) | 4 | 568 | 140.7 | 72.1 | 215.8 |
作者报告,ScaleVLA 的参数是 Cosmos-Reason2-2B 的 276 倍,中位延迟是 1.9 倍。动作头在各骨干上都约 70 ms,在 2B 骨干的总延迟里占一半以上,骨干从 2B 换到 32B 只多出约 26 ms。这个 1.9 倍对应的是 4 块 H200 对 1 块,并且输入 token 数也不同。作者也写明,代价是比小骨干更多的硬件。所读文本没有给出 LIBERO 和真机的控制频率,无法换算一个动作块覆盖多长时间;怎样从时延和块长算出控制频率上限,物理AI实验室 2.6 算过。
真机任务是 RoboDojo 的 Plug In Charger:右臂抓起手机充电器并递出,左臂把插头对准插线板插孔、插入后松开,观测来自一个顶部相机和两个腕部相机。训练数据是完整的遥操作示范,加上专门针对插入阶段的片段;大部分示范从一个参考充电器位置附近开始。三个策略使用相同的动作 DiT、训练数据和训练预算,区别只在骨干:Cosmos-Reason2-2B、π0.5 和 ScaleVLA。π0.5 的 VLM 在 π0.5 训练中用过大规模机器人数据,作者用它检验“小骨干加机器人预训练”能否替代前沿规模的特征。插头插入且左夹爪松开才算成功;每个策略跑 10 次域内试验(从主要训练位置附近开始)和 15 次分布外试验(平移或旋转充电器,或把插线板移出大部分训练位置)。结果见论文表 8:
| 策略 | 域内成功 | 分布外成功 | 插入中位时间(s) | 完成中位时间(s) | 每块往返中位延迟(ms) |
|---|---|---|---|---|---|
| Cosmos-Reason2-2B + 动作头 | 4/10 | 5/15 | 85.9 | 147.1 | 311 |
| π0.5 + 动作头 | 8/10 | 7/15 | 81.2 | 132.0 | 262 |
| ScaleVLA(552B) | 9/10 | 8/15 | 58.1 | 114.4 | 384 |
作者报告,所有域内失败都发生在插入阶段;成功试验中,三个策略在抓取和递交阶段用时相近。ScaleVLA 的往返延迟最高(384 ms),完成时间却最短,中位 114.4 s,比 π0.5 + 动作头的 132.0 s 少 13%,主要因为插入快了 28%。2B 策略因手臂间隙不足多次触发安全停机,ScaleVLA 在所有试验中都没有,所读文本没有给出停机次数。时间列只统计成功的域内试验,所以 2B 策略的中位数只来自 4 次,ScaleVLA 来自 9 次。
论文没有给出区间。本站按 物理AI实验室 2.8 的 Wilson 公式计算 95% 区间:9/10 为 59.6%–98.2%,4/10 为 16.8%–68.7%,两者在 59.6%–68.7% 一段重叠。区间重叠本身不是检验,但它说明 10 次试验给不出这个差距有多大的精确估计。ScaleVLA 与 π0.5 + 动作头之间,域内 9/10 对 8/10、分布外 8/15 对 7/15,都只差一次试验。
局限 / 注意
- 这是 arXiv 预印本,全部数字为作者报告 [R],本站没有复现。本站没有读到附录 A–C,训练配方、计时方法、评测设置和两个真机骨干的验证集动作误差都在附录里。
- 所读各表都没有给出标准差、置信区间或训练种子数。真机每个策略只有 10 次域内和 15 次分布外试验。
- “从 2B 到 552B”同时改变了模型家族(只有一个 DeepSeek 模型)、密集与混合专家结构、推理 GPU 数(4 块对 1 块)和输入 token 数(568 对 212)。这些因素各自贡献多少,论文没有拆分。
- 骨干全程冻结,结论针对的是从因果编码器读出的冻结特征。所读文本没有测试微调骨干的情况。
- 提升不是每格都有:LIBERO-PRO 的 Object 环境扰动、DexJoCo 的 Microwave、示范数 N = 50 时的 LIBERO-Long,都有较小骨干持平或更高。
- 216 ms 是仿真 RoboCasa 上 4 块 H200 的中位延迟;真机往返中位延迟为 384 ms。论文给出了项目主页,本站没有打开,没有核实代码和权重是否公开及其许可证。
链接
- ScaleVLA: Scaling Vision-Language-Action Models to 552 Billion Parameters(arXiv 2611.21607)
- 论文 HTML 全文
- 物理AI实验室 3.1:VLA 拆解,把一个放杯动作编成 256 个区间的词元,再给三个模型的参数量与频率标清口径
- 物理AI实验室 3.5:GR00T 微调实战,逐项核对微调命令与 modality 接线图,再用 CPU 替身实验分清开环误差和闭环成功率
- 物理AI实验室 2.6:上边缘,从时延日志算出控制频率上限,分清量化省下的是体积还是时间,再给动作块定长度
- 物理AI实验室 2.8:可复现评测,手算 Wald 与 Wilson 区间,从 1/√n 定评测次数,再给零失败算出失败率上界
- 前沿雷达|One Policy for 100 Household Tasks:一个 π0.5 检查点做 100 项家务任务,14 项交给先练习过的 GPT-6 Astra,作者自报 Q 0.639 对 0.108
- 物理AI实验室:一套每个数字都能核对的物理 AI 课程


