
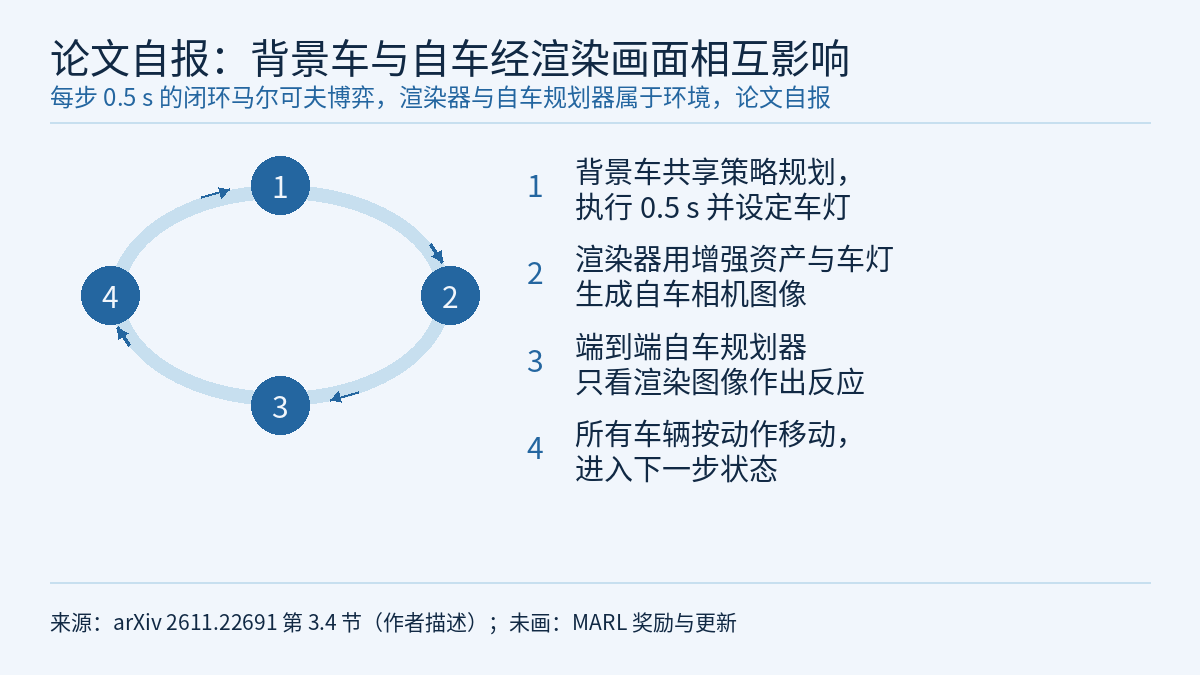
同济大学等机构的 Jia Hu、Jintao Lai 等作者在 arXiv 2611.22691(2026-11-17)提出一个用于自动驾驶的闭环交互式世界模型。他们关注的耦合是:世界模型里,背景车的动作会改变自车相机看到的画面,自车对画面的反应又会改变背景车接下来怎么开,而现有方法把行为建模和视觉渲染分开处理。作者从背景车行为、交互暴露出的车身视角和车灯三处把两者接起来。下文结构与数字均来自这篇预印本,是作者报告的结果 [R],本站没有运行其中任何模型。
现有驾驶世界模型缺的那一环
论文按“谁会回应自车的动作”把驾驶世界模型分成三类。回放约束型只从改变后的视角渲染,自车和背景车都沿既定轨迹走,例如 SplatAD 和 NeuRAD。自车响应型让自车按自己的动作移动,背景车仍走既定轨迹,因此测不到自车与背景车交互时的风险。交通反应型进一步让背景车回应自车,但日志只沿记录的自车轨迹观察场景,交互暴露出的车身侧面等视角没有监督,渲染会出现伪影。作者把 World Engine 视为当前最好的方法:它用 3D Gaussian Splatting(3DGS)重建场景,用 Asset Harvester 补全没见过的车辆视角,并用一个对自车有反应的扩散行为模型驱动背景车。
作者指出三处具体问题。其一,现有背景车行为模型只基于车辆状态构建,而世界模型里的自车是看渲染图像作反应的,背景车面对的自车反应超出了它们的建模范围,碰撞时间(TTC)等交互特征的分布因此偏离真实日志。其二,加塞等交互可能暴露日志里没有的车身侧面,现有流程从各个方向合成图像、重建一个新的高斯资产,把整个原资产换掉,连已经拟合好真实图像的区域也被替换。其三,多数基于重建的世界模型把车灯外观烘焙成静态颜色,NuRec 只能回放日志里的灯态;背景车偏离日志去刹车或变道时,车灯不会跟着变。
站内课程 物理AI实验室 3.2 讲 Cosmos 时的结论是:生成数据是放大器,不是真值来源。这篇论文在 11 个 nuPlan 日志的留出真实帧上报告了一组与此一致的结果:把整车换成生成资产,保真度反而低于不做增强的重建。雷达文章 WorldFailBench 讨论用世界模型评测策略时要核对哪些失败信息;本文介绍的工作检查的是另一件事,即世界模型里其他交通参与者的反应分布是否接近真实驾驶。
背景车行为:先模仿,再在闭环里按日志分布校准
背景车策略先在 INTERACTION 数据集上做模仿学习。一个预训练的风格编码器把背景车最近的运动编码成风格潜变量,归入 3 个风格簇之一;路由器在该簇的 3 个专家中选一个,把场景特征解码成逐步位移,累加成规划轨迹。损失除了回归日志位移,还惩罚加速度、驶出可行驶区域和进入邻车周围的安全裕度。
随后作者把闭环写成一个马尔可夫博弈:背景车是共享同一策略的智能体,渲染器和自车规划器属于环境。每步 0.5 s,每辆背景车规划一条轨迹,执行其中前 0.5 s,并设定自己的车灯状态;自车只看用增强资产和车灯渲染出的图像,给出反应;然后所有车辆按各自的动作移动到下一状态。模仿学习得到的策略被冻结,只训练一个残差头,它从均值初始化为零的高斯分布中采样一个加在位移上的偏移。
奖励按分布设计。对每个加速或减速的交互阶段取三个特征:阶段开始时的 TTC、阶段内带符号的峰值加速度 a_max、阶段结束时的相对速度。对每个特征,比较训练日志上的直方图计数 q 与当前迭代各回合的计数 p,奖励取 log(q/p),当前回合里比日志更少出现的取值得分更高;再减去碰撞、驶出道路和进度偏差的惩罚。优化沿用 MAGRPO:同一场景从相同初始状态和自车随机种子跑 G 个回合,回合之间只有采样的残差不同,所有探索中的背景车共享团队回报的组内相对优势;目标函数带裁剪,并用 KL 项约束策略不偏离初始策略太远。
评测在 NAVSIM 的 288 个长尾 navtest 失败场景上进行,它们来自 89 个 nuPlan 日志。每回合 12 步、步长 0.5 s,8 路环视相机。自车规划器是 Alpamayo 1.5,只输入 2 Hz 的前视相机图像,从未微调。所有方法共用场景、自车规划器、增强资产和车灯,只在被评测的组件上不同。背景车策略在 nuPlan navtrain 场景上微调,与测试集没有日志重叠。交互真实性在 1,715 辆动态背景车上比较闭环回合与日志的三种特征分布,指标是 Jensen–Shannon(JS)散度和直方图重叠度,另报告背景车碰撞率和路程。
下表摘自论文表 1(作者报告)。RealEngine 的背景车由 DiffusionDrive 规划器驱动,放在作者的闭环和渲染器中运行;OmniNWM 的背景车状态是从生成视频中估计的;日志参考一行的“碰撞”是记录框的重叠。
| 方法 | TTC 重叠 ↑ | a_max 重叠 ↑ | 相对速度重叠 ↑ | 平均重叠 ↑ | 平均 JS ↓ | 碰撞率 ↓ | 路程 (m) ↑ |
|---|---|---|---|---|---|---|---|
| 日志参考 | – | – | – | – | – | 3.50% | 27.66 |
| RealEngine | 0.8588 | 0.4324 | 0.6778 | 0.6563 | 0.1152 | 12.71% | 20.30 |
| OmniNWM | 0.7455 | 0.1492 | 0.8544 | 0.5830 | 0.1886 | 23.08% | 14.65 |
| World Engine | 0.9527 | 0.5771 | 0.8498 | 0.7932 | 0.0485 | 10.38% | 25.91 |
| 作者方法 | 0.9775 | 0.8719 | 0.9102 | 0.9198 | 0.0074 | 9.74% | 28.10 |
平均 JS 散度从 World Engine 的 0.0485 降到 0.0074,即作者所说的降低 85%。作者的解读是:对所有对比方法,a_max 都是匹配最差的特征(重叠度最高 0.58),TTC 则匹配得好得多(最高 0.95),也就是背景车开始反应的时机大致对,反应的方式不对。两种偏差方向相反:World Engine 的背景车反应强度约为日志车辆的两倍(|a_max| 中位数 4.7 对 2.3 m/s²);RealEngine 的背景车在 73% 的交互阶段减速(日志为 46%),路程少 27%。作者方法的路程与日志相差不到 2%。消融中,只用模仿学习、不做闭环微调时,平均 JS 散度上升 77%(配对差 +0.0057,95% CI [+0.0021, +0.0092]);这时背景车面对看图规划的自车会过度刹车,在 66% 的交互阶段减速,路程少 9%;闭环微调把减速比例降到 50%。
车辆画面:只修交互暴露、日志又没约束的部分
日志里的一辆车只从少数方向被拍到。作者对车辆资产中的每个高斯逐一诊断:根据训练视图中相机相对该高斯的方位角和混合权重,累计它在各方位角上的观测支持;MTGS 为每个高斯保留的左右镜像副本也计入支持,但打折扣。然后从探测视角渲染资产,探测视角由均匀分布的 360° 视角和权重更高的交互关键视角组成,后者取自闭环回合中自车相机的方向(例如加塞时)。一个高斯的“缺陷度”定义为它的贡献中缺少观测支持的份额,所以交互会暴露、日志又没约束的高斯缺陷度高。
修补分两类。缺陷度高的原有高斯会显示从无支持方向外推出的颜色,作者把它的视角相关球谐系数乘以(1 − 缺陷度),保留基础颜色。从未被观测的表面根本没有高斯,缺陷度看不到它们;这些空洞由供体资产填补。供体资产由 Asset Harvester 根据日志里该车的图像裁剪做多视角合成得到,只有落在原资产留空像素上的贡献份额超过阈值 u0 的供体高斯会被加入。修补后的资产在训练图像上微调,最后在图像空间做两步处理:按相机、按通道的颜色校准;再由一个轻量 U-Net 逐像素决定接受多少扩散协调器(DiffusionHarmonizer)的修正和多少供体残差,另有一项自由残差,其幅度有上限。
模拟出的交互没有真值,所以作者在 11 个 nuPlan 日志中留出若干时刻的全部相机图像和 LiDAR,在真实的相机和车辆位姿下渲染整个场景,共评测 1,184 张留出图像和 365 个车辆区域。所有方法共用 MTGS 背景,只在目标车辆资产或后处理上不同。下表摘自论文表 2(作者报告):
| 方法 | 车辆 PSNR ↑ | 车辆 SSIM ↑ | 车辆 LPIPS ↓ | 全图 PSNR ↑ |
|---|---|---|---|---|
| MTGS | 17.05 | 0.411 | 0.466 | 18.17 |
| Difix3D+ | 16.91 | 0.396 | 0.415 | 18.18 |
| DiffusionHarmonizer | 17.11 | 0.406 | 0.432 | 18.08 |
| Asset Harvester | 15.24 | 0.359 | 0.504 | 18.06 |
| World Engine | 15.97 | 0.375 | 0.490 | 18.08 |
| 作者方法 | 17.97 | 0.438 | 0.448 | 19.01 |
作者方法的车辆区域 PSNR 比 World Engine 高 2.0 dB。把整车换成生成资产的两种方法(Asset Harvester、World Engine)比不做增强的 MTGS 重建低 1.1–1.8 dB;作者的解释是生成资产看起来合理,却覆盖了日志中已观测到的区域,内容已不属于那辆车。整帧扩散增强器(Difix3D+、DiffusionHarmonizer)通过锐化纹理得到更低的 LPIPS,其中 Difix3D+ 最低,但车辆 SSIM 下降,PSNR 几乎不变。作者方法的 LPIPS 不是最好,作者说这是有意偏向对日志车辆的保真而不是锐度。消融中,诊断引导的修补是最大的单步,贡献 0.54 dB,接近总增益的 60%。
车灯:为日志里没出现过的灯态做反事实微调
车灯状态由每辆背景车自己的规划和意图决定:规划减速度超过阈值时点亮刹车灯;有变道意图时,在可见的横向运动之前打开对应一侧的转向灯,以 1 s 周期闪烁直到变道结束。为了让灯位在帧间稳定,作者在资产上做三维灯位锚定:把日志图像中分割出的灯区用渲染深度反投影到车辆坐标系,只保留多个视角都命中的体素,没见过的一侧做左右镜像。
难点在于日志只记录了每辆车实际发生的意图,灯态很少;一辆车“本来在巡航、改为刹车”时的样子没有配对图像。作者用 LoRA 把一步扩散模型 Difix 微调成编辑器,输入是渲染出的车辆裁剪图、同一辆车的参考视图及其观测灯态、灯位图和标出要点亮灯位的状态图,输出只在灯区掩码内合成。训练时保持其他输入不变而翻转灯态:实际灯态下的输出与真实照片比较重建损失(L1 与 LPIPS);翻转后的输出必须让一个冻结的 ResNet-18 灯态分类器读出翻转后的状态,另有一项惩罚点亮灯的色调漂移。
灯态正确性由一个训练中从未使用的独立视觉语言模型 Qwen2.5-VL-7B 读出。刹车灯评测为 435 项双向反事实编辑(115 辆车),转向灯为 272 项左右激活(136 辆车)。作者方法的刹车灯 macro-F1 为 0.839(FLUX 为 0.830),转向灯 macro-F1 为 0.769(FLUX 为 0.685)。通用编辑器会改写 4%–88% 的车身像素,作者方法改动不到 0.2%(分别以同灯态和目标灯态照片为参考时为 0.14% 和 0.06%)。所有编辑器关灯都比开灯难,关灯也是作者方法的主要失败模式。消融中,去掉反事实损失后,对日志里只见过灭灯状态的车辆,开灯召回率从 86.1% 降到 35.4%;作者称三维锚定不提高单帧准确率(去掉后刹车灯 mF1 为 0.845,完整方法为 0.839),采用它是为了时间稳定性:去掉后灯中心跳变率上升 9.5 个百分点(95% CI [+5.0, +14.3])。
为检验车灯对自车的影响,作者在 288 个场景上分别开启和关闭车灯渲染,其他设置相同。自车轨迹偏离超过 10 cm 的场景比例,Alpamayo 1.5 为 24.3%,openpilot 为 21.5%。对 Alpamayo 1.5,车灯在 36% 的场景中改变了规划器的前视输入图像,其中 67% 的场景轨迹出现偏离,平均 0.77 m。作者据此认为,车灯静态的世界模型会在约四分之一的长尾场景中改变被测自车的行为。
局限 / 注意
- 这是 arXiv 预印本,所有数字为作者报告,没有独立复现;本站读到的正文没有给出代码或数据链接。
- 对比方法的运行条件不完全相同:RealEngine 的背景车在作者自己的闭环和渲染器中运行,OmniNWM 的背景车状态是从生成视频中估计的。论文写明置信区间由场景级或车辆级配对自助法得到,但所读正文只给出了部分消融的区间,表 1 和表 2 的数值没有附区间。
- 行为奖励直接针对评测所用的三个交互特征分布,只是奖励用的是训练日志,与测试日志不重叠。“更接近日志”在一定程度上就是优化目标本身,这是本站的推断,论文没有这样说。分布匹配也不是安全验证:作者方法的背景车碰撞率 9.74% 仍高于日志参考的 3.50%(日志中的“碰撞”是记录框的重叠)。
- 每回合 12 步、每步 0.5 s,即 6 s;自车规划器只用前视相机。车灯对自车的影响只在 Alpamayo 1.5 和 openpilot 两个规划器上测过,偏离阈值是 10 cm。
- 灯态正确性由视觉语言模型读出,不是人工标注。新视角保真度在留出的真实帧上测量,交互引起的新视角本身没有真值。


