
同済大学などの Jia Hu、Jintao Lai らは arXiv 2611.22691(2026-11-17)で、自動運転向けの閉ループ型インタラクティブ世界モデルを提案しました。著者が扱う結び付きは次のとおりです。世界モデルの中では、背景車の動きが自車カメラに映る画像を変え、その画像への自車の反応が次の背景車の運転を変えます。それにもかかわらず、既存手法は挙動のモデル化と映像の描画を別々に扱っています。著者は背景車の挙動、交互作用で露出する車両の視点、灯火の三か所で両者をつなぎます。以下の構成と数値はこのプレプリントによるもので、著者報告の結果です [R]。本サイトはどのモデルも実行していません。
既存の運転世界モデルに欠けているもの
論文は、自車の行動に何が応答するかで運転世界モデルを三つに分けます。リプレイ制約型は変更した視点から描画するだけで、自車も背景車も決められた軌跡をたどります。SplatAD や NeuRAD がこれにあたります。自車応答型は自車を自分の行動で動かしますが、背景車は決められた軌跡のままなので、背景車との交互作用で生じるリスクを試験できません。交通反応型は背景車にも自車への応答をさせますが、ログは記録された自車軌跡に沿った視点からしかシーンを観測していません。そのため交互作用で露出する視点、たとえば見えていなかった車両側面には教師信号がなく、描画にアーティファクトが出ます。著者は World Engine を現時点の最先端とみなしています。World Engine は 3D Gaussian Splatting(3DGS)でシーンを再構成し、Asset Harvester で見えていない車両視点を補い、自車に反応する拡散ベースの挙動モデルで背景車を動かします。
著者は具体的な問題を三つ挙げます。第一に、既存の背景車挙動モデルは車両状態だけをもとに作られていますが、世界モデル内の自車は描画画像を見て反応します。背景車は想定していない自車の反応に直面し、衝突余裕時間(TTC)などの交互作用特徴の分布が実際のログからずれます。第二に、割り込みなどの交互作用でログにない車両側面が露出することがあります。既存のパイプラインは車両を全方向から合成した画像で新しいガウシアン資産を作り直し、元の資産全体を置き換えるため、実画像によく合っていた領域まで置き換わります。第三に、再構成ベースの世界モデルの多くは灯火の見た目を静的な色として焼き込み、NuRec はログの灯火状態を再生することしかできません。背景車がログから外れてブレーキや車線変更をしても、灯火は変わりません。
講座 フィジカルAIラボ 3.2 は Cosmos を扱う中で、生成データはデータを増幅するものであって正解の出どころではない、と結論づけています。この論文は 11 本の nuPlan ログから取り分けた実フレームで、これと整合する結果を報告しています。車両全体を生成資産に置き換えると、強化していない再構成よりも忠実度が下がるという結果です。レーダー記事 WorldFailBench は、世界モデルで方策を評価するときに確かめるべき失敗情報を論じています。本記事で取り上げる研究が確かめているのは別の点で、世界モデル内のほかの交通参加者の反応が実際の運転と同じように分布しているかどうかです。
背景車の挙動:まず模倣し、閉ループでログの分布に合わせる
背景車の方策は、まず INTERACTION データセットで模倣学習します。事前学習したスタイルエンコーダが背景車の直近の動きをスタイル潜在変数に変換し、3 つのスタイルクラスタのいずれかに割り当てます。ルータはそのクラスタ内の 3 つのエキスパートから 1 つを選び、選ばれたエキスパートがシーン特徴をステップごとの変位に復号し、それを積み上げて計画軌跡にします。損失はログの変位への回帰に加えて、加速度、走行可能領域からの逸脱、周囲車両の安全マージンへの侵入にペナルティを科します。
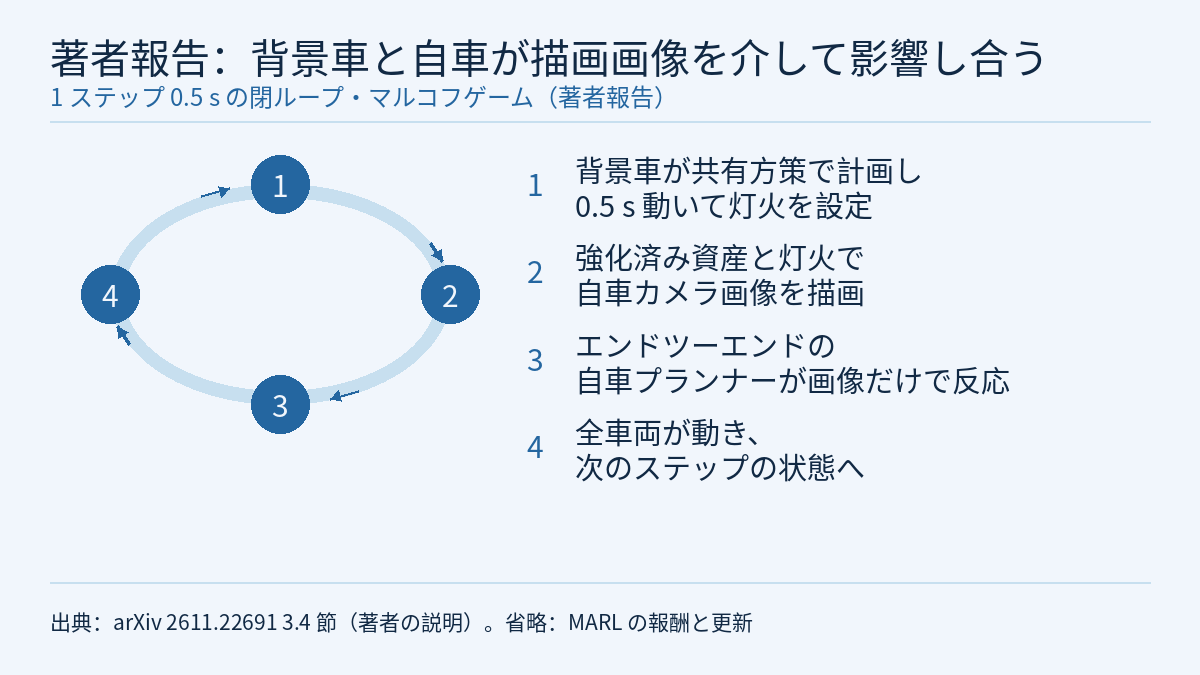
次に著者は閉ループをマルコフゲームとして定式化します。背景車は一つの方策を共有するエージェントで、描画器と自車プランナーは環境側に属します。0.5 s の各ステップで、各背景車は軌跡を計画してその最初の 0.5 s を実行し、自分の灯火状態を設定します。自車は強化済み資産と灯火で描画された画像だけを見て反応し、その後すべての車両がそれぞれの行動に従って次の状態へ移ります。模倣学習で得た方策は固定し、残差ヘッドだけを学習します。残差ヘッドは、平均をゼロで初期化したガウス分布から変位に加えるオフセットをサンプリングします。
報酬は分布の水準で設計されています。加速または減速の開始から終了までを一つの交互作用フェーズとし、各フェーズから三つの特徴を取り出します。開始時の TTC、フェーズ中の符号付きピーク加速度 a_max、終了時の相対速度です。特徴ごとに、学習用ログでのヒストグラム度数 q と現在の反復のエピソードでの度数 p を比べ、報酬を log(q/p) とします。現在のロールアウトでログより出現が少ない値ほど得点が高くなります。そこから衝突、道路外への逸脱、進捗のずれのペナルティを差し引きます。最適化は MAGRPO に従います。各シーンで同じ初期状態と自車の乱数シードから G 回のエピソードを走らせるので、エピソード間の違いはサンプリングした残差だけです。探索中のすべての背景車は、チーム報酬のグループ内相対アドバンテージを共有します。目的関数はクリップされ、KL 項で方策が初期方策から離れすぎないようにします。
評価には NAVSIM のロングテールの navtest 失敗シナリオ 288 件を使います。これらは 89 本の nuPlan ログから取られています。各エピソードは 0.5 s のステップを 12 回、サラウンドカメラは 8 台です。自車プランナーは Alpamayo 1.5 で、2 Hz の前方カメラ画像だけを入力し、一度も微調整していません。すべての手法でシナリオ、自車プランナー、強化済み資産、灯火を共通にし、評価対象のコンポーネントだけを変えています。背景車の方策は nuPlan navtrain のシナリオで微調整しており、テストセットとログの重複はありません。交互作用のリアルさは、1,715 台の動的な背景車について閉ループのロールアウトとログの三つの特徴分布を比べ、Jensen–Shannon(JS)ダイバージェンスとヒストグラムの重なりで測ります。背景車の衝突率と走行距離もあわせて報告されています。
次の表は論文の表 1 から抜き出したものです(著者報告)。RealEngine の背景車は DiffusionDrive のプランナーで動き、著者自身の閉ループと描画器の中で実行されています。OmniNWM の背景車の状態は生成動画から推定されています。ログ参照の行の「衝突」は、記録されたボックス同士の重なりです。
| 手法 | TTC の重なり ↑ | a_max の重なり ↑ | 相対速度の重なり ↑ | 平均の重なり ↑ | 平均 JS ↓ | 衝突率 ↓ | 走行距離 (m) ↑ |
|---|---|---|---|---|---|---|---|
| ログ参照 | – | – | – | – | – | 3.50% | 27.66 |
| RealEngine | 0.8588 | 0.4324 | 0.6778 | 0.6563 | 0.1152 | 12.71% | 20.30 |
| OmniNWM | 0.7455 | 0.1492 | 0.8544 | 0.5830 | 0.1886 | 23.08% | 14.65 |
| World Engine | 0.9527 | 0.5771 | 0.8498 | 0.7932 | 0.0485 | 10.38% | 25.91 |
| 著者の手法 | 0.9775 | 0.8719 | 0.9102 | 0.9198 | 0.0074 | 9.74% | 28.10 |
平均 JS ダイバージェンスは World Engine の 0.0485 から 0.0074 に下がっており、これが著者のいう 85% の低減です。著者の解釈では、比較したどの手法でも a_max が最も合わない特徴で(重なりは最大 0.58)、TTC ははるかによく合っています(最大 0.95)。背景車が反応し始めるタイミングはおおむね正しいものの、反応のしかたが違うということです。ずれの向きは逆です。World Engine の背景車はログの車両の約 2 倍の強さで反応し(|a_max| の中央値は 4.7 対 2.3 m/s²)、RealEngine の背景車は交互作用フェーズの 73% で減速し(ログでは 46%)、走行距離は 27% 短くなります。著者の手法の走行距離はログとの差が 2% 以内です。アブレーションでは、閉ループでの微調整をせず模倣学習の方策だけを使うと、平均 JS ダイバージェンスが 77% 上がります(対応のある差 +0.0057、95% CI [+0.0021, +0.0092])。このとき背景車は描画画像から計画する自車に対してブレーキをかけすぎ、交互作用フェーズの 66% で減速し、走行距離は 9% 短くなります。閉ループでの微調整により、減速の割合は 50% まで下がります。
車両の見た目:交互作用で露出し、ログで制約されていない部分だけを補修する
ログの中の車両は少数の方向からしか撮影されていません。著者は車両資産のガウシアンを一つずつ診断します。各学習ビューでのガウシアンから見たカメラの方位角と混合重みから、方位角ごとの観測による裏付けを累積します。MTGS が各ガウシアンについて保持する左右反転のコピーも裏付けに数えますが、割り引きます。そのうえでプローブ視点から資産を描画します。プローブ視点は均一に配置した 360° の視点と、より重みの大きい交互作用上重要な視点からなり、後者は閉ループのロールアウトでの自車カメラの方向(たとえば割り込みの場面)から取ります。ガウシアンの「欠陥度」は、その寄与のうち観測の裏付けを欠く割合として定義されるため、交互作用で露出するのにログでは制約されていないガウシアンほど値が高くなります。
補修は二種類です。欠陥度の高い元のガウシアンは、裏付けのない方向から外挿した色を示すので、著者は視点依存の球面調和係数に(1 − 欠陥度)を掛け、基本色は残します。一度も観測されていない表面にはそもそもガウシアンがなく、欠陥度では検出できません。こうした穴はドナー資産で埋めます。ドナー資産は、ログ内のその車両の切り出し画像から Asset Harvester が多視点合成で生成したもので、元の資産が空けたピクセルに落ちる寄与の割合がしきい値 u0 を超えるドナーのガウシアンだけを追加します。補修した資産は学習画像で微調整し、最後に画像空間で二段階の処理をします。カメラごと・チャネルごとの色補正を行い、次に軽量な U-Net が、拡散ハーモナイザー(DiffusionHarmonizer)による補正とドナーの残差をそれぞれどれだけ受け入れるかをピクセルごとに決めます。自由な残差の項もあり、その大きさには上限があります。
シミュレーションした交互作用には正解がないため、著者は 11 本の nuPlan ログで選んだ時刻のカメラ画像と LiDAR をすべて評価用に取り分け、実際のカメラと車両の姿勢でシーン全体を描画しました。評価したのは取り分けた画像 1,184 枚と車両領域 365 か所です。すべての手法が MTGS の背景を共有し、対象車両の資産か後処理だけが異なります。次の表は論文の表 2 によります(著者報告)。
| 手法 | 車両 PSNR ↑ | 車両 SSIM ↑ | 車両 LPIPS ↓ | 画像全体 PSNR ↑ |
|---|---|---|---|---|
| MTGS | 17.05 | 0.411 | 0.466 | 18.17 |
| Difix3D+ | 16.91 | 0.396 | 0.415 | 18.18 |
| DiffusionHarmonizer | 17.11 | 0.406 | 0.432 | 18.08 |
| Asset Harvester | 15.24 | 0.359 | 0.504 | 18.06 |
| World Engine | 15.97 | 0.375 | 0.490 | 18.08 |
| 著者の手法 | 17.97 | 0.438 | 0.448 | 19.01 |
著者の手法の車両領域 PSNR は World Engine より 2.0 dB 高くなっています。車両全体を生成資産に置き換える二つの手法(Asset Harvester と World Engine)は、強化していない MTGS の再構成より 1.1–1.8 dB 低くなります。著者の説明では、生成資産はもっともらしく見えるものの、ログで観測済みの領域を、もはやその車両のものではない内容で上書きしてしまいます。画像全体に拡散モデルをかける強化手法(Difix3D+ と DiffusionHarmonizer)はテクスチャを鮮鋭化して LPIPS を下げ、Difix3D+ が最も低い値ですが、車両の SSIM は下がり、PSNR はほとんど変わりません。著者の手法の LPIPS は最良ではなく、著者はこれを、鮮鋭さよりもログの車両への忠実さを意図的に優先した結果だと説明しています。アブレーションでは、診断に基づく補修が単独で最大の段階で、0.54 dB、全体の向上の 60% 近くを占めます。
灯火:ログに一度も現れなかった状態を反実仮想の微調整で学ぶ
灯火の状態は、各背景車自身の計画と意図に従います。計画した減速度がしきい値を超えるとブレーキランプが点灯します。車線変更の意図があると、横方向の動きが見える前にその側のウインカーが点灯し、車線変更が終わるまで 1 s 周期で点滅します。フレーム間でランプの位置を安定させるため、著者は各資産上でランプを 3D に固定します。ログ画像で分割したランプのマスクを、描画した深度を使って車両の座標系へ逆投影し、複数の視点から当たるボクセルだけを残し、見えていない側は左右反転で補います。
難しいのは、ログには各車両で実際に起きた意図しか記録されておらず、灯火の状態もわずかしかないことです。巡航ではなくブレーキをかけた場合の見た目には、対になる画像がありません。著者は 1 ステップの拡散モデル Difix を LoRA で微調整して編集器にしました。入力は、描画した車両の切り出し画像、同じ車両の参照ビューとその観測された灯火状態、ランプマップ、点灯させるランプを示す状態マップです。出力はランプのマスク内だけで合成されます。学習ではほかの入力を固定したまま灯火状態を反転させます。観測どおりの状態での出力は実写と比べて再構成損失(L1 と LPIPS)をとり、反転した出力は、固定した ResNet-18 の灯火状態分類器が反転後の状態を読み取れるものでなければなりません。点灯したランプの色相のずれを罰する項も加えます。
灯火状態の正しさは、学習に一度も使っていない独立の視覚言語モデル Qwen2.5-VL-7B で読み取ります。ブレーキランプの評価は双方向の反実仮想編集 435 件(115 台)、ウインカーは左右の点灯 272 件(136 台)です。著者の手法のブレーキランプの macro-F1 は 0.839(FLUX は 0.830)、ウインカーの macro-F1 は 0.769(FLUX は 0.685)です。汎用の編集器は車体のピクセルの 4%–88% を描き換えますが、著者の手法の変更は 0.2% 未満です(同じ状態と目標状態の実写を参照した場合でそれぞれ 0.14% と 0.06%)。どの編集器でも消灯は点灯より難しく、消灯は著者の手法でも主な失敗パターンです。アブレーションでは、反実仮想の損失を外すと、ログで消灯状態しか観測されていない車両に対する点灯の再現率が 86.1% から 35.4% に下がります。著者は、3D アンカーは単一フレームの精度を上げない(外した場合のブレーキランプ mF1 は 0.845、完全な手法では 0.839)とし、時間的な安定性のために採用しています。外すとランプ中心のジャンプ率が 9.5 ポイント上がります(95% CI [+5.0, +14.3])。
灯火が自車に与える影響を調べるため、著者は 288 件のシナリオを、ほかの条件を同じにして灯火の描画ありとなしで走らせました。自車の軌跡が 10 cm を超えてずれたシナリオの割合は、Alpamayo 1.5 で 24.3%、openpilot で 21.5% です。Alpamayo 1.5 では、灯火によってプランナーの前方入力画像が変わったのがシナリオの 36% で、そのうち 67% で軌跡がずれ、ずれは平均 0.77 m でした。著者はここから、灯火が静的な世界モデルでは、ロングテール・シナリオの約 4 分の 1 で試験対象の自車の挙動が変わってしまうと結論づけています。
制約と注意点
- これは arXiv のプレプリントで、数値はすべて著者報告であり、独立した再現はありません。本記事のために読んだ本文には、コードやデータへのリンクはありません。
- 比較手法の実行条件は同一ではありません。RealEngine の背景車は著者自身の閉ループと描画器で動かされ、OmniNWM の背景車の状態は生成動画から推定されています。論文は信頼区間をシーン単位または車両単位の対応のあるブートストラップで求めたと書いていますが、読んだ本文で区間が示されているのは一部のアブレーションだけで、表 1 と表 2 の値には区間がありません。
- 挙動の報酬は評価に使う三つの交互作用特徴の分布そのものを狙っています。ただし報酬に使うのは学習用ログで、テスト用のログとは重複しません。それでも「ログに近い」という結果は、ある程度は最適化の目標そのものです。これは本サイトの推論で、論文の記述ではありません。分布が合うことは安全性の検証でもありません。著者の手法の背景車の衝突率 9.74% は、ログ参照の 3.50% をまだ上回っています(ログの「衝突」は記録されたボックス同士の重なりです)。
- 各エピソードは 0.5 s のステップが 12 回、つまり 6 s で、自車プランナーは前方カメラしか使いません。灯火の自車への影響は Alpamayo 1.5 と openpilot の 2 つのプランナーでしか測っておらず、ずれのしきい値は 10 cm です。
- 灯火状態の正しさは視覚言語モデルによる読み取りで、人手のアノテーションではありません。新しい視点の忠実度は取り分けた実フレームで測っており、交互作用で生じる新しい視点そのものには正解がありません。
リンク
- Making the World React Realistically: A Closed-Loop Interactive World Model for Autonomous Driving(arXiv 2611.22691)
- 論文の HTML 全文
- フィジカルAIラボ 3.2:世界モデル――Cosmos でデータをつくる。生成ごとの条件を書き出し、78.3% を人の評価に戻し、生成データの受け入れ基準を決める
- フロンティア・レーダー|WorldFailBench:世界モデルで方策を評価するなら、成功率に加えて失敗の原因・段階・境界を確かめる
- フィジカルAIラボ:すべての数字を確認できるフィジカルAI講座


