
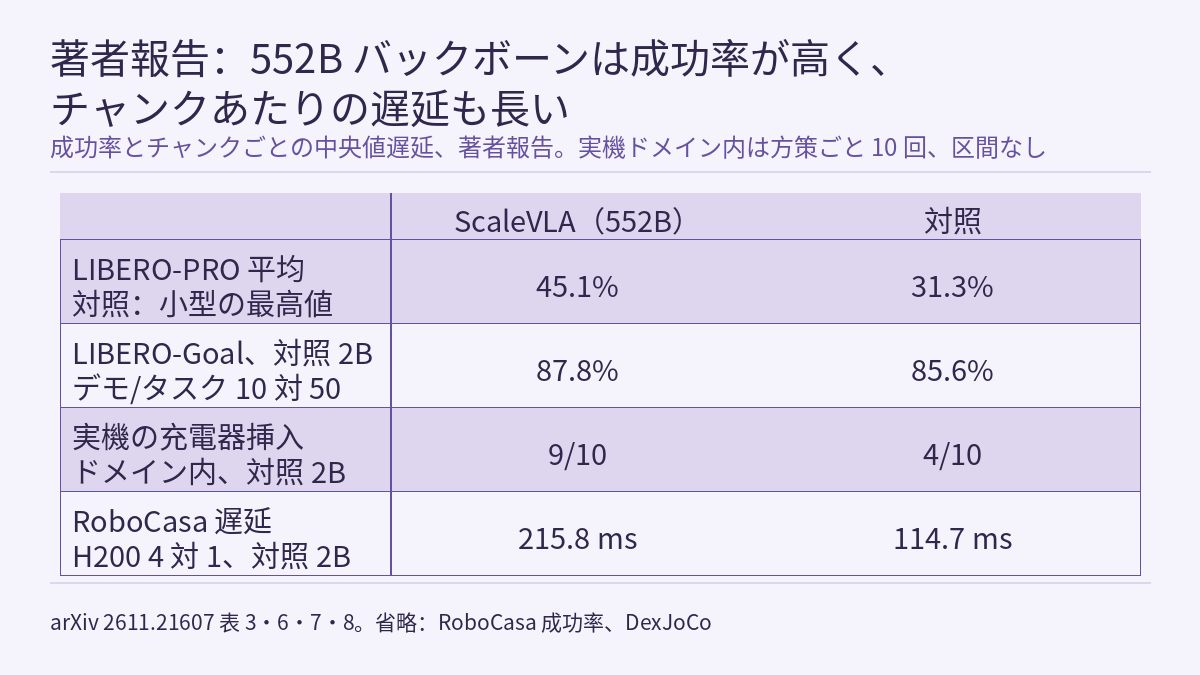
論文によれば、多くの VLA の視覚言語バックボーンはフロンティアモデルよりずっと小さく、例として GR00T N1.7 が使う 2B の Cosmos-Reason2 を挙げています。arXiv 2611.21607(2026-11-16、清華大学・北京大学・上海交通大学・Galbot)が提案する ScaleVLA は、552B の混合エキスパートモデル DeepSeek-V4.1-Flash-1017 を凍結してバックボーンとし、その前半の特徴だけを読み出して、ゼロから学習する動作 DiT につなぎます。そのうえで動作ヘッド、初期化、デモデータ、学習予算を同じにして、2B から 32B までの 5 つのバックボーンと比較しています。著者報告では、LIBERO-PRO の摂動下で平均成功率 45.1%(小さいバックボーンの最高は 31.3%)、LIBERO-Goal ではタスクあたり 10 件のデモで 87.8% となり、2B バックボーンが 50 件で得た 85.6% を上回りました。実機での充電器差し込みはドメイン内で 9/10(2B バックボーンは 4/10)です。RoboCasa での動作チャンクあたりの中央値遅延は 215.8 ms(要旨では 216 ms)で、H200 を 4 基使っています。2B バックボーンは H200 1 基で 114.7 ms です。以下の数値はすべて著者報告 [R] で、本サイトはコードを実行しておらず、再現もしていません。本サイトが読んだ論文テキストは本文、結論、参考文献の一部までで、付録 A〜C(学習レシピ、計時方法、評価設定)は含まれていません。
構成:凍結したバックボーンは因果エンコーダだけを動かし、動作ヘッドはゼロから学習する
バックボーン側では、視覚エンコーダがカメラ画像を視覚トークンに変換し、20 層の因果エンコーダと 20 層のデコーダからなる言語バックボーンが、モデルの参照チャット形式で視覚トークンと指示を処理します。ScaleVLA は因果エンコーダだけを実行し、次の層のアテンションに渡される特徴を読み出します。1 トークンあたり 5120 次元です。計算はそこで止まり、デコーダは一度も実行されず、テキストも生成しません。トークンは元の順序を保ち、モダリティのラベルが付くので、動作ヘッドは画像トークンと非画像トークンを分けて参照できます。言語バックボーンと視覚バックボーンはどちらも凍結され、勾配は動作ヘッドだけを更新します。そのため著者はバックボーンの特徴を事前に一度だけ計算し、学習中に使い回しています。
動作ヘッドは GR00T N1.7 のアーキテクチャに従い、すべてランダムに初期化して、ロボットのデモだけで学習します。
- 特徴アダプタ:レイヤー正規化と 2 層の線形射影で各バックボーントークンを 5120 次元から 2048 次元に写し、その後に 4 層の自己アテンション transformer を置きます。
- 動作 DiT:32 層で、自己アテンションとクロスアテンションが交互に並びます。自己アテンションはロボット状態のトークンとノイズを加えた動作トークンに作用し、クロスアテンションは適応後のバックボーン特徴を読みます。隣り合うクロスアテンション層は非画像トークンと画像トークンを交互に参照します。
- 学習と推論:フローマッチングで学習します。推論ではガウスノイズから 4 ステップ積分して動作チャンクを得ます。4 ステップとも同じバックボーン特徴を使うので、バックボーンは 1 チャンクにつき 1 回だけ動きます。LIBERO では 1 チャンク 16 ステップで、8 個の指令を実行してから再計画します。DexJoCo では 1 チャンク 30 ステップで、コントローラが手元の動作を実行している間に置き換え用のチャンクを非同期に生成します。
GR00T N1 の速いシステムと遅いシステム、フローマッチングの動作ヘッドは フィジカルAIラボ 3.1 で分解しました。GR00T N1.7 自体のファインチューニングは フィジカルAIラボ 3.5 を参照してください。ScaleVLA はこの種の動作ヘッドを残し、その前のバックボーンを取り替えています。著者は GPT-6 Astra の研究を出発点にしています。こうした汎用モデルはロボットの動作を直接生成できますが、推論と動作の見直しを繰り返すので判断ごとに遅く高コストになる、というのが著者の見方です。本サイトの One Policy for 100 Household Tasks の記事では GPT-6 Astra は呼び出されるエージェントでした。ScaleVLA はフロンティアモデルの内部特徴だけを取り出し、推論はさせません。
比較で固定したもの、固定していないもの
6 つのバックボーンは論文の表 1 にあります。Qwen3-VL-2B、Cosmos-Reason2-2B、Cosmos-Reason2-8B、Qwen3-VL-32B、Cosmos-Reason2-32B は密なモデル、DeepSeek-V4.1-Flash-1017 は 552B の混合エキスパートモデルで、規模はいずれも元のモデルの総パラメータ数です。著者が明記している固定項目は次のとおりです。同じベンチマーク内では、動作 DiT、その初期化、学習データはバックボーン間で同じです。別に示した学習の変種を除き、学習予算とチェックポイントの選び方も同じです。事前学習済みのロボット動作エキスパートは読み込みません。バックボーンに合わせて変わるのはアダプタの入力幅だけです。
論文の表と本文によれば、次の点は固定されていないので、結果を読むときに併せて押さえておく必要があります。
- 552B は総パラメータ数です。混合エキスパートモデルはトークンごとにその一部しか活性化せず、本サイトが読んだテキストには活性化パラメータ数がありません。552B のバックボーンは表で唯一の DeepSeek モデルでもあり、規模とモデルファミリーが同時に変わっています。
- 推論ハードウェアが違います。ScaleVLA は GPU 4 基でテンソル並列とエキスパート並列を使い、ほかのバックボーンは各 1 基です。
- 入力トークン数が違います。RoboCasa の計時では、ScaleVLA は観測ごとに 568 トークン、ほかのバックボーンは 212 トークンです。この差が遅延にどれだけ効いているかは切り分けていない、と著者は書いています。
- すべての表にすべてのバックボーンがあるわけではありません。RoboCasa と DexJoCo の表には Cosmos-Reason2-32B がなく、デモ数の実験は Cosmos-Reason2 の 2B・8B・32B と 552B だけ、実機は 3 つの方策だけを比べています。
シミュレーションの結果:向上は摂動下とデモが少ない場合に集中し、首位でない項目もある
LIBERO(表 2、各スイートの全デモで学習):ScaleVLA の 4 スイート平均は 96.1% で、Cosmos-Reason2-32B は 94.0%、Qwen3-VL-32B は 93.6%、2 つの 2B バックボーンは 90.7% と 91.2% です。Spatial と Object は飽和に近く、ScaleVLA の Spatial 98.6% は Cosmos-Reason2-8B の 99.8% を下回ります。差が出ているのは主に Goal(96.8%)と Long(90.2%)です。表の π0、OpenVLA、CoT-VLA の 3 行は既発表の結果で、同じ設定で学習し直したものではありません。
LIBERO-PRO(表 3)は上の LIBERO 方策を学習し直さずに、環境(Env.)と物体(Obj.)の摂動を加えて評価しています。
| バックボーン | Goal、Env. | Goal、Obj. | Object、Env. | 平均 |
|---|---|---|---|---|
| Qwen3-VL-2B | 24.2 | 38.4 | 25.2 | 29.3 |
| Cosmos-Reason2-2B | 20.6 | 37.6 | 11.8 | 23.3 |
| Cosmos-Reason2-8B | 32.6 | 37.6 | 23.6 | 31.3 |
| Qwen3-VL-32B | 11.6 | 44.2 | 12.6 | 22.8 |
| Cosmos-Reason2-32B | 19.2 | 38.8 | 32.4 | 30.1 |
| ScaleVLA(552B) | 47.8 | 56.4 | 31.2 | 45.1 |
どの方策も表 2 から大きく下がります。ScaleVLA の平均 45.1% は最良の密なバックボーン(Cosmos-Reason2-8B、31.3%)より約 14 ポイント高く、Goal の 2 つの摂動列でも首位です。例外は Object スイートの環境摂動で、最高は Cosmos-Reason2-32B の 32.4%、ScaleVLA は 31.2% です。密なバックボーンの中でも規模に応じて単調に上がるわけではなく、Qwen3-VL-32B の平均 22.8% は 2 つの 2B バックボーンより低くなっています。著者はこれをもとに、フロンティアモデルの特徴は学習分布の外へよりよく転移すると述べていますが、これは著者の解釈です。
RoboCasa(表 4、分布外のキッチン):タスクあたり 30 件と 100 件の生成デモで、2B〜32B のバックボーンはそれぞれ 22〜26% と 43〜46%、ScaleVLA は 30.7% と 54.9% で、差は約 5 ポイントから約 9 ポイントに広がります。DexJoCo(表 5、5 つの双腕・多指ハンドのタスクで 1 つの方策を共同学習):物体のランダム化では平均 42.1%(小さいバックボーンの最高は 38.1%)、完全ランダム化では 24.4%(同 22.1%)です。タスク別に見ると、物体のランダム化での Microwave は ScaleVLA が 73.3% で、Qwen3-VL-32B の 89.3% を下回ります。完全ランダム化での Assembly は、どのバックボーンも 1.3% 以下です。
デモ数(表 7):Goal と Long の 2 スイートで、タスクあたりのデモ数 N を 5、10、25、50 とし、全バックボーンが同じ入れ子の部分集合を使い、学習は 5,000 ステップに固定しています。2B・8B・32B はいずれも Cosmos-Reason2 です。
| N | Goal 2B | Goal 8B | Goal 32B | Goal 552B | Long 2B | Long 8B | Long 32B | Long 552B |
|---|---|---|---|---|---|---|---|---|
| 5 | 39.4 | 60.6 | 61.2 | 77.4 | 24.0 | 40.0 | 37.6 | 62.2 |
| 10 | 55.0 | 70.0 | 83.0 | 87.8 | 56.0 | 65.2 | 66.4 | 75.0 |
| 25 | 85.2 | 83.0 | 90.4 | 97.6 | 69.6 | 65.6 | 83.6 | 84.6 |
| 50 | 85.6 | 88.6 | 95.2 | 95.4 | 82.4 | 87.2 | 83.8 | 86.8 |
差が最も大きいのはデモが少ないときで、N = 5 では Goal が 39.4% から 77.4% になります。要旨の「10 件で 50 件を上回る」は、552B の N = 10 での 87.8% が 2B の N = 50 での 85.6% より高いことを指します。デモが増えると差は縮まります。N = 50 の Goal では 552B の 95.4% と 32B の 95.2% の差は 0.2 ポイントだけで、Long では 8B の 87.2% が 552B の 86.8% をわずかに上回ります。また、表 7 では 2B の N = 50 の Goal が 85.6% ですが、表 2 では同じバックボーンを全デモで学習した Goal が 83.2% です。表 7 は 5,000 ステップに固定し、表 2 は付録 A のベンチマーク別レシピを使っているので、2 つの表は学習設定が違い、数値を混ぜて使うことはできません。
遅延、ハードウェア、実機:チャンクごとには遅く、差し込みは速い
表 6 は RoboCasa での動作チャンクあたりの中央値遅延で、観測を送ってからクライアントが動作チャンクを受け取るまでを計っています(方法は付録 B にあり、本サイトは読んでいません)。そのうち 3 行を示します。
| バックボーン | GPU | トークン | バックボーン(ms) | 動作ヘッド(ms) | 合計(ms) |
|---|---|---|---|---|---|
| Cosmos-Reason2-2B | 1 | 212 | 44.7 | 67.1 | 114.7 |
| Cosmos-Reason2-32B | 1 | 212 | 68.4 | 69.0 | 140.7 |
| ScaleVLA(552B) | 4 | 568 | 140.7 | 72.1 | 215.8 |
著者報告では、ScaleVLA のパラメータは Cosmos-Reason2-2B の 276 倍で、中央値遅延は 1.9 倍です。動作ヘッドはどのバックボーンでも約 70 ms かかり、2B バックボーンでは合計の半分を超えます。バックボーンを 2B から 32B にしても増えるのは約 26 ms だけです。この 1.9 倍は H200 4 基と 1 基の比較で、入力トークン数も違います。小さいバックボーンよりハードウェアが多く要ることも著者は明記しています。読んだテキストには LIBERO と実機の制御周波数がないので、1 つの動作チャンクが何秒分に当たるかは計算できません。遅延とチャンク長から制御周波数の上限を求める方法は フィジカルAIラボ 2.6 で計算しました。
実機のタスクは RoboDojo の Plug In Charger です。右腕がスマートフォンの充電器をつかんで受け渡し、左腕がプラグを電源タップのソケットに合わせて差し込み、放します。観測は上部カメラ 1 台と手首カメラ 2 台です。学習データは遠隔操作による完全なデモと、差し込み段階に絞ったセグメントで、デモの大半は基準となる充電器の位置の近くから始まります。3 つの方策は同じ動作 DiT、学習データ、学習予算を使い、違いはバックボーン(Cosmos-Reason2-2B、π0.5、ScaleVLA)だけです。π0.5 の VLM は π0.5 の一部として大規模なロボットデータで学習されており、著者はこれを使って、小さいバックボーンのロボット事前学習でフロンティア規模の特徴を代替できるかを確かめています。プラグが差し込まれ、左のグリッパーが放したら成功です。各方策はドメイン内試行 10 回(主な学習位置の近くから開始)と分布外試行 15 回(充電器を平行移動または回転させるか、電源タップを学習時の大半の配置の外へ動かす)を行います。結果は論文の表 8 にあります。
| 方策 | ドメイン内の成功 | 分布外の成功 | 差し込みの中央値時間(s) | 完了の中央値時間(s) | チャンクごとの往復中央値遅延(ms) |
|---|---|---|---|---|---|
| Cosmos-Reason2-2B + 動作ヘッド | 4/10 | 5/15 | 85.9 | 147.1 | 311 |
| π0.5 + 動作ヘッド | 8/10 | 7/15 | 81.2 | 132.0 | 262 |
| ScaleVLA(552B) | 9/10 | 8/15 | 58.1 | 114.4 | 384 |
著者報告では、ドメイン内の失敗はすべて差し込み段階で起き、成功した試行では把持と受け渡しにかかる時間は 3 方策でほぼ同じでした。ScaleVLA は往復遅延が最も大きい(384 ms)にもかかわらず完了時間は最短で、中央値 114.4 s は π0.5 + 動作ヘッドの 132.0 s より 13% 短く、主な理由は差し込みが 28% 速いことです。2B の方策は腕のすき間が足りず何度も安全停止しましたが、ScaleVLA は全試行で一度もありませんでした。読んだテキストに停止の回数はありません。時間の列は成功したドメイン内試行だけを数えているので、2B の方策の中央値はわずか 4 回分、ScaleVLA は 9 回分から求めたものです。
論文に区間はありません。本サイトが フィジカルAIラボ 2.8 の Wilson の式で 95% 区間を計算すると、9/10 は 59.6%〜98.2%、4/10 は 16.8%〜68.7% で、59.6%〜68.7% の範囲で重なります。区間が重なること自体は検定ではありませんが、10 回の試行では差の大きさを精度よく見積もれないことがわかります。ScaleVLA と π0.5 + 動作ヘッドの間では、ドメイン内の 9/10 対 8/10、分布外の 8/15 対 7/15 のどちらも差は 1 回です。
制約と注意点
- arXiv のプレプリントで、数値はすべて著者報告 [R] です。本サイトは再現していません。付録 A〜C は読んでおらず、学習レシピ、計時方法、評価設定、実機の 2 つのバックボーンの検証用動作誤差は付録にあります。
- 読んだ表のどれにも、標準偏差、信頼区間、学習シード数がありません。実機は方策ごとにドメイン内 10 回、分布外 15 回だけです。
- 「2B から 552B へ」の変更では、モデルファミリー(DeepSeek モデルは 1 つだけ)、密な構造か混合エキスパートか、推論 GPU 数(4 基対 1 基)、入力トークン数(568 対 212)も同時に変わっています。それぞれの寄与を論文は切り分けていません。
- バックボーンは最後まで凍結したままで、結論は因果エンコーダから読み出した凍結特徴についてのものです。読んだテキストでは、バックボーンを微調整した場合は試していません。
- すべての項目で向上しているわけではありません。LIBERO-PRO の Object 環境摂動、DexJoCo の Microwave、デモ数 N = 50 での LIBERO-Long では、小さいバックボーンが同等かそれ以上です。
- 216 ms は RoboCasa のシミュレーションで H200 4 基を使ったときの中央値遅延で、実機での往復中央値遅延は 384 ms です。論文はプロジェクトページを示していますが、本サイトは開いておらず、コードと重みが公開されているか、ライセンスが何かは確認していません。
リンク
- ScaleVLA: Scaling Vision-Language-Action Models to 552 Billion Parameters(arXiv 2611.21607)
- 論文の HTML 全文
- フィジカルAIラボ 3.1:VLA を分解する――コップを置く動作を 256 区間のトークンに直し、三つのモデルのパラメータ数と周波数の範囲を確かめる
- フィジカルAIラボ 3.5:GR00T ファインチューニング実践――ファインチューニングのコマンドと modality の配線図を一項目ずつ確かめ、CPU の代役実験でオープンループ誤差とクローズドループ成功率を分ける
- フィジカルAIラボ 2.6:エッジへ――遅延のログから制御周波数の上限を求め、量子化で減るのが容量か時間かを見分け、動作チャンクの長さを決める
- フィジカルAIラボ 2.8:再現できる評価――Wald 区間と Wilson 区間を手で計算し、1/√n から評価回数を決め、失敗ゼロのあとの失敗率の上限を求める
- フロンティア・レーダー|One Policy for 100 Household Tasks:1 つの π0.5 チェックポイントで 100 の家事タスクを扱い、14 タスクは事前に練習した GPT-6 Astra に任せる――著者報告で Q 0.639 対 0.108
- フィジカルAIラボ:すべての数字を確認できるフィジカルAI講座


