
北京航空航天大学牵头、新加坡国立大学与香港中文大学 MMLab 的作者参与的预印本 UAV-Flow++(arXiv 2611.17163,2026-11-12)研究这样一个无人机问题:收到“从左侧经过那棵树”这类简短指令后,策略直接根据机载画面和当前状态输出连续飞行动作,完成一段短程机动。作者认为,现有的语言引导无人机研究多做长距离航线规划,这类相对物体的短程动作研究较少。论文发布了 30,692 条专业飞手的真机示范、一个能自动打分的仿真闭环评测环境 UAV-Flow-Sim,以及一个先模仿、再在仿真里用强化学习后训练的策略 FlowVLA。作者报告,在 273 个留出的仿真回合上,FlowVLA 预训练后成功率为 75.58%,经 TGRPO 后训练升到 93.16%。以下数字均为作者报告 [R],本站没有运行作者的代码,也没有下载数据。
任务:一句指令,一段短程机动
作者把任务称为 Flying-on-a-Word(Flow)。每个时间步,策略拿到三样输入:自然语言指令、以本回合起点为原点的局部坐标系中的无人机 6 自由度状态、机载第一人称画面;输出是局部坐标系中的目标位姿或“位置 + 偏航角”指令,可以再映射到具体机型的飞控。任务考两种能力。一是理解动作意图,例如朝某个方向平移、转过一定角度、上升、悬停或降落。二是把指令里的空间关系落到画面上,例如接近一辆车、从指定一侧经过某个物体、在地标旁停下。指令因此分成两类:基本动作指令和与物体交互的指令。
论文表 1 把它与此前的语言引导无人机基准并列:AVDN、AerialVLN、CityNav、OpenUAV、OpenFly、IndoorUAV、HUGE-Bench 的数据都来自仿真,任务多是长程导航或目标导向导航;UAV-Flow 是仿真加真机,连续 6 自由度动作,约 40K 条轨迹,任务粒度是短程执行。作者写道,UAV-Flow 中大多数轨迹不到 20 米。这篇是作者会议版本 UAVFlow 的扩展,新增了自动任务级评分、混合数据预训练加在线 RL 后训练,以及更完整的对比与消融。
数据:真机示范与仿真轨迹
真机数据在三所大学校园采集,覆盖 5.02 km²,场景里有行人、车辆、植被、建筑、道路、空地和地标。飞手持有执照,每人飞行经验超过 800 小时,使用 DJI Mavic 3T RTK 等商用机型,配 4K 相机和 RTK GPS,轨迹精度为厘米级。飞手只看机载画面执行指令,所以录下的画面与部署时策略能看到的输入一致;同一条指令从多个起点和朝向执行,同一意图因此有多条不同轨迹。视频与飞行日志按时间戳对齐,每帧插值出对应的 6 自由度状态,再换算到以起点为原点、朝向相对初始航向的局部坐标系,按 5 Hz 采样。标注员先剔除行为含糊、执行不安全、空间关系不清或语义不一致的片段,再按一套固定指令集给出规范标签,并用大语言模型改写出开放词表的说法。最终得到 30,692 条轨迹,分 8 类主要动作。
UAV-Flow-Sim 建在一个校园场景里,用 UnrealCV 渲染和控制,控制接口是“位置 + 偏航角”,场景中有静态地标,以及人、车辆、四足机器人等可交互物体。10,109 条仿真轨迹一部分由人工驾驶,固定机动则由规则脚本借助仿真器的特权信息(无人机状态与物体位置)生成。两边的动作分布不同(论文表 2):真机数据中“接近”和“穿过”最多,分别占 28.1% 和 28.4%;仿真数据中“平移”和“接近”最多,分别占 29.4% 和 25.6%;真机有 3.2k 条悬停轨迹,仿真数据里没有悬停。
预训练并没有用上全部真机数据:作者按任务均衡和轨迹质量选了 9,766 条真机轨迹,加上 10,109 条仿真轨迹,共 19,875 条、946,607 帧。按本站计算,这约是真机数据的三分之一(9,766 ÷ 30,692 ≈ 0.32)。
仿真评测怎样打分
闭环评测时,仿真器每步把当前画面和状态交给策略,执行策略给出的动作,再返回下一帧;回合在任务完成、碰撞、违反安全约束或超出步数上限时结束,仿真器记录完整轨迹、终止状态、物体关系和碰撞事件。每个回合按任务类型 k 得到一个完成度分数 C_k = C_proc + C_goal,取值在 0 到 1 之间:前一项看机动过程,例如“穿过”任务是否真的经过了指定物体或区域;后一项看终止状态,例如是否停在目标位置。涉及距离或角度的项用截断区间分数 Φ(d, Δ, w) = max(0, w − 0.1⌈d/Δ⌉),d 是误差,Δ 是每扣 0.1 分对应的误差区间,w 是这一项的满分。
本站读到的正文没有给出各任务的 w 与 Δ。用一组假想值算一次:设 w = 0.5、Δ = 0.5 m,终点误差 d = 1.2 m,则 ⌈1.2/0.5⌉ = ⌈2.4⌉ = 3,得分 0.5 − 0.3 = 0.2;误差超过 2.0 m 时这一项为 0;只要误差大于 0,至少扣 0.1。这组数字只用来说明公式,不是论文的设置。
论文报告三个指标:成功率(SR,所有适用的完成条件都满足才算成功)、完成度分数(CS)和归一化动态时间规整(NDTW,执行轨迹与参考轨迹的相似度,每个轨迹点由位置和滚转、偏航、俯仰三个角的余弦组成)。测试集是 273 个人工标注的回合,每个回合给定初始状态、指令、参考轨迹和完成条件。需要注意,这些测试回合与采集仿真示范用的是同一个校园场景,RL 后训练也在这个仿真器里进行;“留出”是回合层面的,不是换了场景。
FlowVLA 与 TGRPO:先模仿,再按组内奖励分布加权
FlowVLA 由预训练的 Qwen3-VL 主干和一个轻量的离散动作头组成。输入是本回合第一帧画面、当前画面,以及写成文本、拼在指令后的状态 (x, y, z, 偏航角)。模型一次预测 10 步“位置 + 偏航角”动作,4 个维度各分 256 个区间;数据按 5 Hz 采样,所以一个动作块覆盖 2 秒。预训练用 LoRA 微调 VLM,动作头用交叉熵训练,在 8 块 NVIDIA L40 上训练 80,000 步。
作者给出的后训练理由是:模仿只覆盖专家轨迹附近的状态,闭环执行中的偏差会把策略带到示范分布之外,误差累积。物理AI实验室 1.6 手算过这种误差怎样滚出示范覆盖范围。RL 阶段在 SimpleVLA-RL 框架里进行,只训练“穿过”“旋转”“降落”“接近”四类任务,每类 204 条训练轨迹,共 90 次策略更新;每轮在 16 个并行任务配置上各采 8 条闭环轨迹(共 128 条),采样温度 1.6,每条最多与仿真器交互 100 次;奖励是回合结束时的完成度分数;评测时用贪心解码。
标准 GRPO 把组内奖励减去均值、除以标准差作为优势。TGRPO 沿用 TailRL 的阈值加权:把组内奖励从小到大排成 r(1) ≤ … ≤ r(G),并令 r(0) = 0,权重 ω(r(i)) = Σ_{ℓ=1..i} (r(ℓ) − r(ℓ−1)) / (G − ℓ + 1),再减去组内均值、乘以组大小 G 得到任务优势。分母是“奖励超过这一段的轨迹数”,越少轨迹能达到的奖励区间,权重越大。之后还要减去按组居中的参考策略 KL 惩罚,并沿用 GRPO 的截断目标。
用一个假想的组看区别(G = 4,奖励等间隔,不计 KL 项):
| 轨迹 | 奖励(完成度) | GRPO 优势(按总体标准差 0.224) | TGRPO 任务优势 |
|---|---|---|---|
| a | 0.4 | −1.34 | −0.60 |
| b | 0.6 | −0.45 | −0.33 |
| c | 0.8 | +0.45 | +0.07 |
| d | 1.0 | +1.34 | +0.87 |
TGRPO 一列的算法:ω 依次为 0.4/4 = 0.10、0.10 + 0.2/3 ≈ 0.17、0.17 + 0.2/2 ≈ 0.27、0.27 + 0.2/1 ≈ 0.47,均值 0.25,各自减去均值再乘以 4,得到表中的值。GRPO 的优势关于均值对称,无论用总体还是样本标准差都是如此;TGRPO 下,奖励同样相差 0.2,c 与 d 之间的优势差是 0.80,a 与 b 之间只有约 0.27,奖励高于组均值(0.7)的 c 也只拿到很小的正优势。这就是作者说的“更重地强化少数高奖励轨迹”。表中数字是本站按论文公式算的练习,不是论文数据。RL 后训练的一般证据怎样读,见 物理AI实验室 3.3。
结果:表 3 里哪些比较是同条件的
论文表 3 的总体结果如下(273 个测试回合,三次评测的均值;只有 FlowVLA 三行给出标准差):
| 方法 | 训练数据 | 总体 SR(%) | 总体 NDTW |
|---|---|---|---|
| TravelUAV | 仿真示范 | 56.78 | 0.237 |
| OpenVLA-UAV | 仿真示范 | 53.85 | 0.345 |
| π0-UAV | 仿真示范 | 68.86 | 0.431 |
| MemoryVLA-UAV | 仿真示范 | 62.64 | 0.342 |
| π0.5-UAV | 仿真示范 | 66.67 | 0.398 |
| FlowVLA(预训练) | 真机 + 仿真示范 | 75.58 ± 1.12 | 0.402 ± 0.006 |
| FlowVLA-GRPO | 同上,再做 RL 后训练 | 92.06 ± 0.56 | 0.434 ± 0.005 |
| FlowVLA-TGRPO | 同上,再做 RL 后训练 | 93.16 ± 0.42 | 0.424 ± 0.008 |
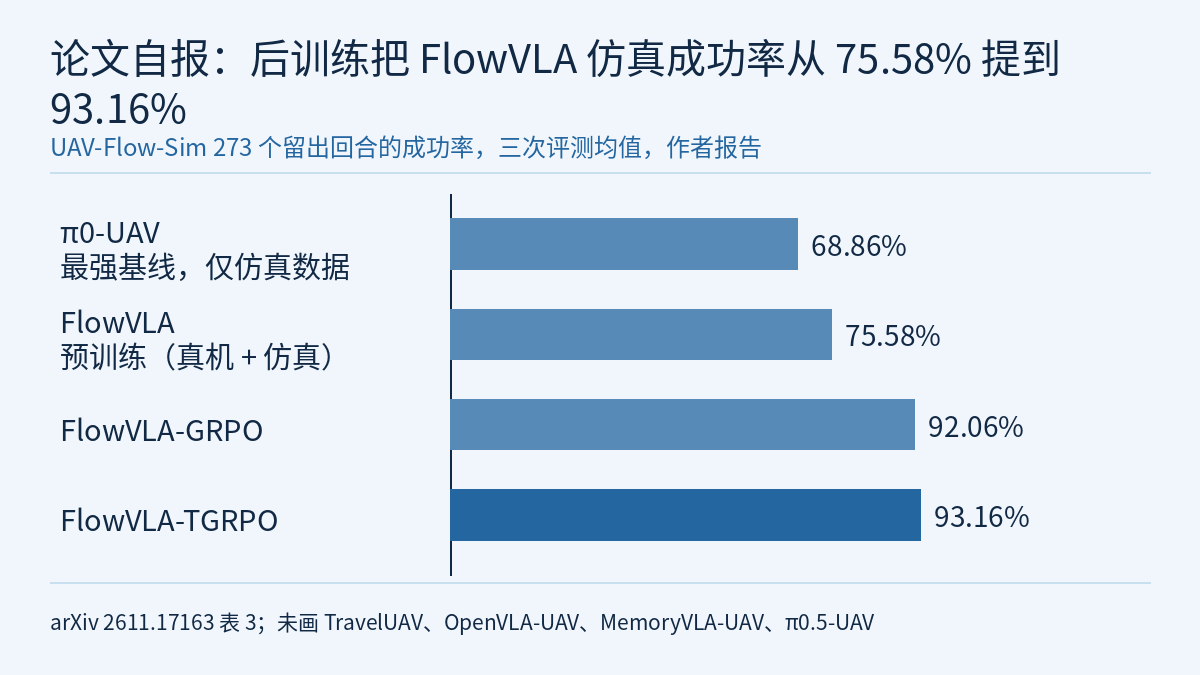
本文的条形图画出其中四行的总体成功率:π0-UAV 68.86%、FlowVLA 预训练 75.58%、FlowVLA-GRPO 92.06%、FlowVLA-TGRPO 93.16%。读这张表有几处要分开看:
- 预训练 FlowVLA 与基线的数据不同。五个基线都只用同一批仿真示范做模仿学习(VLM 部分用 LoRA 微调),动作统一换成局部“位置 + 偏航角”指令,由同一个仿真侧控制器执行;FlowVLA 多用了真机示范。作者报告的 6.72 个百分点优势因此包含数据差别。消融表 5 里只用仿真数据的 FlowVLA 为 73.14 ± 0.56%,按本站计算仍比 π0-UAV 高 4.28 个百分点,但这个差距里还有模型结构的差别。加入真机示范带来 2.44 个百分点(73.14% → 75.58%),而评测本身全在仿真里。
- 成功率高,轨迹相似度不一定高。预训练 FlowVLA 的 NDTW 为 0.402,低于 π0-UAV 的 0.431。分任务看,它在“旋转”上只有 24.44%,π0.5-UAV 为 66.67%;“穿过”为 55.00%,低于 MemoryVLA-UAV 的 62.50%。
- 后训练的增益是同一初始化下的比较,幅度远大于报告的波动。从 75.58% 到 GRPO 的 92.06%、TGRPO 的 93.16%,分别提高 16.48(本站计算)和 17.58 个百分点;“旋转”两者都到 100%。大幅提升出现在 RL 训练过的四类任务上,测试也在同一个仿真场景里。
- TGRPO 只比 GRPO 高 1.10 个百分点。TGRPO 与 GRPO 的标准差分别为 0.42 和 0.56,来自三次评测。本站读到的正文没有说明贪心解码下三次评测之间改变了什么,也没有报告多个训练种子。NDTW 反而是 GRPO 更高(0.434 对 0.424)。作者另据图 6 报告,TGRPO 在约 40 次更新后总体 SR 超过 90%,GRPO 约需 80 次;“样本效率更高”的说法来自这一组训练曲线。
- 未参加 RL 的任务有回落。作者报告,GRPO 在其余任务上先降后回到接近预训练水平;TGRPO 在训练后期其余任务的平均 SR 略有下降,降幅小于 GDPO 和 DAPO。同一初始化下比较的其他算法总体 SR 为 DAPO 82.91%、GSPO 89.13%、GDPO 89.87%。作者推测 DAPO 和 GSPO 后期变差可能部分与不使用参考策略 KL 正则有关;本站读到的正文没有单独检验这一点。
- 结构消融方面,把离散动作头换成 FAST 头,SR 降到 64.10%;融合 Qwen3-VL 全部层的特征为 76.19%,只比只用最后一层高 0.61 个百分点,作者因此保留最后一层作为 RL 的初始化。
真机部署:地面站推理,按时延跳过过期航点
机载算力有限,VLA 推理放在地面站。无人机通过无线链路回传画面和状态,地面站生成动作块、换算成航点后发回机载飞控执行。无人机在推理期间继续飞,返回的动作块前几个航点可能已经过时,所以执行层按从拍图到发令的实测时延 δ 和航点执行频率 f_c,跳过前 m = min(H − 1, ⌈δ·f_c⌉) 个航点。
本站读到的正文没有给出 δ 和 f_c 的实测值。用假想值算:H = 10(论文设置),若 f_c 取 5 Hz、δ = 0.35 s,则 ⌈1.75⌉ = 2,跳过前 2 个航点,从第 3 个开始执行;若 δ = 2.5 s,⌈12.5⌉ = 13,被 H − 1 截到 9,只剩最后一个航点。按 5 Hz 一个动作块只覆盖 2 秒,时延一旦接近这个长度,跳点也补不回来。动作块长度与时延的关系,物理AI实验室 2.6 有一套手算练习。
真机部分是定性展示:室外的图 7 用的是 π0-UAV(从左侧经过一棵树、接近一块标牌的右侧),室内的图 8 用的是 FlowVLA(顺时针绕树、从左侧经过一块标牌)。本站读到的正文没有报告真机试验次数或成功率;摘要里“稳健执行”和正文里“印证仿真定量评测”是作者的描述。作者在结论中承认,当前的高频闭环控制依赖地面站算力和无线通信,存在时延风险,也限制了机上自主;后续计划做模型压缩和机载推理。本站此前介绍过另一条无人机路线:事件相机四旋翼避障,那篇的策略从事件帧直接输出加速度,不涉及语言指令。
局限 / 注意
- 这是 arXiv 预印本,全部数字为作者报告 [R]。本站没有运行代码、下载数据或复核表格;本站读到的 HTML 正文止于结论一节,可能有未读到的附录。
- 闭环成功率全部来自 UAV-Flow-Sim 的同一个校园场景,RL 后训练也在这个场景里完成;没有换场景或真机的定量成功率。
- 基线只用仿真示范训练,FlowVLA 多用了真机示范,二者的预训练对比不是同数据比较。
- TGRPO 相对 GRPO 的 1.10 个百分点来自三次评测的统计;本站读到的正文没有多训练种子的结果,NDTW 方向相反。
- RL 只覆盖四类任务,作者报告其余任务后期有小幅回落。
- 真机演示是定性的,室外演示用的是基线 π0-UAV。仿真结果和这些演示都不是飞行安全验证,也不代表在其他机型、空域或天气下可用。
- 文中两组假想计算(截断区间分数和跳点数)以及 TGRPO 优势小表是本站的练习,不是论文数据。
链接
- UAV-Flow++: A Unified Suite for Benchmarking and Learning Language-Guided UAV Flight(arXiv 2611.17163)
- 论文 HTML 全文
- 项目主页(论文所列)
- 代码仓库 buaa-colalab/UAV-Flow(论文所列)
- Hugging Face 数据集 wangxiangyu0814/UAV-Flow(论文所列)
- 物理AI实验室:一套每个数字都能核对的物理 AI 课程(课程大纲)
- 物理AI实验室 1.6:模仿学习,手算误差怎样滚出示范覆盖范围,再把 ACT、扩散策略与数据规模律的数字放回各自条件
- 物理AI实验室 2.6:上边缘,从时延日志算出控制频率上限,分清量化省下的是体积还是时间,再给动作块定长度
- 物理AI实验室 3.3:RL 后训练,把 HIL-SERL 的“2 倍”和 RECAP 的“吞吐翻倍”放回各自条件,再复算三颗种子的配对区间
- 前沿雷达|事件相机四旋翼避障:把 CUDA 事件模拟器放进可微仿真,策略从事件帧直接输出加速度


