
事件相机的每个像素独立工作,只在对数亮度的变化超过阈值时输出一个事件,因此延迟低于毫秒、动态范围高、几乎没有运动模糊,适合高速飞行。难点在于把它接进闭环控制:真实事件数据难以大量采集,而现有的事件模拟器又慢。苏黎世大学 Robotics and Perception Group 的预印本(arXiv 2610.38967,2026-10-28)把一个 CUDA 事件模拟器放进可微仿真的训练循环,训练出从事件帧直接输出加速度指令的四旋翼避障策略,中间不做深度估计。作者报告:在一块 RTX 5060 笔记本 GPU 上约 3 小时收敛,并零样本部署到真机。真机实验只有一个室内场景和一个静止障碍,表中记录的飞行共 11 次。以下数字均为作者报告 [R],本站未复现。
两条已有路线的代价
论文把相关工作分成两类,并分别指出代价:
- 级联架构(Bhattacharya 等):感知网络先从事件流预测深度,再由一个速度预测器把深度映射为控制指令。控制效果取决于中间深度估计的准确度,深度误差会传到控制输出。
- 端到端但先离线预训练(Messikommer 等,近似模仿学习):先离线渲染事件、学一个面向任务的事件表示空间,再在线微调动作解码器。按本文的说法,离线阶段在 200 小时量级,之后才能开始在线微调。
作者还认为,用 PPO 这类无模型强化学习从事件这种高维视觉输入学策略样本效率很低。他们的做法是两件事一起改:让事件生成足够快,能放进训练循环;再用可微仿真让梯度直接穿过动力学模型,提高样本效率。
事件模拟器:只渲染障碍的边界
模拟器不追求照片级画面,而是抓住避障真正需要的信号:相机运动时,障碍物的边界在图像上移动,引起亮度变化、触发事件。具体做法:
- 障碍物用简单几何体近似(球、体素、竖直和水平圆柱),每个障碍赋一个随机采样的均匀灰度。这些几何体与光线的交点有闭式解,每个像素可以在 GPU 上独立并行地做光线投射,像素取最近交点的灰度,遮挡关系得以保留。
- 事件按控制步生成:比较相邻两个控制步渲染的灰度帧,差值大于对比阈值 C 记为 +1,小于 −C 记为 −1,否则为 0。论文称这是对逐像素亮度变化的快速近似。
- 渲染分辨率只有 64 × 48。部署时,640 × 480 的真实事件帧被降采样到同一分辨率,作者认为这相当于隐式低通滤波,能压掉传感器噪声和与任务无关的细节。
- 为缩小 sim-to-real 差距,模拟器用 Kannala-Brandt 鱼眼模型加入镜头畸变,系数由标定真实相机得到;正负阈值在每个仿真步从截断高斯分布中独立重采样,并在一小部分像素上随机触发与边缘无关的背景噪声事件。
效率对比的条件是:64 × 48 针孔相机视角,场景中随机放置 200 个障碍,相机轨迹按 15 Hz 采样,并行环境数 N 从 1 到 256,全部在同一块 RTX 5060 笔记本 GPU 上测量。N = 128 时,作者的模拟器达到每秒 60,248 个环境步,ESIM(OpenGL 渲染器加 CPU 事件生成核心)为每秒 4,249 步,约 14 倍;此时它占用 138 MB GPU 显存,ESIM 的主机内存占用为 656 MB。作者还测了一个自家模拟器的多线程纯 CPU 实现,正文没有给出它的数字。
可微仿真怎样训练策略
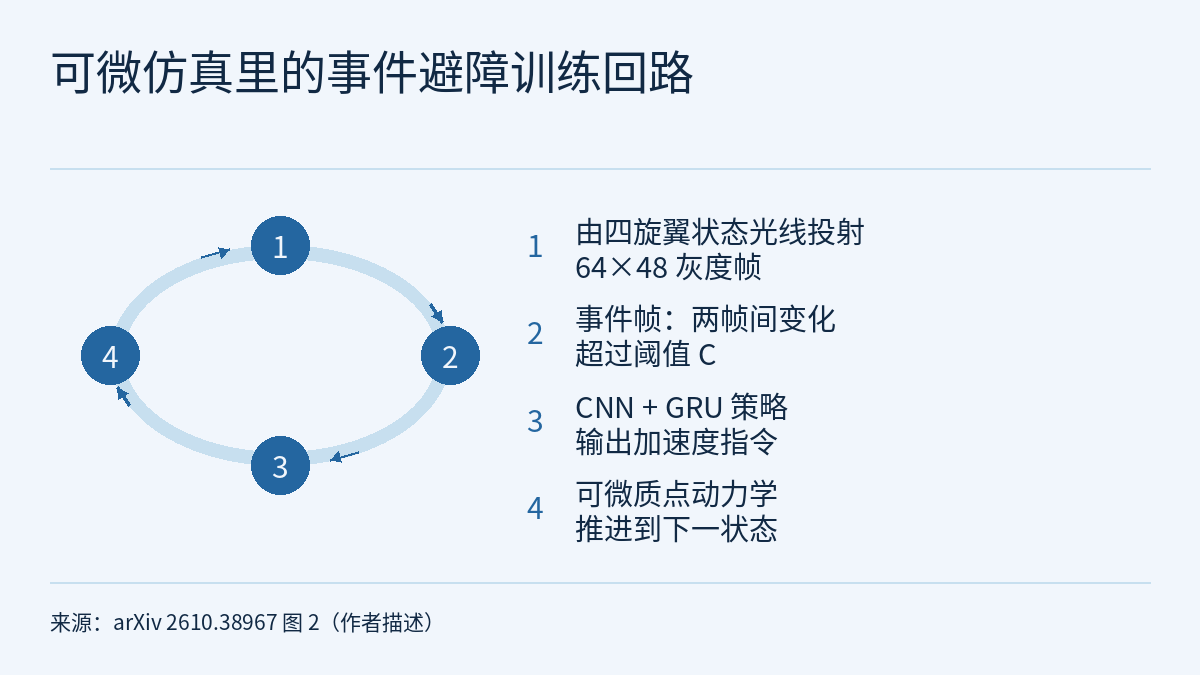
训练回路见论文图 2:由四旋翼状态渲染灰度帧,相邻两帧算出事件帧;策略(CNN 编码器加 GRU)输出加速度;可微的质点动力学把状态推进一步;由状态和动作算损失,梯度沿整条回路反传(时间反向传播,带时间梯度衰减 α = 0.4)。动力学没有用完整的四旋翼模型,而是沿用 Zhang 等(DiffAgile)的做法,用质点近似。
损失由五项加权组成:
- 速度跟踪:2 秒滑动平均速度与目标速度之差,用 Smooth L1,权重 1.0;
- 速度估计:网络自估速度与仿真真值的均方误差,权重 100,供无里程计设定使用;
- 避障:二次障碍间隙项(按接近障碍的相对速度缩放)加 softplus 碰撞惩罚(β1 = 2.5,β2 = 32),权重 3.0;
- 加速度和 jerk 正则,权重 0.01 和 0.001,抑制激进或振荡的指令。
网络很小:事件帧先平均池化到 16 × 12,经过 32、64、128 个滤波器的三层卷积,投影成 192 维;状态和目标速度也投影到 192 维后相加,送入 GRU,最后一个全连接层输出 6 个数(加速度指令和速度估计)。有里程计时,状态包括姿态和速度;无里程计时只有姿态,速度相关信息要从事件历史中推断。
每次迭代采 128 条轨迹、每条 150 步,控制间隔 1/15 s,约 3 小时收敛,不需要单独的离线事件生成和表示预训练阶段。图 5 显示,有里程计的策略收敛更快、最终平均速度更高。换成 96 × 72 分辨率,训练时间约为两倍,训练损失和平均速度只有小幅改善。
物理AI实验室 1.4 的视频在介绍 Newton 时提到“让仿真可以求导,方便学习”;这篇论文给出了一个具体用法,但它用的是自己的 CUDA 模拟器和质点模型,与 Newton 无关。
“零样本”之前,哪些量来自真机
“零样本部署”指策略没有用真机数据训练或微调,并不等于训练中没有用到真机测量。论文里至少有三处真机信息:
- 镜头畸变系数来自对真实相机的标定;
- 飞控响应在仿真里建模为一阶系统,延迟系数通过在真机平台上做系统辨识得到;
- 真实事件流先按 1/15 s 窗口逐像素多数表决聚合成 640 × 480 的事件帧,再按 10 × 10 块聚合并阈值化,降到 64 × 48,与模拟器的表示对齐。
同时,障碍灰度在仿真中随机采样,事件阈值每步重采样,另加随机背景噪声。物理AI实验室 2.5 讲过 sim2real 里系统辨识与域随机化常常配合使用;这篇论文是一个实例:镜头和飞控延迟这类可测的量靠标定和辨识,事件相机的噪声靠随机阈值和背景噪声来模拟。
上真机前,作者另做了一个离线检查:用与策略结构相近的 CNN 加 GRU 速度估计器,只用仿真事件训练,再在公开的 UZH-FPV Drone Racing Dataset 的两段真实序列上测试。论文称预测速度紧跟真值的变化趋势,但正文没有给出误差数字。
真机结果与基线对比
真机配一台 DVXplorer Micro 事件相机(640 × 480,动态范围最高 110 dB,亚毫秒延迟),在 Jetson Orin NX 上以固定 15 Hz 推理。策略输出的加速度被转换成总推力和角速度设定值,由机上的底层姿态控制器跟踪。物理AI实验室 1.3 讲的彩色相机、深度、力与触觉、本体感觉四类传感器里没有事件相机,这里的输入是另一种成像方式。
| 设定 | 状态输入 | 成功 / 总次数(表 I) |
|---|---|---|
| 有里程计 | 姿态和速度 | 7 / 8 |
| 无里程计 | 只有姿态 | 3 / 3 |
实验在一个室内环境中进行,只有一个静止障碍;四旋翼按目标速度飞向障碍另一侧的目标点,各次试验的光照、里程计条件和障碍位置有变化。作者另在照度低至 5.8 lux 的极暗条件下测试,称表现不受影响,并把这归因于事件相机的高动态范围。正文没有说明低光飞行的次数,也没有说明它们是否计入表 I。
基线对比没有在真机上进行。作者引用了深度方法 DiffAgile 已报告的结果(图 8,仿真环境中的成功率与平均速度),称事件策略在低速时落后于 DiffAgile,在较高的测试速度下一度接近;作者的解释是低速运动触发的事件少,策略得到的感知信息也少。正文没有给出图 8 的具体数值。作者还写明,没有直接比较自己方法与 PPO 的样本效率;关于事件相机在真实低光场景可能更有优势的说法,作者也承认这在仿真对比中没有体现。
局限 / 注意
- 这是 arXiv 预印本,数字均为作者报告 [R],本站未复现。本站读的是论文 HTML 正文;正文没有提到代码或模拟器是否公开。
- 真机证据很窄:一个室内环境、一个静止障碍、表 I 共 11 次飞行(7/8 与 3/3)。正文没有给出真机飞行速度;按本站判断,3 次无里程计飞行不足以估计可靠的成功率。
- 约 14 倍的吞吐量只对应 64 × 48、N = 128、200 个障碍、RTX 5060 笔记本 GPU 这组条件;三者渲染的是同一场景,但 ESIM 按亮度变化率或像素位移自适应地决定何时渲染新帧,作者的模拟器每个控制步只对两帧做差,两者输出的事件并不等价(本站据论文第 II-A 与 III-B 节判断)。
- 事件帧是按控制周期对两帧做差得到的近似,真机端也按 1/15 s 窗口聚合,没有保留窗口内事件的时间顺序(本站据方法描述判断)。
- 与 DiffAgile 的对比用的是对方已报告的结果,并且在仿真中进行;UZH-FPV 上的速度估计检查只有两段序列,正文给出的是定性描述。
- 作者写明的局限:模拟器不建模障碍表面纹理,可能造成 sim-to-real 差距;框架只考虑静止障碍,动态障碍留待以后。
- 仿真训练和少量室内飞行都不是飞行安全验证。


