
イベントカメラは画素ごとに独立して動作し、対数輝度の変化がしきい値を超えたときだけイベントを出力します。そのため遅延は 1 ミリ秒未満、ダイナミックレンジが広く、モーションブラーはほとんどなく、高速飛行に向いています。難しいのは、これを閉ループ制御に組み込むことです。実際のイベントデータは大量に集めにくく、既存のイベントシミュレータは低速です。チューリッヒ大学 Robotics and Perception Group のプレプリント(arXiv 2610.38967、2026-10-28)は、CUDA で実装したイベントシミュレータを微分可能シミュレーションの学習ループに組み込み、イベントフレームから加速度指令を直接出力するクアッドロータの障害物回避方策を学習しました。途中で深度は推定しません。著者の報告では、RTX 5060 搭載のノート PC の GPU で約 3 時間で収束し、実機へゼロショットで展開できました。実機実験は屋内の 1 シーン、静止障害物 1 つだけで、表に記録された飛行は合計 11 回です。以下の数値はすべて著者報告 [R] で、本サイトでは再現していません。
既存の 2 つのアプローチのコスト
論文は関連研究を 2 つに分け、それぞれのコストを挙げています。
- カスケード構成(Bhattacharya ら):知覚ネットワークがまずイベントストリームから深度を予測し、別の速度予測器がその深度を制御指令に変換します。制御性能は中間の深度推定の精度に左右され、深度の誤差が制御出力に伝わります。
- エンドツーエンドだが、先にオフライン事前学習(Messikommer ら、近似模倣学習):オフラインでイベントをレンダリングしてタスク固有のイベント表現空間を学び、その後オンラインで行動デコーダを微調整します。本論文によれば、オフライン段階に 200 時間のオーダーがかかり、それが終わるまでオンライン微調整を始められません。
著者はさらに、PPO のようなモデルフリー強化学習でイベントのような高次元の視覚入力から方策を学ぶのはサンプル効率が悪いと述べています。そこで 2 点を同時に変えました。イベント生成を学習ループに入れられるほど速くすること、そして微分可能シミュレーションで勾配をダイナミクスモデルに直接通し、サンプル効率を上げることです。
イベントシミュレータ:障害物の境界だけを描く
このシミュレータはフォトリアルな画像を目指さず、障害物回避に必要な信号だけを残します。カメラが動くと障害物の境界が画像上を移動し、輝度が変わってイベントが発生します。具体的には次のとおりです。
- 障害物は単純な幾何形状(球、ボクセル、垂直・水平の円柱)で近似し、障害物ごとにランダムに選んだ一様な濃淡値を割り当てます。これらの形状と光線の交点は閉形式で求まるので、各画素のレイキャストを GPU 上で独立に並列実行できます。画素には最も近い交点の濃淡値が入り、遮蔽関係は保たれます。
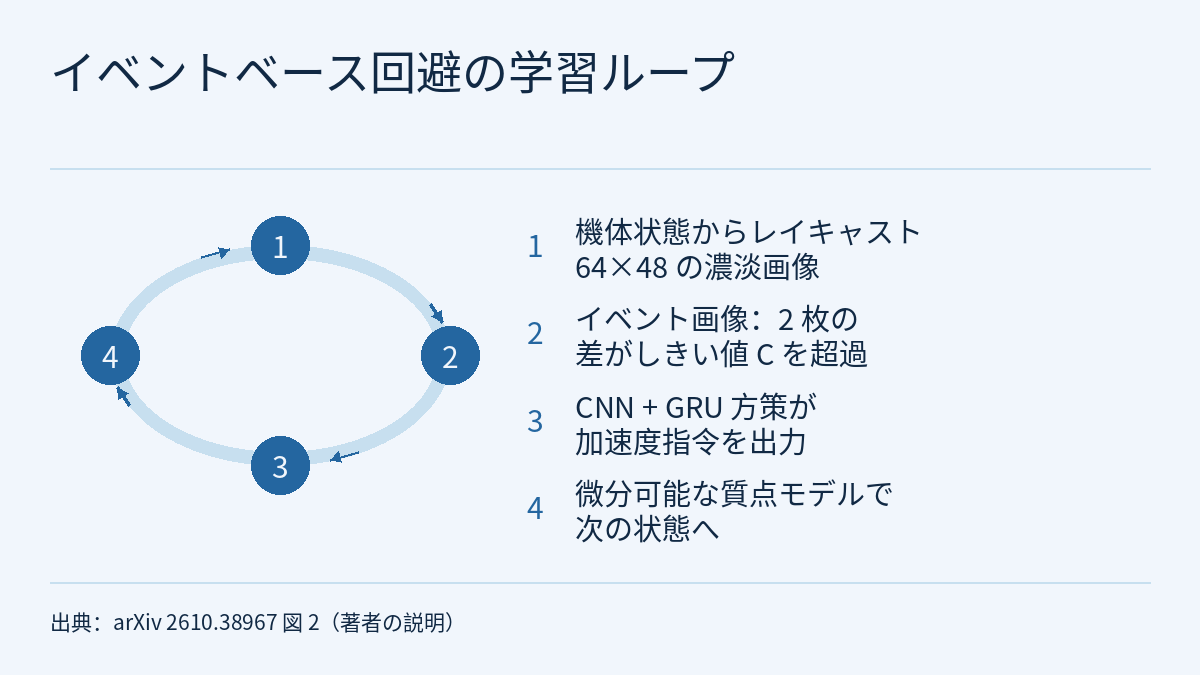
- イベントは制御ステップごとに生成します。連続する 2 つの制御ステップで描いた濃淡画像を比べ、差がコントラストしきい値 C を超えれば +1、−C を下回れば −1、それ以外は 0 とします。論文はこれを画素ごとの輝度変化の高速な近似と位置づけています。
- レンダリング解像度は 64 × 48 にすぎません。実機では 640 × 480 のイベントフレームを同じ解像度へダウンサンプリングします。著者は、これが暗黙のローパスフィルタとして働き、センサノイズやタスクに無関係な細部を抑えると述べています。
- sim-to-real ギャップを縮めるため、Kannala-Brandt 魚眼モデルでレンズ歪みを加えます。係数は実カメラのキャリブレーションで得たものです。正負のしきい値は各シミュレーションステップで切断ガウス分布から独立に再サンプリングし、さらに一部の画素で、エッジと無関係な背景ノイズのイベントをランダムに発生させます。
効率比較の条件は、64 × 48 のピンホールカメラ視点、ランダムに配置した障害物 200 個のシーン、15 Hz でサンプリングしたカメラ軌道、並列環境数 N = 1〜256 で、すべて同じ RTX 5060 搭載ノート PC の GPU で測定しています。N = 128 のとき、著者のシミュレータは毎秒 60,248 環境ステップ、ESIM(OpenGL レンダラと CPU のイベント生成コアの組み合わせ)は毎秒 4,249 ステップで、約 14 倍です。このとき GPU メモリの使用量は 138 MB で、ESIM のホストメモリ使用量は 656 MB でした。著者は自前シミュレータのマルチスレッド CPU 実装も測っていますが、本文にその数値はありません。
微分可能シミュレーションで方策をどう学習するか
学習ループは論文の図 2 にあります。クアッドロータの状態から濃淡画像を描き、連続する 2 フレームからイベントフレームを作ります。方策(CNN エンコーダと GRU)が加速度を出力し、微分可能な質点モデルが状態を 1 ステップ進めます。状態と行動から損失を計算し、勾配をループ全体に逆伝播します(時間方向の誤差逆伝播。時間方向の勾配減衰 α = 0.4 付き)。ダイナミクスは完全なクアッドロータモデルではなく、Zhang ら(DiffAgile)にならって質点で近似しています。
損失は 5 項の重み付き和です。
- 速度追従:2 秒の移動平均速度と目標速度の差を Smooth L1 で評価、重み 1.0。
- 速度推定:ネットワーク自身の速度推定とシミュレータの真値の平均二乗誤差、重み 100。オドメトリなしの設定で使います。
- 障害物回避:二次の離隔バリア項(障害物への相対接近速度でスケール)と softplus の衝突ペナルティ(β1 = 2.5、β2 = 32)、重み 3.0。
- 加速度とジャークの正則化、重み 0.01 と 0.001。急激な指令や振動する指令を抑えます。
ネットワークは小型です。イベントフレームを 16 × 12 に平均プーリングし、フィルタ数 32、64、128 の 3 層の畳み込みを通して 192 次元に射影します。状態と目標速度も 192 次元に射影して足し合わせ、GRU に入力し、最後の全結合層が 6 個の値(加速度指令と速度推定)を出力します。オドメトリありでは状態に姿勢と速度が入り、オドメトリなしでは姿勢だけなので、速度に関する情報はイベントの履歴から推論する必要があります。
各反復で 150 ステップの軌道を 128 本、制御間隔 1/15 s で集め、約 3 時間で収束しました。オフラインでのイベント生成や表現の事前学習という独立した段階は不要です。図 5 では、オドメトリありの方策のほうが速く収束し、最終的な平均速度も高くなっています。96 × 72 にすると学習時間は約 2 倍になり、学習損失と平均速度の改善はわずかでした。
フィジカルAIラボ 1.4 の動画は Newton を紹介する際、シミュレーションを微分可能にして学習しやすくするという狙いに触れています。本論文はその具体的な使い方の一例ですが、使っているのは独自の CUDA シミュレータと質点モデルで、Newton とは関係ありません。
「ゼロショット」の前に、実機から来ている量
「ゼロショット展開」とは、方策を実機データで学習・微調整していないという意味で、学習に実機の測定値をまったく使っていないという意味ではありません。論文には実機の情報が少なくとも 3 か所あります。
- レンズ歪みの係数は実カメラのキャリブレーションから得ています。
- フライトコントローラの応答はシミュレーション内で一次系としてモデル化し、遅延係数は実機でのシステム同定で求めています。
- 実際のイベントストリームは、まず 1/15 s の窓ごとに画素単位の多数決で 640 × 480 のイベントフレームにまとめ、次に 10 × 10 のブロックで集約してしきい値処理し、64 × 48 に落としてシミュレータの表現にそろえます。
一方、シミュレーションでは障害物の濃淡値をランダムにサンプリングし、イベントのしきい値を毎ステップ再サンプリングし、ランダムな背景ノイズも加えています。フィジカルAIラボ 2.5 では、sim2real でシステム同定とドメインランダム化がよく組み合わせて使われることを扱いました。本論文はその一例で、レンズやフライトコントローラの遅延のように測れる量はキャリブレーションと同定で扱い、イベントカメラのノイズはランダムなしきい値と背景ノイズで模擬しています。
実機飛行の前に、著者は別のオフライン検証も行いました。方策と似た CNN と GRU の構成を持つ速度推定器をシミュレーションのイベントだけで学習し、公開データセット UZH-FPV Drone Racing Dataset の実際のシーケンス 2 本で試しています。論文は予測速度が真値の変化傾向によく追従したと述べていますが、本文に誤差の数値はありません。
実機の結果とベースライン比較
実機には DVXplorer Micro イベントカメラ(640 × 480、ダイナミックレンジ最大 110 dB、1 ミリ秒未満の遅延)を搭載し、Jetson Orin NX で 15 Hz 固定で推論します。方策が出す加速度は総推力と角速度の目標値に変換され、機体の下位の姿勢制御器が追従します。フィジカルAIラボ 1.3 で扱った 4 種類のセンサー(カラーカメラ、深度、力と触覚、固有感覚)にイベントカメラは含まれておらず、ここでの入力は別の撮像方式です。
| 設定 | 状態入力 | 成功 / 総回数(表 I) |
|---|---|---|
| オドメトリあり | 姿勢と速度 | 7 / 8 |
| オドメトリなし | 姿勢のみ | 3 / 3 |
実験は屋内の 1 つの環境で、静止障害物は 1 つだけです。クアッドロータは目標速度で障害物の向こう側のゴールへ向かって飛び、試行ごとに照明、オドメトリの条件、障害物の位置を変えています。著者はさらに照度 5.8 lux という非常に暗い条件でも試し、性能は影響を受けなかったと報告し、その理由をイベントカメラの広いダイナミックレンジに求めています。本文には、低照度での飛行回数も、それが表 I に含まれるかどうかも書かれていません。
ベースライン比較は実機では行われていません。著者は深度ベースの手法 DiffAgile について既に報告された結果(図 8、シミュレーション環境での成功率と平均速度)を引用し、イベントベースの方策は低速では DiffAgile に及ばず、試した中で速い速度では一時的に近づいたと述べています。著者の説明では、遅い動きではイベントが少なく、方策が得る知覚情報も少なくなるためです。本文には図 8 の具体的な数値はありません。著者は、自分たちの手法のサンプル効率を PPO と直接比較していないことも明記しています。また、実際の低照度シーンではイベントカメラが有利かもしれないという点が、このシミュレーション比較には反映されていないことも認めています。
制約と注意点
- arXiv のプレプリントで、数値はすべて著者報告 [R] です。本サイトでは再現していません。本サイトが読んだのは論文の HTML 本文で、コードやシミュレータが公開されているかどうかは本文に書かれていません。
- 実機の証拠は限られています。屋内環境 1 つ、静止障害物 1 つ、表 I の飛行は計 11 回(7/8 と 3/3)です。本文に実機での飛行速度はありません。本サイトの判断では、オドメトリなしの 3 回の飛行だけでは信頼できる成功率は推定できません。
- 約 14 倍のスループットは、64 × 48、N = 128、障害物 200 個、RTX 5060 搭載ノート PC の GPU という条件に限った数値です。3 つの手法は同じシーンを描いていますが、ESIM は輝度変化率や画素変位の予測にもとづいて新しいフレームを描くタイミングを適応的に決め、著者のシミュレータは制御ステップごとに 2 フレームの差を取るだけなので、出力されるイベントは同等ではありません(本サイトが論文の第 II-A 節と第 III-B 節から判断)。
- イベントフレームは制御周期ごとに 2 フレームの差を取った近似で、実機側も 1/15 s の窓で集約しているため、窓内のイベントの時間順序は保持されません(本サイトが手法の記述から判断)。
- DiffAgile との比較は相手の既報の結果を使ったもので、シミュレーション内での比較です。UZH-FPV での速度推定の検証は 2 シーケンスだけで、本文の記述は定性的です。
- 著者が挙げる制約:シミュレータは障害物表面のテクスチャをモデル化しておらず、sim-to-real ギャップの一因となりうること、そして対象は静止障害物だけで、動的障害物は今後の課題であることです。
- シミュレーションでの学習も、数回の屋内飛行も、飛行の安全性の検証にはなりません。
リンク
- Learning Event-based Obstacle Avoidance via Differentiable Simulation(arXiv 2610.38967)
- 論文の HTML 全文
- フィジカルAIラボ 2.5:sim2real のドメインランダム化とシステム同定――二本の論文の数字を元の設定に戻し、コップを押した一本の軌跡から摩擦を手で求める
- フィジカルAIラボ 1.4:シミュレータの地図――刻み幅のコストを数え、接触で軌道が分かれる点を読み、3 つの高速化の比較対象を確かめる
- フィジカルAIラボ 1.3:センサー――1 つのコップで画素数、深度の測定範囲、握る力を手計算する
- フィジカルAIラボ:すべての数字を確認できるフィジカルAI講座(講座の概要)


