
Genie Sim Benchmark 的技术报告(arXiv 2611.15020,预印本)用 22 对真机–仿真任务检验一件事:同一个用真机数据微调的策略,在仿真里拿到的分数和在真机上是否接近。作者报告两边 Score 的 Pearson 相关为 0.9686,单对差值在 −0.110 到 +0.080 之间。报告还给出机器人和物体两层的系统辨识证据,但作者写明,这些物理层结果没有证明它们缩小了任务分数差。本文把三层证据分开读,并说明 0.9686 能支持什么判断。以下数字都是作者报告,本站没有复现。
三层证据与配对协议
报告把证据分成三层,每层有自己的指标和实验单位:机器人执行(G2 crsB 双臂辨识,闭环位置与力矩)、物体交互(五个代表性物体,三个执行栈)、任务结果(22 对真机/仿真 Score)。作者说明,图中的箭头只是组织流程,不代表一个端到端实验。
任务层覆盖四种配置:G1 Omnipicker 8 对、G2 Swiftpicker 6 对、G2 Wuji 1 对、Arx X5 7 对,共 22 对,涉及 16 个任务名,分属选择与推理、放置与分拣、双臂交接、堆叠、织物操作五个任务族。新增实验以 π0.5 为基线,在对应任务采集的真机数据上做监督微调(SFT),得到任务专用模型,再分别在真机和仿真里推理。G1 的 8 对数据取自此前的 Genie Sim 3.0 报告,本研究没有专门为 G1 做系统辨识。
配对方式是:仿真布局与真机测试布局逐个对应,评测标准、场景和测试设置在两边对齐。真机由测试人员全程参与、人工打分并判定失败与超时;仿真按同一标准自动打分。两边试验次数相同,每个环境 30、50 或 100 次。Score 是按评分阶段平均的分数,论文说明它与单独的端到端字段(E2E)和二元任务成功率都不是一回事。
平台介绍部分称 Genie Sim Benchmark 有 78 个仿真任务、四个能力维度(指令遵循、空间推理、鲁棒性、通用操作)。这段描述引用的是未公开的项目文档;本报告实际做真机配对的是上面的 16 个任务名。
22 对分数:0.9686 能说明什么
22 对等权统计,MAE 为 0.0405,RMSE 为 0.0520,平均有符号差(Sim − Real)为 −0.0068。作者注明这些是任务 Score 的差,不是成功率的差,也不是不确定性区间。差值最大的四对如下(表 B1 显示两位小数,计算用全精度):
| 配置 | 任务 | Real | Sim | Δ | 每边次数 |
|---|---|---|---|---|---|
| Arx X5 | Recognize Size | 0.77 | 0.66 | −0.11 | 50 |
| G1 Omnipicker | Sort Fruit | 1.00 | 0.90 | −0.10 | 50 |
| G2 Swiftpicker | Select by Color | 0.86 | 0.76 | −0.10 | 100 |
| Arx X5 | Folding Clothes | 0.72 | 0.80 | +0.08 | 50 |
下面是本站的读法,属于推断。22 对的真机 Score 从 0.24(Arx X5 Stack Blocks)到 1.00(G1 Sort Fruit),任务之间难度差得很远,仿真复现了这种跨任务的高低,相关系数自然会高。如果要用仿真在同一任务上比较两个策略,关键是单对差值和两个策略之间的差距谁大。报告里每个机器人–任务对只评测一个任务专用模型,所以它没有检验仿真能否保持同一任务上不同策略的排序。另外,差值 0.10 出现在每边 50 或 100 次的评测里,报告没有给区间,读者无法判断哪些差值超出了试验次数带来的波动。为什么需要区间、要跑多少次,见物理AI实验室 2.8:可复现评测。
系统辨识前后的 14 对
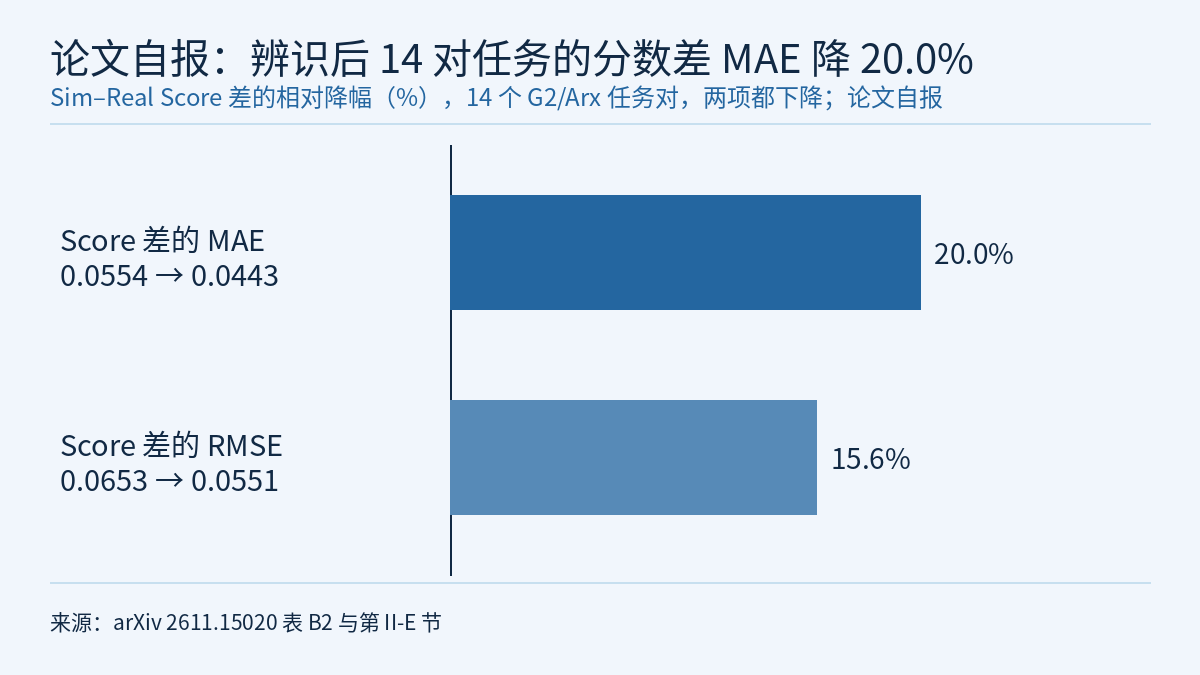
G2 Swiftpicker、G2 Wuji 和 Arx X5 有辨识前后两组仿真 Score,共 14 对。论文说明,这是对已有机器人–任务对的重复条件,不是新增的任务覆盖,真机参照值不变。辨识后,MAE 从 0.0554 降到 0.0443(降 20.0%),RMSE 从 0.0653 降到 0.0551(降 15.6%),Pearson r 从 0.9518 升到 0.9669;平均有符号差则从 −0.0004 变为 −0.0086。
逐对看,8 对的绝对差变小,1 对变大,5 对不变。G2 Swiftpicker 4 对改善、2 对不变,G2 Wuji 的 1 对改善,Arx X5 是 3 对改善、1 对变差、3 对不变。变差的是 Arx X5 Recognize Size,差值从 −0.08 变为 −0.11。改善最多的是 G2 Swiftpicker Fold Cloth,差值从 +0.10 变为 +0.03。Arx X5 的 MAE 只从 0.0500 降到 0.0479,RMSE 约 0.0601 不变;作者说明 X5 没有力控,参数辨识用的是简化模型。
在两位小数的表 B2 里,多数对的绝对差变化在 0.00 到 0.03 之间。报告没有给出区间,所以这些小变化是否超出试验次数带来的波动,不能从论文本身判断(本站推断)。
机器人层与物体层:一条录制与五个物体
机器人层。G2 crsB 每条手臂 7 个关节,模型有 98 个未知量:70 个连杆惯性参数、7 个电枢惯量(armature)、14 个摩擦系数和 7 个偏置。作者指出这些量并非都能从关节力矩独立观测,因此分三步估计:恒速扫描拟合摩擦,正弦激励拟合电枢惯量,七关节同步的傅里叶轨迹再拟合惯性参数,每臂共 18 条录制。另有一条 32.6503 s 的遥操作录制,既不参与机械参数辨识,也不参与伺服增益搜索。外部位置目标经仿真的运动控制器整形后,由标定过的位置伺服驱动 MuJoCo 模型。去掉前 1 s 预热、用 3,165 个样本计算,两臂各关节位置 RMSE 在 0.00614–0.03522 rad,由电流换算的力矩 RMSE 在 0.73545–4.00099 N·m。作者写明,这一条录制检验的是整条执行链,不能单独分离机械辨识的贡献,也不能说明任务层的收益;这次回放用的是 MuJoCo 原生的库仑摩擦,不是拟合出的平滑摩擦函数。
物体层。五个物体是水壶、口香糖盒、海绵、羽毛球和笔,每个物体只有一次真实交互录制。原研究在 MuJoCo 3.10.0 里拟合参数后冻结,再迁移到 MJWarp(MuJoCo-Warp 3.10.0,经 Newton 1.4.0 加载)和 PhysX(Isaac Sim 6.0.0 RC)。结果因物体和引擎而异:
- 水壶盖中心 RMSE 在三个栈里都下降:MuJoCo 39.56 → 25.24 mm,MJWarp 40.98 → 25.12 mm,PhysX 38.66 → 26.23 mm。
- 口香糖盒在 MuJoCo 小幅改善(12.78 → 12.23 mm),在 MJWarp(13.37 → 13.58 mm)和 PhysX(10.99 → 11.46 mm)变差。
- 海绵原样迁移到 PhysX 后误差从 25.50 mm 升到 524.61 mm,没能抬起物体;羽毛球和笔在 PhysX 里于夹爪闭合前滚走。
- 改用 PhysX 原生的接触与阻尼设置后(例如海绵指尖接触刚度 800 N/m、阻尼 5 N·s/m),基线参数和拟合参数都能完成录制的任务。在同一设置下,海绵中心 RMSE 41.54 → 26.73 mm,但竖直方向误差 13.40 → 19.38 mm 变大;羽毛球 RGB 误差 20.47 → 21.05 px 变差,作者仍推荐基线;笔 9.72 → 9.31 px,变化小于约 3 px 的标注不确定度。
作者据此区分了两件事:任务能执行完成,不等于辨识带来了收益;总体误差下降,也不代表每个坐标方向都改善。他们还写明,这些结果没有证明物理辨识以因果方式缩小了基准任务的分数差。物理AI实验室 2.5 用一条推杯轨迹手算摩擦;这份报告把同一思路用到真实机器人和物体上,也显示了它的边界:海绵在 MuJoCo 里拟合出的参数,原样搬到 PhysX 后没能抬起物体。
局限 / 注意
- 这是 arXiv 预印本,所有数字为作者报告,本站没有复现。真机 Score 由测试人员人工打分。
- 任务层、机器人层和物体层的结果都没有置信区间或重复真实试验;时间样本彼此相关,不是独立试验。物体研究所说的“留出”时间窗是同一录制的后段,作者说明它不是盲测。
- 22 对中 G1 的 8 对沿用 Genie Sim 3.0 的数据,没有做本研究的系统辨识。
- 作者列出遥操作回放中尚待补充的实现细节,包括限幅阈值、耦合规则、滤波器初值和执行器限制设置。
- 报告提到的 VLM 先验和由智能体选择交互等扩展,作者注明尚未执行或验证。


