本节视频
配音由 AI 合成。 视频章节、文字稿与出处
文字稿
文字稿
知行问
机器人能拿起一个杯子。可为什么收拾整个厨房,常做到一半就卡住?这一集讲要做很多步的任务。为什么步骤一多就容易崩,又怎么用分层和路由把它救回来。
长任务为什么会崩
上一集我们把一个策略越练越强。可它擅长的,是几秒钟内的动作。再长,就顾不过来了。收拾厨房要几十步:擦台面、收盘子、倒垃圾。每一步都可能出小错。打个比方。走钢丝,走一步不难。难的是几十步都不掉下去,中间还不能重来。换个说法,模型每一步都在猜。单步猜错的概率不大。可几十步累积下来,出错的机会就不小了。更糟的是,小错会累积。第一步偏一点,第二步就更偏,越往后越离谱。闭环里更麻烦。机器人一边做一边看,自己的动作会改变接下来看到的画面。错一步,看到的世界也跟着歪。研究者把这叫误差累积。一个从头管到尾的单一策略,很难独自扛住。这类活儿有个名字,叫长程任务。它要的不只是每一步做对,更是把一长串步骤,稳稳串起来。原来不是某一步太难,是错误一步步滚大了!
慢的想,快的做
办法之一,是把脑子分成两层。一层慢慢想大局,一层飞快管手脚。有人会问,把单一策略做得更大,不行吗?能帮一点。但想和做的节奏,本来就不一样。英伟达的一篇论文,把这写成两套系统。系统二看图、听指令、理解环境。系统一实时生成动作。英伟达的博客讲了新版 GR00T N一点七。它的系统二,正是做任务拆解和多步推理的地方。动作能出多快,看一组实测。一篇 AWS 工程博客在 H100 上,让 ODE 只解一步。这时派零把五十步动作打成一包,整包生成不到两百毫秒。所以不用每毫秒都重想。一包动作约覆盖一秒,而算一包不到两百毫秒。于是每秒能重新规划约五次,上一包没走完,新包就接上了。这样分工,好处很直接。慢层可以用大模型仔细思考,快层保持高频,稳稳发力。两边各司其职。大脑慢慢想,小脑飞快做,机器人也这么分工!不过,这只是个比方。
多策略路由与记忆
光分两层还不够。慢的那层还得会调度。也就是决定,这一步该叫哪个技能。这就像一个编排器。它手里握着一把技能:抓取、开门、擦桌子,各管一段。为什么不干脆用一个全能策略?可以,但把技能分开有个好处。你能一个个测、一个个换、一个个查错。编排器怎么选?大体有两种思路。一种,给每个技能算个可行分,谁高选谁。另一种,让模型直接想下一步。早年有一项机器人研究。论文称,语言模型先提议下一步。技能的价值函数,再判断它能不能做到。这招妙在哪?语言模型天马行空,价值函数把它拉回现实。想得到,还得够得着。另一篇论文叫 Hi Robot。高层先想清下一步,低层再动手。论文在三种机器人上做了验证。派零点五在派零的基础上,又往前走了一步。论文称,它先预测下一个子任务,再落到具体动作。先想做什么,再想怎么做。论文称,派零点五把好几种数据混在一起训。靠这样,它在没进过的新家里,也能把厨房、卧室收拾个大概。还差最后一块,记忆。编排器得记住,哪几步做完了,哪几步还没做。这就是它的进度表。记忆有两种。一种是短短的当下,手里刚拿了什么。一种是任务级的,整件事做到哪一步了。少了记忆,机器人可能把倒过的垃圾,又倒一遍。有了记忆,它才知道自己走到哪。所以,要完成很多步的任务。靠的不是一个大模型,而是一支会调度的小队!
动手:搭一个编排器
把这些拼起来,就是本集的主角。一个编排器,加一组各管一段的策略。完整版的编排器,要在公开基准利贝罗十上跑。AWS 博客称,它有十类桌面操作任务。本机没跑它,本集附带的实验,是 CPU 上的二维替身。不管用哪个基准,评测长任务,都要考连着做多步。单步基准,藏不住误差累积的问题。编排器这样跑。先让高层看一眼画面,说出下一个子任务。这一步只想,不动手。再把这个子任务,交给一个低层策略去执行。比如用微调过的 GR00T。怎么调,下集就讲。做完一步,就写进进度表,再看下一步。这就是路由加记忆的闭环。一圈圈转下去。别忘了给它多跑几个随机种子。长任务的成功率抖动大,只跑一遍的数字,别太当真。怎么算复现成功?关键要分开看两种成功率。一种看单步,一种看整条链。你可以只换高层,别的都不动。要是整条链的成功率变了,瓶颈就在调度这一环。这是个干净的对照。还没解决的是,高层要是选错技能,错误照样会累积。而且此刻的记忆,常常很短。长期记忆,还是难题。回顾一下,三个要点。一,长程任务的难处,是误差会累积。二,分层让慢的想、快的做。三,编排器管路由和记忆。把大问题拆成小步,再一步步盯住,机器人就没那么容易崩了!可低层那个策略,怎么调到你自己的机器人上?下一集见!
证据与出处
两套系统 · GR00T N1 用双系统架构:视觉-语言模块(系统二)理解环境,扩散模块(系统一)实时生成动作 [R] · arXiv 2503.14734 · GR00T N1(NVIDIA)
动手与自测
小测公开,答案与解析在作答后显示;图文课里的练习答案需登录查看。
第 3.4 集的视频讲长程任务:能拿起一个杯子的机器人,收拾整个厨房时常做到一半就崩,因为每一步的小错会累积,一个从头管到尾的单一策略很难独自扛住;办法是分层,慢的一层想大局,快的一层实时出动作;再加一个编排器,决定这一步叫哪个技能,并用进度表记住做到了哪里。片中引了四篇论文和两篇博客:SayCan(arXiv 2204.01691)、Hi Robot(arXiv 2502.19417)、GR00T N1(arXiv 2503.14734)、π0.5(arXiv 2504.16054),NVIDIA 关于 GR00T N1.7 的 Hugging Face 博客,以及 AWS 关于在 SageMaker HyperPod 上微调 π0 的博客。本篇是这一集的图文课与练习,不重复文字稿,只做视频给了结论、没有展开的三件事:把 SayCan、Hi Robot、π0.5 和 GR00T N1.7 博客这四份材料各自怎样分开“选下一步”和“出动作”放回原文,再加一行 AWS 博客给出的快层时间账;用一个虚构的厨房任务手算单步成功率怎样变成整条链的成功率,以及“各步独立”这个假设什么时候会算错;再算清进度记忆和重试改变的是哪一项,代价是什么。贯穿全文的规则:单步成功率和整条链成功率是两个量,要分开报告;一个成功率或时延只属于报告它的那个系统、任务和设置。
本节视频、文字稿与出处在本页上方,全季安排见课程大纲。上一课物理AI实验室 3.3:RL 后训练,把 HIL-SERL 的“2 倍”和 RECAP 的“吞吐翻倍”放回各自条件,再复算三颗种子的配对区间结尾问:策略强了,可长任务里怎么记住、怎么规划?本课接着回答。一条轨迹里误差怎样滚出示范覆盖范围,物理AI实验室 1.6:模仿学习,手算误差怎样滚出示范覆盖范围,再把 ACT、扩散策略与数据规模律的数字放回各自条件已经手算过;看-想-动的三个频率各属哪个系统,物理AI实验室 0.3:看-想-动,把三个频率放回各自的系统讲过;GR00T N1 双系统的结构与参数,物理AI实验室 3.1:VLA 拆解,把一个放杯动作编成 256 个区间的词元,再给三个模型的参数量与频率标清口径拆过;AWS 博客“不到 200 ms、约 5 Hz 重规划”的时间账和动作块该定多长,物理AI实验室 2.6:上边缘,从时延日志算出控制频率上限,分清量化省下的是体积还是时间,再给动作块定长度算过;配对表和区间,分别在物理AI实验室 1.8:评测,把“净增 2”拆成配对表,再给失败标签和随机种子算一笔账和物理AI实验室 2.8:可复现评测,手算 Wald 与 Wilson 区间,从 1/√n 定评测次数,再给零失败算出失败率上界里算过。本课不再重复这些,只讲多个子任务串成一条链之后的成功率、记忆和路由。下一集 3.5 讲 GR00T 微调实战。
公开小测的 5 道题附完整解析;登录后可完成三项练习:用一份虚构的收拾餐桌记录算出边际单步成功率、独立近似和真实的链成功率;给三个虚构路由器的汇总表算链成功率、调用成本和失败归因,决定先修哪一块;审一份虚构的路由消融报告,算出配对差值的区间,并改写它的结论。每项都附分步解法、常见错误与 20 分评分标准。
一、四份材料怎样分开“选下一步”和“出动作”
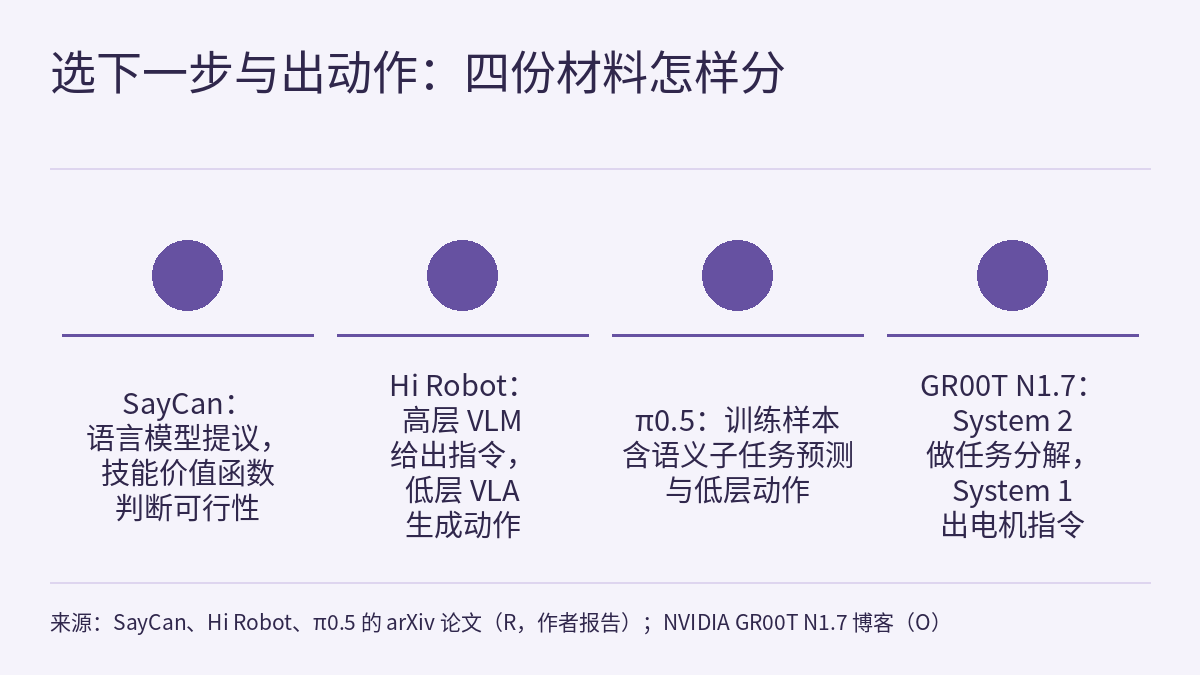
SayCan、Hi Robot、GR00T N1 和 π0.5 都是 arXiv 预印本,按本课程的分级属 R 级;GR00T N1.7 博客是 NVIDIA 对自家模型的介绍,AWS 博客是 AWS 对自己一次微调实验的报告,两者属 O 级。下面的结构和数字都是作者或厂商报告,本站没有运行其中任何一个系统。片中数字卡对应的原文如下,各自独立摘录。这里并排比较的四份材料是 SayCan、Hi Robot、π0.5 和 GR00T N1.7 博客;GR00T N1 论文只作为 N1.7 的背景引用,AWS 博客那一行只补充快层的时间账,不是第五种分法。
SayCan(arXiv 2204.01691)的摘要写的是语言模型和技能怎样分工:
We show how low-level skills can be combined with large language models so that the language model provides high-level knowledge about the procedures for performing complex and temporally-extended instructions, while value functions associated with these skills provide the grounding necessary to connect this knowledge to a particular physical environment.
摘要还说,语言模型缺少真实世界的经验,预训练技能用来约束它,只提议既可行、又符合上下文的自然语言动作;方法在一台移动操作机器人上的多项真实任务中评测。按这段话,“选下一步”由两部分合起来决定:语言模型提供步骤知识,每个技能的价值函数判断这一步在当前环境里能不能做到。视频里说的“想得到,还得够得着”就是这个意思。
Hi Robot(arXiv 2502.19417,作者来自 Physical Intelligence、Stanford University 和 UC Berkeley)把高层和低层都做成视觉-语言模型。高层 VLM 读开放式的任务提示和相机画面,输出“grasp the cup”这类原子指令;低层是一个 VLA,按这条指令、画面和机器人状态生成动作块。论文写明两层的节奏不同:
The two processes run at different rates: the low-level process produces action chunks at a high frequency, while the high-level process is invoked less often, either after a set time or upon receiving new language feedback.
所读段落没有给出两层各自的频率。片中“三种机器人”的数字卡对应这一句:
We evaluate our system across three robotic platforms, including single-arm, dual-arm, and dual-arm mobile robots, demonstrating its ability to handle tasks such as cleaning messy tables, making sandwiches, and grocery shopping.
论文还说,Hi Robot 在符合人的意图和任务成功两方面都超过了几种已有方法,包括调用 API 的 VLM 和不分层的 VLA 策略;所读段落没有给出具体数字。为了训练高层,作者用一个 VLM 给机器人数据合成可能出现过的提示和人的插话。这几点都是作者报告。
π0.5(arXiv 2504.16054)的摘要先说明它和 π0 的关系:
We describe $\pi_{0.5}$, a new model based on $\pi_{0}$ that uses co-training on heterogeneous tasks to enable broad generalization.
再说训练样本里有什么,以及作者的结论:
Our system uses a combination of co-training and hybrid multi-modal examples that combine image observations, language commands, object detections, semantic subtask prediction, and low-level actions. Our experiments show that this kind of knowledge transfer is essential for effective generalization, and we demonstrate for the first time that an end-to-end learning-enabled robotic system can perform long-horizon and dexterous manipulation skills, such as cleaning a kitchen or bedroom, in entirely new homes.
注意摘要的说法:语义子任务预测和低层动作出现在同一类训练样本里,系统是端到端学习的。视频把它讲成“先预测下一个子任务,再落到具体动作”。摘要没有给出成功率,也没有说明“全新的家”有几个、每个家试了几次;“首次”是作者的说法。
GR00T N1.7 的 Hugging Face 博客(NVIDIA,2026 年 4 月 17 日发布)说,它是一个 3B 参数的开放推理 VLA,用双系统设计把高层推理和低层电机控制分开:
System 2 (Vision-Language Model): A Cosmos-Reason2-2B backbone processes image tokens and language instructions to produce high-level action tokens. This is where task decomposition and multi-step reasoning happen.
System 1 是一个 32 层的扩散 transformer,接收 VLM 的输出和实时的机器人状态,实时去噪成电机指令。和 Hi Robot 不同,两层之间传的是“高层动作词元”,不是一句可以读的语言指令。片中还引了前一版 GR00T N1 的论文,它把 System 2 写成理解环境的视觉-语言模块、System 1 写成实时生成动作的扩散 transformer 模块;论文写明 System 2 在 NVIDIA L40 上以 10 Hz 运行,System 1 以 120 Hz 输出闭环动作。N1 的结构 3.1 已经拆过,本课不再展开;N1 论文的数字只属于 N1,不能套到 N1.7 上。
快层的时间账来自 AWS 博客。博客在一台 8 块 H100 的节点上微调 π0,π0 每次预测未来 50 个时间步的动作块;推理计时也写明是在 H100 上:
At 1 ODE step on H100, a full 50-timestep chunk takes under 200 ms, so the policy can re-plan at about 5 Hz while each chunk covers roughly one second of robot motion.
博客在 LIBERO 上扫描了 ODE 步数:从 10 步降到 1 步,时延从 379 ms 降到 197 ms,作者称准确度没有损失。这些计时只属于 π0、这次微调和这台硬件;2.6 已经用它们算过重规划周期,本课不再重复。
下表是本课对所读段落的整理,不是任何一篇原文的表:
| 材料 | 等级 | 谁选下一步 | 两层之间传什么 | 所读段落给出的节奏 |
|---|---|---|---|---|
| SayCan(arXiv 2204.01691) | R | 语言模型提议,技能的价值函数判断可行性 | 自然语言动作,对应一个预训练技能 | 没有给出 |
| Hi Robot(arXiv 2502.19417) | R | 高层 VLM | 原子语言指令 | 低层高频出动作块;高层按设定时间或收到新的语言反馈时调用 |
| π0.5(arXiv 2504.16054) | R | 摘要没有写明推理时的分工 | 训练样本含语义子任务预测和低层动作 | 没有给出 |
| GR00T N1.7 博客(NVIDIA) | O | System 2 做任务分解 | 高层动作词元 | 所引段落没有给出 |
| AWS π0 博客 | O | 不涉及高层 | 不涉及 | H100、1 步 ODE:50 步动作块不到 200 ms,约 5 Hz 重规划,每块约覆盖 1 秒 |
四种分法和一行快层时间账并排放,是因为原文之间没有互相比较;表里的顺序不是排名。它们共同说明的只有一件事:“选下一步”和“把这一步做出来”可以由不同的模块、按不同的节奏完成。哪种分法在你的任务上更好,这些材料都没有回答。
登录后继续阅读本课其余各节、自测题与答案。
局限 / 注意
- SayCan、Hi Robot、GR00T N1 和 π0.5 都是 arXiv 预印本,属 R 级;GR00T N1.7 博客和 AWS 博客属 O 级,分别是 NVIDIA 和 AWS 对自家模型或实验的报告。结构、数字和“首次”之类的说法都是作者或厂商报告,本站没有复现,也没有运行其中任何一个系统。
- 本课只读了 SayCan 和 π0.5 的摘要、Hi Robot 的摘要和前四节的一部分、GR00T N1 的摘要、引言和第 2 节的一部分、GR00T N1.7 博客,以及 AWS 博客的部分章节。所读段落没有给出 π0.5 的成功率、Hi Robot 两层各自的频率和相对其他方法的具体数字。
- AWS 博客的计时只属于 π0、它的微调设置和 H100;它在 LIBERO 上报告的是动作预测误差,评测只覆盖 5 个留出回合,不是闭环任务成功率。
- 视频说明本集没有在 LIBERO-10 上运行完整的编排器。本课的全部计算都用虚构数字,不引用任何运行记录。
- 以下是本课的整理、算术或推断:第一节的对照表;第二、三节的连乘、条件概率与调用次数;第四节的对照清单。
- 厨房 K、路由器 A–D、团队 L、餐桌任务和所有配对计数都是虚构的。纸面计算和仿真结果都不是硬件安全验证。
链接
- 物理AI实验室:一套每个数字都能核对的物理 AI 课程(课程大纲)
- 物理AI实验室 3.3:RL 后训练,把 HIL-SERL 的“2 倍”和 RECAP 的“吞吐翻倍”放回各自条件,再复算三颗种子的配对区间
- 物理AI实验室 3.1:VLA 拆解,把一个放杯动作编成 256 个区间的词元,再给三个模型的参数量与频率标清口径
- 物理AI实验室 2.6:上边缘,从时延日志算出控制频率上限,分清量化省下的是体积还是时间,再给动作块定长度
- 物理AI实验室 1.6:模仿学习,手算误差怎样滚出示范覆盖范围,再把 ACT、扩散策略与数据规模律的数字放回各自条件
- 物理AI实验室 0.3:看-想-动,把三个频率放回各自的系统
- 物理AI实验室 1.8:评测,把“净增 2”拆成配对表,再给失败标签和随机种子算一笔账
- 物理AI实验室 2.8:可复现评测,手算 Wald 与 Wilson 区间,从 1/√n 定评测次数,再给零失败算出失败率上界
- SayCan:用机器人技能的可行性给语言模型接地(arXiv 2204.01691)
- Hi Robot: Open-Ended Instruction Following with Hierarchical Vision-Language-Action Models(arXiv 2502.19417)
- GR00T N1: An Open Foundation Model for Generalist Humanoid Robots(arXiv 2503.14734)
- π0.5:基于 π0、用异构任务协同训练的 VLA(arXiv 2504.16054)
- NVIDIA Isaac GR00T N1.7: Open Reasoning VLA Model for Humanoid Robots(Hugging Face 博客)
- AWS:Fine-Tuning π0 (Pi-Zero) for robotic manipulation on Amazon SageMaker HyperPod EKS