この回の動画
ナレーションは AI 合成音声です。 動画の章・文字起こし・出典
文字起こし
文字起こし
知行の問い
ロボットは一つの動作を覚えてから、自分の力でどんどんうまくなれるの?今回のテーマは、RLによる事後学習です。モデルが本物の試行錯誤の中で、失敗から立ち直ることを覚え、どんどんうまくなっていきます。
模倣から試行錯誤へ
まずは模倣学習です。ロボットにたくさんのお手本を見せると、その通りにまねします。でもお手本には、失敗や立て直しがほとんど入っていません。なぜ模倣は行き詰まるのでしょう。お手本の多くは、うまくいく道筋しか見せていません。少しそれると、お手本にない状態に入り、間違えたときにどうすればいいか分からないのです。たとえば、コーヒーを注ぐときに手がぶれて、こぼれたとします。模倣で覚えた方策は、そこで固まってしまうかもしれません。強化学習は、発想を変えます。ロボットに自分で試させ、うまくできたら多めに報酬を与えます。自分の経験から、よくなる方法を学ぶのです。だから、キーワードは事後学習です。お手本で土台を作り、試行錯誤で方策を安定して速くなるよう磨きます。土台と仕上げ、どちらも欠かせません。
π*0.6 と RECAP
まず、ある論文を見てみましょう。フィジカル・インテリジェンスという会社のものです。モデルの名前は、パイスター・れいてんろく。その手法の名前は、リキャップ。論文によると、アドバンテージ条件づけを使って、強化学習をVLAに応用しました。アドバンテージ条件づけとは?簡単に言うと、どの動作がよりよく、どの動作がより悪いかを、モデルに見分けさせることです。データの出どころは三つ。人のお手本、ロボットが自分で動いた記録。そして、そばにいる人がその場で直したものです。なぜ人が直すのでしょう。自分だけで試すのは、遅すぎるうえに危ないからです。人が手を貸せば、速く、安定して学べます。効果はどうでしょう。論文によると、一部の最も難しい作業で、処理量は二倍以上に。失敗率も、おおよそ半分に減りました。どれくらい本物の作業なのでしょう。論文によると、実際の家庭で洗濯物をたためます。箱の組み立てもできるし、業務用のマシンでコーヒーもいれられます。もう一つの論文は、さらに本格的です。シミュレーションに頼らず、実機でそのまま強化学習を行います。本物の世界で、何度も何度も試すのです。学習にかかる時間は?論文によると、わずか一から二点五時間。それで、ほぼ満点の成功率になります。どれくらい向上したのか。論文は、模倣学習のベースラインや従来のRL手法と比べています。成功率は平均で二倍、実行速度はおよそ一点八倍に上がりました。その秘訣の一つが、人がループに入ることです。ロボットが失敗しそうなとき、人が手を貸します。その修正も、学習の信号になるのです。ロボットも失敗から学んで、腕を上げられるんだ!
自己改善のループ
これらをつなげると、一つのループになります。見て、考えて、動いて、フィードバックを受け取り、自分を更新するのです。ループでいちばん大事なのは、フィードバックです。よいフィードバックがあってこそ、方策はどこを直せばいいか分かります。なければ、から回りするだけです。一周、また一周と回るうちに、方策は自分で上がっていきます。これが自己改善です。毎回、一から教える必要はありません。シミュレーションの中でも、同じように練習できます。エヌビディアのアイザック・ラボは、オープンソースのフレームワークです。強化学習に対応しています。強化学習が効いたかどうかは、どう確かめるのでしょう。前後で比べます。まず、今の成功率を測ります。それから強化学習で微調整して、上がったかどうかを見るのです。こんな学習の道筋があります。まず先生を学習させ、それを生徒に蒸留します。最後の仕上げは強化学習。これで生徒を磨き上げます。シミュレーションのよいところは、大量に並列で動かせて、壊れもしないことです。だから試行錯誤が、速く安くできます。実機とシミュレーションは、よく組み合わせて使います。シミュレーションでほぼ仕上げて、実機で細かく調整するのです。シミュレーションには、ドメインランダム化という技があります。照明、摩擦、質量をランダムに揺らします。すると、方策がタフになります。もう一つの方向は、フリート学習です。たくさんのロボットが一緒に働き、経験を一か所に集めて、そろって強くなります。データが多いほど、経験が豊かになるのです。試行錯誤のデータは貴重です。実機を一回動かすのは、遅くて高くつきます。だから、一つ一つの経験を使い切らなければなりません。もう一つの技は、カリキュラム学習です。簡単なものから始めて、少しずつ難しくします。いきなり一番難しいものに挑ませてはいけません。実機での試行錯誤には、安全の管理も必要です。ガードレールが要ります。自分自身や、まわりを壊させてはいけません。人の修正はありがたいのですが、疲れます。理想は、後になるほど人が手を出さなくて済むことです。報酬をどう与えるかは、職人の技です。まばらすぎると、学べません。細かすぎると、今度は変な方向に学びやすくなります。本当に強くなったと、どう確かめるのか。実験をくり返して、結果のばらつきを見ます。一回の幸運にだまされず、ペアで比べた改善幅の区間がゼロを含むなら、証拠不足としか言えません。コーヒーの例に戻りましょう。練習したあとは、手がぶれると、いったん止まります。体勢を立て直してから、また注ぎます。オフライン強化学習という方法もあります。その場での試行錯誤はしません。保存してある経験から、くり返し学ぶのです。なぜ、以前はあまりやらなかったのでしょう。実機での強化学習は、安定させるのが難しいからです。少し油断すると、発散してしまいます。では、なぜうまくいくようになったのか。アルゴリズムが安定したからです。そして、人が手を貸す仕組みができたからです。はっきりさせておきましょう。これらの多くは、まだ一つの技能、一台のロボットの話です。汎用には、まだほど遠いのです。まだ解決していないのは、コストです。実機での強化学習は、遅くて高く、本当に部品を壊すこともあります。報酬の設定も問題です。報酬が少しでもずれると、ロボットは抜け道を見つけます。あなたが望まなかった行動を覚えてしまうのです。シミュレーションでうまく学べても、実機に移すと、なじまないことがあります。これが昔からの問題、シムツーリアルです。だから事後学習の考え方は、まず模倣、それから試行錯誤。方策が自分の経験から、成長し続けられるようにします。使うほど手慣れて、立て直しもうまくなるのです。ふりかえりです。ポイントは三つ。一つ、お手本には失敗が少なく、模倣は少しそれると行き詰まる。RLは試行錯誤から立て直しを学べる。二つ、リキャップはRLをVLAに応用しました。論文によると、一部の最も難しい作業では、処理量が二倍以上に、失敗はおおよそ半分になりました。三つ、自己改善はループ。でも実機のRLは遅くて高く、報酬の設定も難しい。まず人から学んで、それから自分で練習。ロボットも、失敗するほど強くなるんだ!方策は強くなった。でも長い作業では、どう覚えて、どう計画するの?また次回!
根拠と出典
倍以上 / 約半分 · 一部の最も難しい作業で、RECAP は処理量を二倍以上にし、失敗率をおおよそ半分に(論文) [R] · arXiv 2511.14759 · π*0.6 / RECAP
1〜2.5時間 · 実世界のRL:1〜2.5時間の学習で、ほぼ満点の成功率に(論文) [R] · arXiv 2410.21845 · HIL-SERL
2倍 / 1.8倍 · 模倣学習のベースラインや従来のRL手法と比べ、成功率は平均2倍、実行は1.8倍速い(論文) [R] · arXiv 2410.21845 · HIL-SERL
練習とセルフチェック
小テストは公開で、回答するとすぐ解説が出ます。読み物の練習問題の答えはログイン会員向けです。
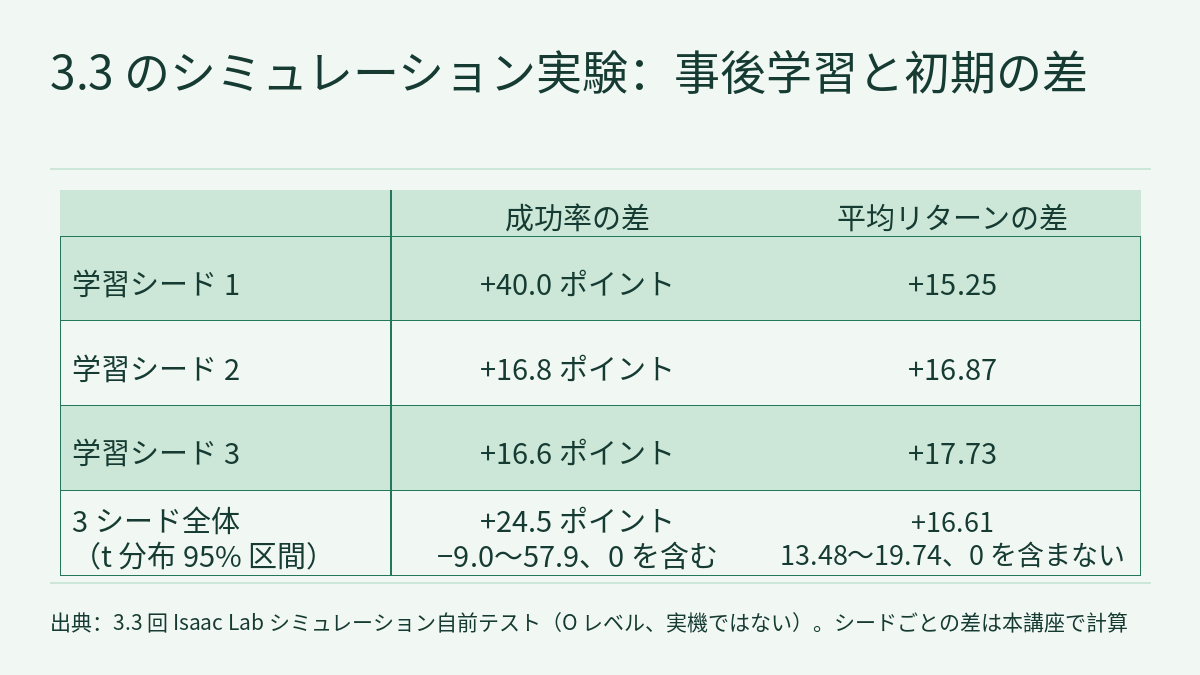
第 3.3 回の動画は、RL による事後学習を扱います。お手本の多くはうまくいく道筋しか含まないので、模倣で覚えた方策はお手本から少しそれると行き詰まりやすくなります。強化学習なら、方策は自分の経験から立て直しを学べます。だから、まずお手本で土台を作り、試行錯誤で磨きます。動画は二本の論文を引用しています。Physical Intelligence の π*0.6 と RECAP(arXiv 2511.14759)、UC Berkeley の HIL-SERL(arXiv 2410.21845)です。さらに、本講座が自分で Isaac Lab で行ったシミュレーション実験を使い、方策が本当に強くなったかをどう確かめるかを示しています。このページはこの回の解説と練習です。文字起こしは繰り返さず、動画が結論だけを述べて展開しなかった三つのことを行います。HIL-SERL の「1〜2.5 時間」「2 倍」「1.8 倍」を、論文が明記するシステム、ベースライン、タスクの範囲に戻します。架空の作業ステーションを使い、RECAP の要旨にある「処理量が 2 倍以上」と「失敗率がおおよそ半分」がなぜ別の量なのかを計算で確かめます。そして、実験記録が公開しているシードごとの数字から、成功率とリターンの対応のある 95% 区間を手で計算し直し、成功率がなぜ「証拠不足」としか記録できないのかを見ます。全体を通す約束は、倍率はそれを報告したシステム、ベースライン、指標だけのものだ、ということです。分母が違えば互いに換算できず、一つの結論にまとめることもできません。
この回の動画、文字起こし、出典はこのページの上部にあります。シーズン全体の構成は講座の概要をご覧ください。前回のフィジカルAIラボ 3.2:世界モデル――Cosmos でデータをつくる。生成ごとの条件を書き出し、78.3% を人の評価に戻し、生成データの受け入れ基準を決めるは、学習した方策が試行錯誤の中でどう強くなっていくのか、という問いで終わりました。この回はその続きです。誤差がお手本のカバー範囲からどうはみ出すかは、フィジカルAIラボ 1.6:模倣学習――誤差がお手本のカバー範囲からはみ出すまでを手で計算し、ACT・拡散方策・データのスケーリング則の数字をそれぞれの条件に照らして読むで手計算しました。リターンがどう積み上がり、報酬がどう抜け道を突かれるかは、フィジカルAIラボ 1.7:強化学習――1 回分の収益を手で計算して報酬の抜け道を見つけ、論文の地形カリキュラムとタイムアウト時のリセットを読むで扱いました。Isaac Lab での並列学習はフィジカルAIラボ 2.4:Isaac Lab で並列に歩く練習――ベンチマーク表の 3 つの FPS 列を読み、学習コマンドから総ステップ数を計算するで、ドメインランダム化と sim2real はフィジカルAIラボ 2.5:sim2real のドメインランダム化とシステム同定――二本の論文の数字を元の設定に戻し、コップを押した一本の軌跡から摩擦を手で求めるで扱いました。対応表と Wilson 区間は、フィジカルAIラボ 1.8:評価――「差し引き +2」を対応表に分解し、失敗ラベルと乱数シードを計算で確かめるとフィジカルAIラボ 2.8:再現できる評価――Wald 区間と Wilson 区間を手で計算し、1/√n から評価回数を決め、失敗ゼロのあとの失敗率の上限を求めるで計算しました。この回はそれらを繰り返さず、RL 事後学習の三つの根拠がそれぞれ何を測っているか、そして学習シードをまたいだ t 区間をどう計算するかだけを扱います。実験のプロトコルと結果の全文は物理AI实验室 3.3 实验记录:Isaac Lab 仿真 3 个种子(中国語)にあります。本サイトのレーダー記事フロンティア・レーダー|SO-101 で π0.5 をファインチューニングしてチェスのキングを動かす:チェックポイントは学習率を下げてから比べ、実データが少ないほどシミュレーション事前学習が効き、自身のロールアウトでの再学習に測定できる改善はないが扱うのは、別のプレプリント、別のロボット、別の設定です。その結果をこの回の数字とまとめることはできません。次回 3.4 では、長い作業での記憶、計画、複数方策の振り分けを扱います。
公開小テストの 5 問には詳しい解説が付いています。ログインすると、三つの練習に取り組めます。実験記録のシードごとの数字から対応のある 95% 区間を計算し直し、必要な学習シードの数を見積もる。架空のコーヒー作業ステーションについて処理量、成功率、失敗率を計算し、倍率についての四つの文を審査する。実機での RL 事後学習の架空の計画を審査し、確認できるプロトコルに書き直す。いずれにも段階的な解答例、よくある誤り、20 点満点の採点基準が付いています。
1. HIL-SERL:「1〜2.5 時間」と「2 倍」に付いている条件
HIL-SERL の論文は arXiv のプレプリントで、著者は UC Berkeley の Jianlan Luo、Charles Xu、Jeffrey Wu、Sergey Levine です。本講座の区分では R レベルで、以下はすべて著者の報告です。本サイトは再現していません。動画の二枚の数字カードは、要旨の二つの文に対応します。それぞれ独立に抜き出します。
learn policies that achieve near-perfect success rates and fast cycle times within just 1 to 2.5 hours of training.
We show that our method significantly outperforms imitation learning baselines and prior RL approaches, with an average 2x improvement in success rate and 1.8x faster execution.
序論には、模倣学習と比べたときの条件を明記した文がもう一つあります。
Our trained RL policies greatly outperform imitation learning methods that are trained on the same amount of human data, e.g., same number of episodes of demonstrations or corrections, on average 101% improvement in terms of success rate and 1.8x faster in cycle time.
これらの数字を読むときの注意は四つです。一つ目、「101% の向上」は元の 2.01 倍のことで、要旨の「2 倍」と一致します。序論は、比較の相手が同じ量の人のデータ(お手本または修正の同じエピソード数)で学習した模倣学習だと明記しています。要旨は従来の RL 手法にも触れていますが、読んだ箇所にはそれに対する数字が別には示されていません。二つ目、これはタスクをまたいだ平均です。成功率が 2 倍になれるのは、ベースラインが 50% 以下のときだけです。ベースラインが 70% のタスクで 2 倍なら 140% になり、ありえません。したがって平均 2 倍は、個々のタスクがどれだけ上がったかについて何も語りません(この回の計算)。三つ目、序論の言い方は「ほぼすべてのタスク」です。
However, perhaps the most surprising finding is that our system can train RL policies to achieve near-perfect success rates and super-human cycle times on almost all of the tasks with only one hour to 2.5 hours of training time in the real world.
四つ目、1〜2.5 時間は、このシステムがこれらのタスクで実機学習にかけた時間です。読んだ箇所は、お手本の収集、報酬分類器の学習、システムの構築にかかる時間を含むかどうかを述べていません。
このシステムはいくつかの部品でできており、論文は部品ごとに一つの難しさを対応させています。最適化の不安定さには事前学習した視覚バックボーン、サンプル複雑度には人のお手本と修正を取り込む RLPD ベースのサンプル効率のよいオフポリシー手法を使い、さらに学習中の安全のためによく設計した低レベル制御器を入れています。RLPD は学習の各ステップで、事前データとオンポリシーのデータから半分ずつ取り出してバッチを作ります。報酬はまばらです。
For all our tasks, we employ a sparse reward function. This function makes a binary decision on whether a task is successful or not using a trained classifier.
人の修正もデータになります。
During training, the system queries a human operator for potential corrections, which are then used to update the policy in an off-policy manner.
論文によると、前作 SERL との違いの一つは、人のお手本と修正の両方を使うことです。SERL はお手本だけを使います。著者は、修正を加えることが、方策が失敗から学んで性能を上げるのに欠かせず、とくに一から学ぶのが難しいタスクでそうだと考えています。タスクには、鞭でジェンガの塔から一本を抜き取る、フライパンの中で物をひっくり返す、二本のアームの間で物を受け渡す、マザーボード、IKEA の棚、自動車のダッシュボード、タイミングベルトを組み立てる、などがあり、アームは一本または二本です。動画は「これらの多くは、まだ一つの技能、一台のロボットの話」と注意しています。この回の読み方では、どの数字もこれらのタスク、このハードウェア、この手順のものです。別のタスクでは、学習時間も改善幅も測り直す必要があります。
ログインすると、このレッスンの続きと確認問題、解答を読めます。
制約と注意点
- HIL-SERL と RECAP はどちらも arXiv のプレプリントで、R レベルです。システムの構成、学習時間、倍率は著者の報告で、本サイトは再現しておらず、どのモデルも動かしていません。RECAP は Physical Intelligence による自社モデルの報告です。
- HIL-SERL は要旨、序論、関連研究、3 節冒頭の一部を、RECAP は要旨だけを、Isaac Lab はドキュメントのトップページだけを読みました。読んだ箇所は、RECAP の絶対値、どのタスクが「最も難しい」のか、処理量の定義と比較の相手を示しておらず、HIL-SERL の学習時間に準備の時間が含まれるかどうかも述べていません。
- 実験記録は本講座自身のシミュレーション実験で、O レベル、実機の結果ではありません。再現用のスクリプト、生ログ、シードごとの JSON は公開されていません。初期方策は学習の足りない PPO 方策で、その結論は VLA の RL 事後学習を代表できません。
- 次はこの回の整理、計算、推測です。101% は 2.01 倍に等しいこと。ベースラインが 50% を超えるタスクは 2 倍になれないこと。シードごとの差と計算し直した区間。リターンの区間の 0.01 の違いの理由。4 節の根拠の表と記録のチェックリスト。
- 2 節の三通りの対応と作業ステーション B、練習の作業ステーション K、チーム H、ロボットアーム C、計画の項目 P1〜P5、介入回数、応用課題のシードごとの差は、すべて架空のもので、どの論文やシステムのデータでもありません。
- 紙の上の計算とシミュレーションの結果は、ハードウェアの安全性の検証ではありません。
リンク
- フィジカルAIラボ:すべての数字を確認できるフィジカルAI講座(講座の概要)
- 物理AI实验室 3.3 实验记录:Isaac Lab 仿真 3 个种子(フィジカルAIラボ 3.3 実験記録、中国語)
- フィジカルAIラボ 3.2:世界モデル――Cosmos でデータをつくる。生成ごとの条件を書き出し、78.3% を人の評価に戻し、生成データの受け入れ基準を決める
- フィジカルAIラボ 1.6:模倣学習――誤差がお手本のカバー範囲からはみ出すまでを手で計算し、ACT・拡散方策・データのスケーリング則の数字をそれぞれの条件に照らして読む
- フィジカルAIラボ 1.7:強化学習――1 回分の収益を手で計算して報酬の抜け道を見つけ、論文の地形カリキュラムとタイムアウト時のリセットを読む
- フィジカルAIラボ 1.8:評価――「差し引き +2」を対応表に分解し、失敗ラベルと乱数シードを計算で確かめる
- フィジカルAIラボ 2.4:Isaac Lab で並列に歩く練習――ベンチマーク表の 3 つの FPS 列を読み、学習コマンドから総ステップ数を計算する
- フィジカルAIラボ 2.5:sim2real のドメインランダム化とシステム同定――二本の論文の数字を元の設定に戻し、コップを押した一本の軌跡から摩擦を手で求める
- フィジカルAIラボ 2.8:再現できる評価――Wald 区間と Wilson 区間を手で計算し、1/√n から評価回数を決め、失敗ゼロのあとの失敗率の上限を求める
- フロンティア・レーダー|SO-101 で π0.5 をファインチューニングしてチェスのキングを動かす:チェックポイントは学習率を下げてから比べ、実データが少ないほどシミュレーション事前学習が効き、自身のロールアウトでの再学習に測定できる改善はない
- Luo ほか:Precise and Dexterous Robotic Manipulation via Human-in-the-Loop Reinforcement Learning(HIL-SERL、arXiv 2410.21845)
- Physical Intelligence:π*0.6 と RECAP(arXiv 2511.14759)
- NVIDIA Isaac Lab ドキュメント