本节视频
配音由 AI 合成。 视频章节、文字稿与出处
文字稿
文字稿
知行问
机器人不能一次次在真实世界里摔坏零件,那它去哪儿练?答案之一,是在虚拟世界里练。这一集讲英伟达的 Cosmos。它怎么造出一个世界,用来生成训练数据。
世界模型是什么
什么是世界模型?英伟达的论文开头就说:物理 AI 要先在数字世界里训练。它需要两个数字孪生。一个是机器人自己,一个是它所在的世界。世界这一个,就叫世界模型。世界模型只干一件事。给它过去的画面,加上动作或指令,它就预测下一刻。还得想清楚一件事。世界模型,不是渲染器。它不靠人写规则,而是从视频里学物理。还有个关键零件:视频分词器。它把视频压成一串紧凑的记号。这样,模型才吃得下。这样的模型,靠海量视频喂出来。英伟达的论文称,原始视频两千万小时。从里面切出,约一亿个片段。为什么要这么多?因为数据的多样性,决定了这个虚拟世界,见过多少种物理。见得越多,越不容易被现实为难。它的野心,是当物理世界的通用模拟器。任何机器人,都能先在里面走一遍。先走一遍,再上真机。
Predict:预测未来
第一件武器,叫 Cosmos Predict。它的本事,是预测接下来的画面。它也分预训练和后训练。先用海量视频,学通识。再用少量目标数据,专门微调。怎么接上机器人?把动作当成条件,喂给模型。让它按照动作,预测画面。它有两种做法。英伟达的论文写道,先看扩散这条线。它做了七十亿和一百四十亿两个规模。另一条线,是自回归。像语言模型那样,一块块往下猜。两条线,各有各的长处。这类模型能一段接一段。自回归地续下去。短片段,能滚成长视频。训练这些模型,花了多少算力?英伟达的论文称,用了一万块 H100。整整跑了三个月。对机器人有什么用?英伟达报告了一次人类评审,比的是机器人指令视频预测。微调模型总体偏好百分之七十八点三,基线是百分之十三。论文还列了几种可能的用法。比如规划:让世界模型预演几种动作,挑出最好的一条。也能当考官、当环境,让策略先在里面被评测、被训练。但论文说明,这些用法还没给出实验结果。要是行得通,就能先在脑补的世界里,把策略练一练、考一考!
Transfer:迁移与 sim2real
为什么还要 Transfer?仿真便宜,但看着假。真实好看,但又贵又慢。第二件武器,Cosmos Transfer。英伟达的论文说,给它分割图、深度、边缘。它生成对应的逼真画面。它的控制是自适应的。不同区域,可以给不同强度。想让哪儿严格,就让哪儿严格。这有什么用?仿真画面,往往很假。Transfer 能把它,刷成逼真的样子。论文把这叫世界到世界的迁移。同一个场景,换风格、换天气,都能重新生成。论文还拿它,给自动驾驶扩充数据。再回到 Predict:论文把它微调后,能听镜头指令。像玩游戏一样,前进、后退、左转、右转。生成的世界,就能走进去看看。论文也把 Predict,微调到自动驾驶相关的任务上。生成的是行车画面。快到什么程度?Transfer 的论文说,用一整套顶配 GPU 机架。最高,能做到实时生成。英伟达还给它加了护栏。有害的输入和输出,都会被拦下来。这是发布前的必修课。把两件武器接起来,就是一条数据管线。仿真出结构,Transfer 出画面。Predict 再补未来。生成数据,好处是便宜又多样。想要多少种光照、多少种摆放,就生成多少。真机,可做不到这么快。回到我们的例子。把杯子放进篮子,先在生成的世界里预演。摆放换了,也能重来。论文还设想了一个用法:拿世界模型当策略的起点。先学会世界怎么动,再学怎么动手。这一条,论文也还没给出实验结果。还没解决的是:画面再逼真,也不等于真实物理。论文自己也说,世界模型这个问题,还远没有解决。它也会犯低级错。物体凭空出现,又凭空消失。或者违反重力,直接穿过桌子。怎么判断一个世界模型好不好?这件事本身,就很难。人来打分带主观,指标也未必对得上。所以 Cosmos 给了两件事。Predict 预测未来,Transfer 换风格。两个一起,造训练数据。记住一句话。它是数据放大器,不是真值来源。能省真机,却省不掉核对。更长远的用法,是闭环。策略在世界里试错,拿反馈改进自己。这正好,接下一集。回顾一下,三个要点。一,世界模型能预测未来。二,Predict 管生成,Transfer 管迁移。三,逼真不等于对的物理。在脑补的世界里反复练,再回到现实。这就是造世界的意义!那练出来的策略,怎么在试错里越变越强?下一集见!
证据与出处
2000 万小时 · Cosmos 预训练用的原始视频量;从中切出约 1 亿个片段(英伟达) [R] · arXiv 2501.03575 · Cosmos WFM Platform(NVIDIA)
1 万块 H100 · 训练论文里全部世界基础模型用的 GPU 集群,历时三个月(英伟达) [R] · arXiv 2501.03575 · Cosmos WFM Platform(NVIDIA)
动手与自测
小测公开,答案与解析在作答后显示;图文课里的练习答案需登录查看。
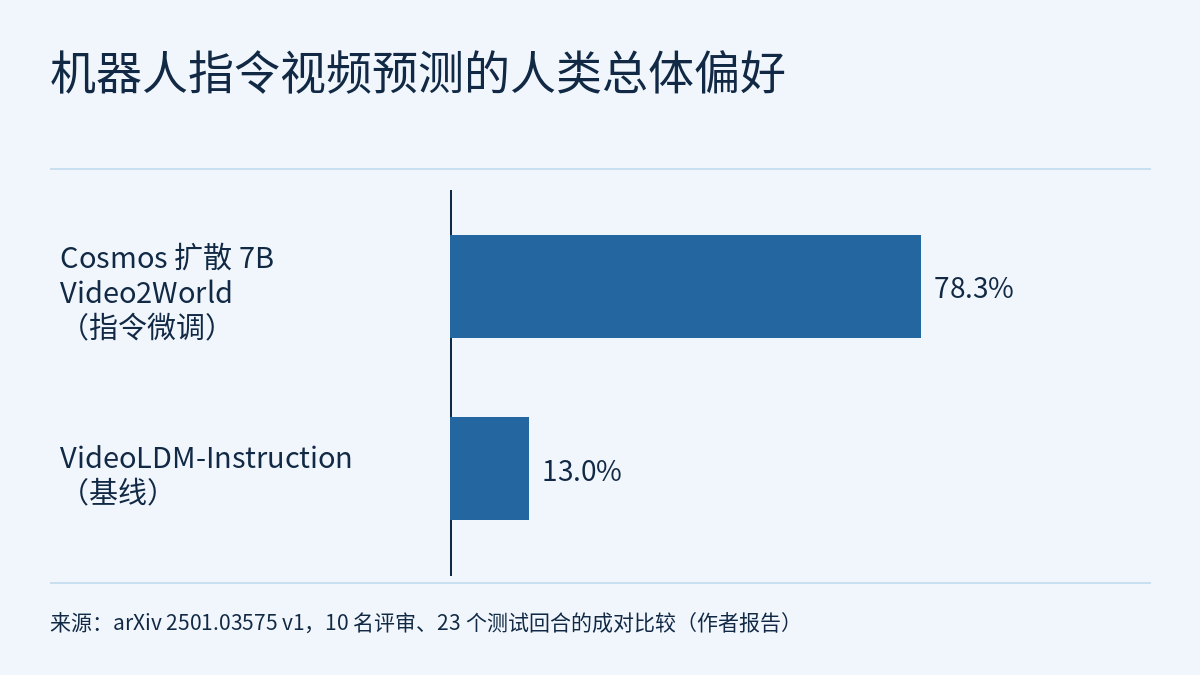
第 3.2 集的视频讲英伟达的 Cosmos 怎样用世界模型造训练数据:世界模型拿过去的画面加上一个动作或指令,预测下一刻;Cosmos Predict 顺着往下生成视频,Cosmos Transfer 以分割、深度、边缘这类控制输入生成逼真画面;画面再逼真,也不等于对的物理。片中的数字卡出自两篇 NVIDIA 的 arXiv 论文:Cosmos 世界基础模型平台(2501.03575)和 Cosmos-Transfer1(2503.14492)。本篇是这一集的图文课与练习,不重复文字稿,而是做三件视频只点到的事:把论文的定义写成一个式子,逐一写清每种生成以什么为条件、输出什么;把论文在机器人上的两组评测,即 78.3% 的人类偏好和 Bridge 数据集上的四个画面指标,放回各自的模型、数据和评分方式,看它们量了什么、没量什么;再给一批虚构的生成放杯数据定一套验收规则。贯穿全文的规则:论文列出的用法不等于论文给出的结果;一个评测数字只属于报告它的模型、数据集和评分方式。
本节视频、文字稿与出处在本页上方,全季安排见课程大纲。上一课物理AI实验室 3.1:VLA 拆解,把一个放杯动作编成 256 个区间的词元,再给三个模型的参数量与频率标清口径拆开了策略模型的内部;本课换一个方向:不改策略本身,而是给策略造练习用的世界和数据。仿真为什么便宜、仿真数字要补哪些实验条件,物理AI实验室 0.4:在虚拟世界练一万遍,给三个仿真数字补上实验条件讲过;用域随机化和系统辨识缩小仿真与真机的差距,物理AI实验室 2.5:sim2real 的域随机化与系统辨识,把两篇论文的数字放回原设定,再从一条推杯轨迹手算摩擦讲过,Cosmos Transfer 处理的是另一面:仿真画面看着假。第四节的验收规则要用配对比较和区间,分别在物理AI实验室 1.8:评测,把“净增 2”拆成配对表,再给失败标签和随机种子算一笔账和物理AI实验室 2.8:可复现评测,手算 Wald 与 Wilson 区间,从 1/√n 定评测次数,再给零失败算出失败率上界里算过,本课不再推导。本课读的是 Cosmos 1.0 平台论文和 Cosmos-Transfer1;站内雷达前沿雷达|NVIDIA Cosmos 3 on AWS:一次前向给出推理、视频与动作,实例选型附了哪些验证条件讲的是 Cosmos 3,是另一个版本,两边的数字不能互相套用。下一集 3.3 讲 RL 后训练与自我改进闭环。
公开小测的 5 道题附完整解析;登录后可完成三项练习:给五个虚构的生成请求写出过去观测、条件、输出和论文证据的状态;审计八段虚构的生成片段,算出通过率和真机片段上的误报率;审一份虚构的结论备忘录,用三颗种子的配对结果判断生成数据是否真的有帮助。每项都附分步解法、常见错误与 20 分评分标准。
一、一个式子,几种条件:论文怎样定义世界模型
两篇都是 arXiv 预印本,按本课程的分级属 R 级,而且都是 NVIDIA 对自家模型的报告;下面的结构和数字都是作者报告,本站没有运行其中任何一个模型。平台论文的摘要这样开头:
Physical AI needs to be trained digitally first. It needs a digital twin of itself, the policy model, and a digital twin of the world, the world model.
论文第 2 节把世界基础模型写成一个映射:模型 W 根据从 0 到 t 时刻的过去观测和当前扰动,预测 t + 1 时刻的观测。用代码式的记号写就是 x̂[t+1] = W(x[0:t], c[t])。论文说,在 Cosmos 里过去观测是 RGB 视频,扰动可以有很多形式:
It can be an action taken by the Physical AI, a random perturbation, a text description of the perturbation, etc.
视频里“给过去的画面加一个动作或指令”就是这个式子。读论文里的每一个模型,先问两件事:x 是什么,c 是什么。下表是本课对所读段落的整理,不是原文的表:
| 模型或后训练 | 过去观测 x | 条件 c | 输出 | 出处 |
|---|---|---|---|---|
| Cosmos-1.0-Diffusion-7B / 14B-Text2World | 无 | 文本提示 | 视频 | 第 5 节,表 10 |
| Cosmos-1.0-Diffusion-7B / 14B-Video2World | 输入视频(当前观测) | 文本提示 | 未来视频 | 第 5 节 |
| Cosmos-1.0-Autoregressive-4B / 12B | 当前视频 | 无,只看视频 | 未来视频 | 第 5 节 |
| Cosmos-1.0-Autoregressive-5B / 13B-Video2World | 过去视频 | 文本提示(按第 2.2 节的两步预训练推断) | 未来视频 | 第 2.2 节,表 10 |
| 相机控制后训练 | 所读段落没有写明 | 相机位姿 | 可以移动视角去探索的虚拟世界 | 引言,第 6.1 节 |
| 机器人指令视频预测 | 视频 | 语言指令 | 未来视频 | 第 6.2 节 |
| 机器人动作条件的下一帧预测 | 视频 | 机器人动作 | 下一帧,自回归地接成视频 | 第 6.2 节(Bridge) |
| 自动驾驶相关任务 | 所读段落没有写明 | 所读段落没有写明 | 所读段落没有写明 | 引言,第 6.3 节 |
| Cosmos-Transfer1 | 所读摘要没有说明 | 分割、深度、边缘等多种空间控制输入,可按位置加权 | 世界模拟(视频) | 2503.14492 摘要 |
扩散模型和自回归模型都把视频变成词元再处理:扩散一族用连续词元(Cosmos-1.0-Tokenizer-CV8x8x8),自回归一族用离散词元(Cosmos-1.0-Tokenizer-DV8x16x16)。论文说这些分词器是因果的,当前帧的词元不依赖未来的观测。
Transfer 在平台论文里先以设想出现:第 2.1 节说,世界模型可以微调成以深度、语义图这类渲染元数据为条件,用于 Sim2Real。Cosmos-Transfer1 是后来专门做这件事的论文,它的摘要写道:
We introduce Cosmos-Transfer, a conditional world generation model that can generate world simulations based on multiple spatial control inputs of various modalities such as segmentation, depth, and edge.
It allows weighting different conditional inputs differently at different spatial locations.
以下是虚构的教学例子。机械臂 D 把杯子放进篮子。想看“同一段动作换一种光照”,用的是 Transfer:c 是这段动作的分割图和深度图,杯子和篮子所在区域加大权重,背景放宽,输出是新的逼真画面。想看“如果夹爪早 0.2 秒松开会怎样”,用的是动作条件的 Predict:x 是松开前的画面,c 是改过的动作序列,输出是预测的后续画面。前者改的是外观,后者改的是未来;两者都只给出画面,画面里杯子是否真的按物理落下,要另外检查。
登录后继续阅读本课其余各节、自测题与答案。
局限 / 注意
- 两篇都是 NVIDIA 的 arXiv 预印本,属 R 级;结构、规模和评测数字都是作者对自家模型的报告,本站没有复现,也没有运行任何模型。
- 本课读的是平台论文 HTML v1 的摘要、引言、第 2 节、第 3 节开头的数据集一段、第 5 节开头与表 10,以及第 6.2 节中机器人评测的一部分;Cosmos-Transfer1 只读了摘要。所读段落没有给出 78.3% 的总比较次数和区间,也没有介绍 Cosmos-1X 数据集。
- 以下是本课的整理、算术或推断:条件表(其中 Autoregressive-5B / 13B-Video2World 以文本为条件,是按第 2.2 节的两步预训练推断的);78.3 与 13.0 相加为 91.3;FVD 降 68% 与 27%;训练数据占比与你的场景之间的关系;按区域设置 Transfer 权重的做法;第四节的整套验收规则。
- 第一节的夹爪例子,以及练习里的机器人 D、团队 Q、请求 R1–R6、片段 G1–G8、审计阈值、像素面积、真机片段和成功次数,都是虚构的,不是任何论文或系统的数据。
- 本课的数字只属于 Cosmos 1.0 平台论文和 Cosmos-Transfer1;站内雷达介绍的 Cosmos 3 是另一个版本。
- 纸面计算、仿真和生成画面的审计都不是硬件安全验证。
链接
- 物理AI实验室:一套每个数字都能核对的物理 AI 课程(课程大纲)
- 物理AI实验室 3.1:VLA 拆解,把一个放杯动作编成 256 个区间的词元,再给三个模型的参数量与频率标清口径
- 物理AI实验室 0.4:在虚拟世界练一万遍,给三个仿真数字补上实验条件
- 物理AI实验室 2.5:sim2real 的域随机化与系统辨识,把两篇论文的数字放回原设定,再从一条推杯轨迹手算摩擦
- 物理AI实验室 1.8:评测,把“净增 2”拆成配对表,再给失败标签和随机种子算一笔账
- 物理AI实验室 2.8:可复现评测,手算 Wald 与 Wilson 区间,从 1/√n 定评测次数,再给零失败算出失败率上界
- 前沿雷达|NVIDIA Cosmos 3 on AWS:一次前向给出推理、视频与动作,实例选型附了哪些验证条件
- 前沿雷达|WorldFailBench:用世界模型评测策略,成功率之外还要查失败原因、失败阶段和失败边界
- NVIDIA:Cosmos World Foundation Model Platform for Physical AI(arXiv 2501.03575,HTML v1)
- NVIDIA:Cosmos-Transfer1: Conditional World Generation with Adaptive Multimodal Control(arXiv 2503.14492)