机器人世界模型根据当前画面和一串机器人动作生成未来画面,可用于策略评测和基于模型的规划。要从没有动作标注的视频里学这种动力学,常用办法是潜动作模型:把相邻两帧之间的视觉变化编码成一个“代理动作”,靠重建下一帧来学习。问题是,重建目标会让潜动作把机器人自身的运动和物体的反应、其他场景变化一起编码进去,之后再把真实的机器人控制量映射到这个空间就不干净。来自哈尔滨工业大学(深圳)、新加坡国立大学 Show Lab 和平安科技的作者,在预印本 SkeLAM(arXiv 2610.31474,2026-10-22)里用机器人骨架图做监督,把潜动作拆成“运动学”和“残差”两部分,机器人动作只映射到运动学部分。作者报告,在 400 段 DROID 评测片段上,末端执行器平均位移误差(ADE)为 41.15 像素,比 DreamDojo 的 51.11 低 19.5%,感知误差 LPIPS 为 0.1310,比 0.1473 低 11.1%。本文重点读两件事:骨架只在训练时出现,部署时靠什么接上机器人动作;以及这些数字和策略评测结果各自的口径。以下数字均为作者报告 [R],本站未复现。
问题:重建出来的潜动作分不清“手臂怎么动”和“物体怎么反应”
论文举的例子是:相近的末端运动,在不同接触状态下会让物体产生不同的反应。如果潜动作同时编码这两者,从机器人动作回归潜动作时,回归目标里就带着与机器人运动无关、随场景而变的成分。作者并不想丢掉这部分信息,因为准确的仿真恰恰需要预测机器人运动怎样影响周围场景。所以设计是两个分量:一个专门的运动学分量,作为动作适配的目标;一个残差分量,保留补充的视觉动力学,用来学世界模型。
骨架图描述机器人的构型和运动,不含场景外观。已有工作(文中列了 OSCAR 等)把骨架序列或运动学渲染直接当生成条件;SkeLAM 的做法不同:骨架只用来监督从 RGB 中学出的运动学潜变量,部署接口只用 RGB 观测和机器人动作。
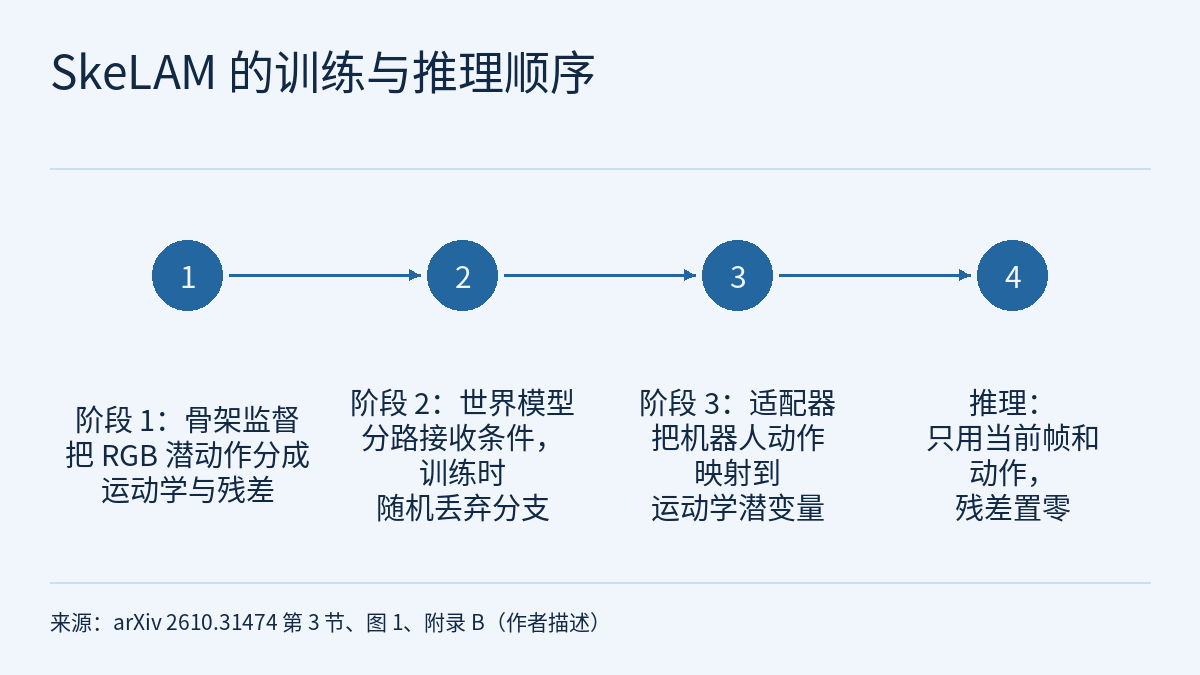
方法:三个训练阶段,骨架在第一阶段之后就退场
潜动作模型是两支 Transformer VAE,运动学和残差潜变量各 32 维;世界模型骨干是 Cosmos-Predict2.5-2B。附录给出的训练流程如下(K 为千次更新):
| 阶段 | 做什么 | 更新次数 |
|---|---|---|
| 1A | RGB 与骨架两支各自做条件重建:RGB 支由当前帧和两种潜变量重建下一帧,骨架支由当前骨架图和骨架运动潜变量重建下一张骨架图 | 60K |
| 1B | 冻结骨架编码器与解码器。把 RGB 运动学潜变量的后验均值送进冻结的骨架解码器,要求它重建下一张骨架图(grounding);再把它与配对的骨架运动潜变量做归一化对齐 | 20K |
| 1C | 交叉模态互换重建:把 RGB 运动学潜变量换成配对骨架的后验均值,残差保持不变,仍要求重建同一帧 RGB。之后冻结整个第一阶段模型 | 5K |
| 2A / 2B | 两个分量经各自的 MLP 投影作为世界模型条件;2A 只训练条件投影,2B 全量微调 DiT 骨干,期间按片段随机丢弃分支 | 5K / 20K |
| 3A / 3B | 3A 只训练一个 7→256→256→32 的 MLP 适配器,把机器人动作回归到运动学潜变量的后验均值;3B 用适配器的预测再全量微调世界模型,残差逐步撤掉 | 2K / 30K |
互换重建的作用。只在潜空间里对齐 RGB 与骨架,不能保证 RGB 解码器真正接受骨架那一侧的运动条件。互换重建让同一个解码器、同一个当前帧、同一个目标在两种运动学输入下都要成立,作者称这把跨模态对应从潜空间延伸到了重建层面。
分支丢弃。残差潜变量要用到未来帧,部署时拿不到。世界模型训练时,每个片段抽一种模式:两支都保留、两支都丢、只丢运动学、只丢残差;四种模式的概率在第二阶段前 1000 步为 0.80、0.10、0.05、0.05,之后为 0.50、0.10、0.05、0.35,“只丢残差”的比例提高。只丢残差的模式正好对应部署时“当前帧加运动学条件”的情形,监督目标始终是完整的未来片段。
动作接口。DROID 的动作被定义为相邻采样状态之间的 7 维变化量:机器人基座坐标系下的平移、相对旋转的旋转向量、下一时刻的夹爪开合度;不是关节空间指令,也不是相对片段起点的量。3B 阶段,残差在前 2000 次更新中以 0.5 的概率保留,在第 2000–7999 次更新间线性降到 0,此后为 0。推理时只给一帧观测和 12 步动作,残差和掩码都置零,生成 12 帧未来画面。
DROID 上的数字怎样读
评测集是 400 段 DROID 片段,从 400 条轨迹各取一段,按运动幅度四分位每档 100 条,并按相机分层。每段 1 帧条件加 12 帧未来,480×640 分辨率,15 FPS,跨度 0.8 秒。ADE 是图像平面上的二维末端位移误差,单位是像素,按相对首帧的位移计算。作者说明,末端追踪无效的轨迹不计入分数,但保留在覆盖率分母中,因此不同方法的有效子集可能不同;本文所据的文本没有给出各方法的有效轨迹数。
| 方法 | 控制接口 | LPIPS ↓ | ADE(px)↓ | 方向 F1 ↑ | 幅度相关 r ↑ |
|---|---|---|---|---|---|
| Ctrl-World | 动作嵌入 | 0.4029 | 42.96 | 0.5888 | 0.5154 |
| OSCAR | 骨架 | 0.4788 | 43.74 | 0.5810 | 0.5029 |
| DreamDojo | 动作 a(大规模交互预训练) | 0.1473 | 51.11 | 0.4989 | 0.3335 |
| CD-LAM | 动作→潜动作 z | 0.1586 | 53.90 | 0.4903 | 0.3179 |
| SkeLAM | 动作→运动学潜变量 | 0.1310 | 41.15 | 0.5465 | 0.5277 |
- 相对谁领先多少。作者称 SkeLAM 在动作条件模型中八项指标里七项第一,包括四项视觉保真指标。相对两个潜动作基线,ADE 分别低 19.5% 和 23.7%,LPIPS 分别低 11.1% 和 17.4%(本站按表核算一致)。但相对直接用动作嵌入的 Ctrl-World,ADE 只差 1.81 像素;Ctrl-World 和 OSCAR 的方向 F1 更高。SkeLAM 与 Ctrl-World 的主要差距在画面保真度,LPIPS 0.1310 对 0.4029。
- 消融。同一训练预算下各去掉一个组件:去掉骨架监督,ADE 升到 64.59,幅度相关降到 0.2009;去掉互换重建,ADE 升到 66.74,LPIPS 升到 0.1436;去掉动作适配的回归监督,ADE 升到 65.84;去掉残差,LPIPS 几乎不变(0.1305),ADE 升到 43.37。本站比对:去掉骨架监督、互换重建或适配回归中的任何一项,ADE 都高于两个潜动作基线(DreamDojo 51.11、CD-LAM 53.90),也就是说,单有“两个分量”的结构不够。
- 运动学分量里有什么。在冻结表示上训练线性探针预测末端位移:32 维运动学分量的 R² 为 0.3200,拼上残差的 64 维表示为 0.3277,DreamDojo 为 0.0078;使用特权骨架输入的骨架教师为 0.4312。另一组干预实验中,把 RGB 解码器的运动学输入换成配对骨架均值,重建 MAE 只增加 0.53%,换成不匹配的骨架则增加 11.67%;把运动学分量置零增加 5.78%,把残差置零增加 0.61%。
人到机器人的运动迁移与策略评测
迁移只有定性证据。作者用 UniSkill 的人类示范视频作运动提示:RGB 编码器从人类视频中提取潜动作,直接作为条件,给一帧机器人观测作为初始场景,所有参数不变。论文图中两个例子分别是推毛巾(末端向下伸)和拉纸巾(末端向上移),对照的 DreamDojo 预训练检查点末端位移有限。没有定量指标。
策略评测是开环回放。在 RoboArena 上,7 个策略、15 个会话,共 105 个回合。两个世界模型拿到相同的初始观测和真实执行时记录下来的动作,由人工标注生成画面中的任务是否成功,再与真实执行结果比较。唯一的对照是 Cosmos-Predict2.5,也就是 SkeLAM 世界模型骨干的出发点。
| 模型 | 平衡准确率 | 成功召回 | MCC | Spearman ρ | Pearson r | 成功率 MAE(百分点) |
|---|---|---|---|---|---|---|
| Cosmos-Predict2.5 | 48.44% | 0.00% | −0.0525 | −0.0756 | −0.1936 | 7.62 |
| SkeLAM | 63.02% | 33.33% | 0.2483 | 0.5347 | 0.6091 | 4.76 |
作者自己指出,33.33% 的成功召回偏低,说明在生成画面里再现成功结局仍然困难:真实成功的回合,只有三分之一在生成画面里也被判为成功。策略级相关系数只基于 7 个策略。若每个策略各 15 个回合(105 = 7×15,本站推断),单个策略的成功率以 6.67 个百分点为一档,4.76 个百分点的平均误差相当于 7 个策略合计约差 5 个回合,Cosmos-Predict2.5 的 7.62 约为 8 个回合(本站换算)。开环回放意味着策略看不到生成的画面、也不会对它作出反应;作者把闭环策略评测列为后续工作。
和本站其他内容的关系
本站此前写过两篇用世界模型估计策略成功率的论文:前沿雷达|Token-World 在 VLM token 空间里推演、不生成 RGB,前沿雷达|PhysCanvas 把触觉和任务状态拼进画布。SkeLAM 处理的是更上游的一步:动作怎样接进一个从视频学来的世界模型。三篇的策略、任务、标注方式和相关系数口径都不同,数字不能互比。前沿雷达|EgoJEPA 也从视频学潜动作,但用于训练策略;SkeLAM 的潜动作用于给世界模型提供条件。7 维状态变化量这类动作定义的差别,可以对照 物理AI实验室 1.5:数据从哪来 里讲的动作空间;7 个策略、105 个回合上的相关系数和召回,可以用 物理AI实验室 1.8:评测 的方法去读。
局限 / 注意
- 这是 arXiv 预印本,全部数字为作者报告 [R],本站没有复现。所读文本没有给出置信区间或多次随机种子的结果;DROID 推理每段只生成一次。
- 运动指标是单一相机画面上的二维像素量,依赖末端追踪;追踪无效的轨迹不计分,各方法的有效子集可能不同,所读文本没有列出有效数。
- 训练需要配对的 RGB 与骨架图。骨架图取自 OSCAR 对应子集的预渲染结果,依赖机器人运动学和相机投影;换一台机器人或没有标定的视频,能否得到这种监督,所读文本没有讨论。
- 人到机器人迁移只有两个定性例子。策略评测是开环回放、人工判定,只与 Cosmos-Predict2.5 比较,成功召回 33.33%;这既不是闭环评测,也不是硬件安全验证。
- 作者称一次完整训练在 NVIDIA A100 上约需 2 天,1B/1C 阶段在 8 块 A100 80GB 上训练;论文作者信息处列出了项目页,但所读文本没有说明代码或权重是否发布,本站未核实该页面内容。
链接
- Skeleton-Grounded Latent Action Model for Robot World Models(arXiv 2610.31474)
- 论文 HTML 全文
- 前沿雷达|Token-World:在 VLM token 空间里推演世界模型,不经 RGB 重建来模拟 VLA 策略
- 前沿雷达|PhysCanvas:把视觉、触觉和任务状态画进同一张画布,再用三个冻结的奖励模型让世界模型里的成败贴近真机
- 前沿雷达|EgoJEPA:不做人到机器人的重定向,从第一视角人类视频学潜动作,换机器人只加一对适配器再微调
- 物理AI实验室 1.5:数据从哪来,从 SO-101 元数据算出示范时长,再分清三条来路的单位与动作空间
- 物理AI实验室 1.8:评测,把“净增 2”拆成配对表,再给失败标签和随机种子算一笔账
- 物理AI实验室:一套每个数字都能核对的物理 AI 课程(课程大纲)