
BEHAVIOR Challenge 在 OmniGibson 仿真器里评测机器人完成长程家务的能力,2026 年这一届把任务从 50 项加到 100 项。Ilia Larchenko 等七位作者在 arXiv 2611.14432(2026-11-10)里报告了他们的参赛方案:一个基于 π0.5 的 VLA 检查点覆盖全部 100 项任务,另有 14 项任务交给先在训练实例上练习过的 GPT-6 Astra 编码智能体控制。作者称方案排名第 9,是前 10 名中唯一的独立团队。这份报告把一个训练好的学习策略和一个会练习的 LLM 智能体放在同一批任务上对照,并给出每回合的时间和费用;它也写清了怎样把已训练的多任务 VLA 扩到新任务、怎样用一次测量选训练超参数、怎样搭评测设施。下文数字均为作者报告 [R],组织方没有在私有测试集上复评这份提交,本站也没有运行作者的代码。
赛题与分数口径
2026 年的 100 项活动从打开收音机到做一顿饭,每项有 200 条遥操作示范,共 20,000 个回合、211M 帧,约 1,950 小时,格式为 LeRobot。机器人是 Galaxea R1Pro:全向底座、4 关节躯干、两条带平行夹爪的 7 自由度手臂,观测来自头部相机、两个腕部相机和本体感知。一个回合满足全部目标谓词算完全成功,记 1 分;否则 q-score(文中也写作 Q)是已满足谓词的比例。分数先在实例上平均,再在任务上平均。回合时限是该任务人类示范平均时长的 1.5 倍,2025 年是 2 倍。2025 年的 50 项任务及其示范原样保留,另 50 项是新的。
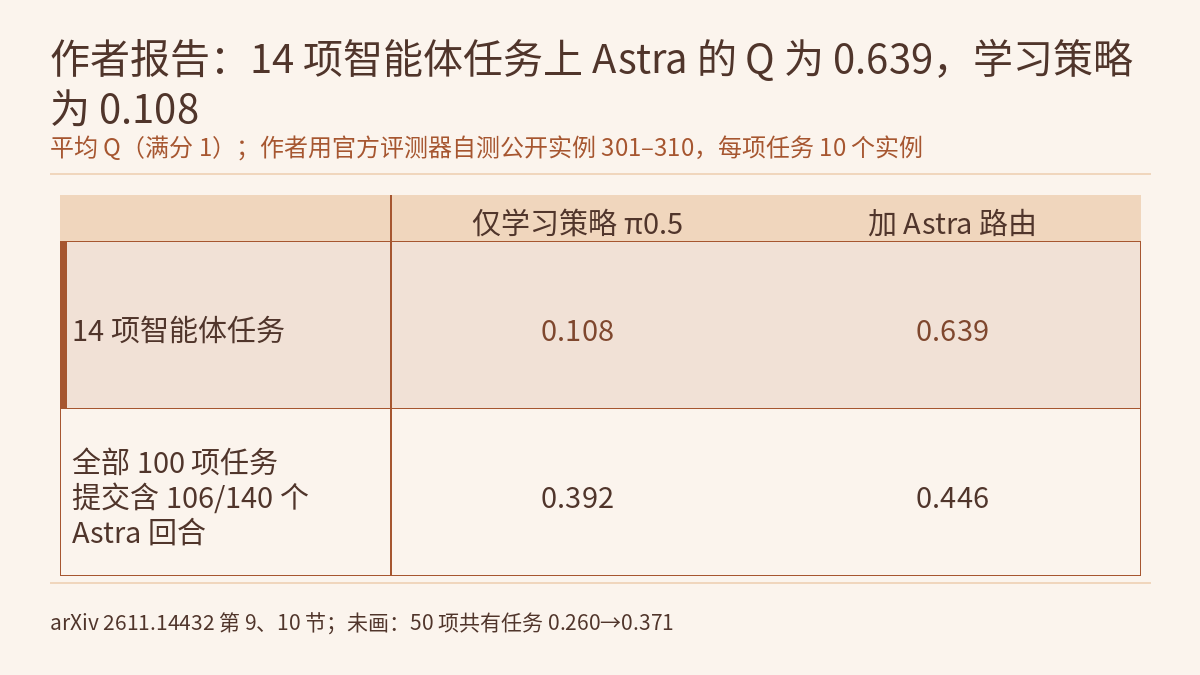
组织方只在私有测试集上复评了排名靠前的提交,这份不在其中。因此下文的分数是作者用官方评测器在公开实例 301–310 上自测的,每项任务 10 个实例。
一个检查点从 50 项扩到 100 项
2025 年作者用四个检查点分担 50 项任务,并认为模型明显欠训练:截止时损失还在下降。2026 年只用一个检查点,从 2025 年贡献分数最多的那个检查点热启动;新增参数都用零、单位阵或小方差正态分布初始化,使转换后的模型起点接近 2025 年的模型。改动主要有三处:
- 语义阶段。2025 年按时间把每个回合等分成 5–15 段当作“阶段”。作者用示范的技能标注检查后发现,一个时间阶段平均只有 50% 的帧属于其中最常见的标注步骤,1,093 个时间阶段中有 57% 没有任何步骤覆盖一半以上的帧。改用由标注构建的语义阶段后,100 项任务共 413 个阶段(每项 2–9 个)。
- 新任务的热启动。每个新任务的嵌入取 1–5 个相似旧任务嵌入的加权平均(按相似度排名,权重依次为 1、0.7、0.5、0.35、0.25),再缩放到源嵌入的平均范数;例如 freeze_fruit 从 freeze_pies 等三个旧任务出发。阶段嵌入按同样思路初始化。
- 21 维动作空间。2025 年模型预测 32 维,其中 23 维是真实自由度。JoyLo 遥操作只有两个躯干控制量(沿固定路径平移,以及给第三关节加倾斜偏置),数据里每条躯干指令都是这种形式,于是模型改为预测 translate 和 tilt,再映射回四个关节。作者还只保留 Gemma 词表 257,152 行中实际用到的 256 行,去掉 526M 个不接收梯度的参数,每个检查点约小 8 GB。
训练共 200k 步:先在 1 块 B300 上以批大小 480 跑 130k 步,再在 8 块 H200 上以批大小 2048 跑 70k 步,学习率按批大小的平方根放大。模型总共看了约 200M 个样本,大致相当于把示范的 211M 帧过一遍。在与 2025 年共有的 50 项任务上,Q 从 0.260 升到 0.371;全部 100 项任务上为 0.392。作者明确说,不能把提升只归于训练更久:策略还见到了另外 50 项任务的示范,模型也有改进和 bug 修复;2026 年的时限缩短了 25%,两年所用的仿真器版本也不同(作者称没有观察到有意义的差别)。
用一次梯度噪声测量选流匹配样本数
π0 一类模型训练时,VLM 前缀最贵,动作专家很便宜,所以每个观测只算一次前缀,再让动作专家跑 K 组(流时间, 噪声)样本。作者用探针在固定参数下逐一重采样各个噪声来源,测得 2025 年的设置(K = 15,独立采样)中,梯度方差有 21% 来自流采样,38% 来自数据增强,42% 来自批里选了哪些观测。三项里只有流采样一项会随 K 增大而缩小。
作者用了两种不改变期望损失的降方差做法:流时间按 Beta(1.5, 1) 的分位区间分层采样,相邻区间共用一组符号相反的噪声。作者报告,分层使同一 K 下的流方差项减半,对偶噪声再去掉 17%。
K 本身怎么选:步时 T = B(c_p + c_k·K),噪声乘时间 J(K) ∝ (c_p + c_k·K)(V_oa + V_f/K),对 K 求极小得 K* = √((c_p/c_k)·(V_f/V_oa))。作者在一块 B300 上测得 c_p = 21.4 ms、c_k = 0.30 ms,新采样器下 V_f/V_oa = 1.43,得 K* ≈ 10,K 在 8 到 14 之间时 J 与最优相差不到 1.5%。本站代入复算为 √(71.3 × 1.43) ≈ 10.1,与作者一致。与 2025 年的设置相比,K = 10 的新采样器把方差乘时间降低约 13%,作者把它说成相当于免费把批增大 13%。所需输入只有两次 50 步的计时和一次方差探针。按本站理解,这套估算不依赖 BEHAVIOR 本身,共享前缀、多次采样动作头的流匹配训练都可以照此测一遍;作者没有报告它对最终成功率的单独影响。
评测设施:记录可追溯,仿真合计快于实时
100 项长任务的评测很贵:一个回合的墙钟时间可达几十分钟,仿真器启动要 6–9 分钟。比赛期间作者共跑了约 9,000 个评测回合,约 100M 个环境步、近 1,000 个仿真小时。每次运行附一份清单,记录代码版本与 diff、仿真器和软件包版本、全部评测与服务参数,以及所用检查点的校验和。机器人和场景中全部物体的状态在开始时、每 30 步和结束时保存,可以载入新的仿真器,从失败附近重放或做恢复实验。
提速主要靠让 CPU 一直做有用的工作。仿真器只启动一次,每个实例开始前恢复启动时保存的场景,约 10 秒,重启则要 7.6 分钟。一个环境槽位结束就立即补上新回合;按作者的说法,官方的向量化评测器有 45–48% 的步数浪费在等最慢的回合上。一个策略服务器批量处理所有环境的推理。一块 RTX PRO 6000 上同时跑六个仿真器,合计每秒 33 个环境步,而仿真时间是每秒 30 步,即 1.11 倍实时。这是六个仿真器的合计:单个仿真器约每秒 5.5 步,单个回合仍慢于实时;算上启动和批次收尾不齐,整个机群约为每 GPU 0.86 倍实时。100 项任务各 10 个实例的完整评测,在八台机器上约需 20 小时,约 300 美元。
14 项任务交给先练习过的 GPT-6 Astra
作者先试过另一种方案:学习策略主控,GPT-6.1 Sol 监视画面,策略卡住时让 Astra 做有限次恢复(每回合最多三次,每次最多 900 个动作)。他们没有找到能归功于干预的提升,也没有提交这一方案。
最终方案按任务分流。每项任务先有一个练习会话:GPT-6 Astra 在 Pi 编码智能体里,对着一个装有训练实例的仿真器(从不使用评测实例)列出难点,逐段保存场景、尝试、读取哪些目标条件成立;屡次失败就对照两三条人类示范修改动作;最后从全新重置开始、不用恢复、在官方步数限制内跑完整个任务,并为后来的自己写下流程。重置、保存、恢复和目标反馈是只在练习中存在的特权工具。整个过程不训练任何权重,学到的东西留在对话(每项任务 29–395 MB)、笔记和配方里。
评测时,每个回合都从该任务冻结会话的新副本开始,只拿到官方观测。Astra 不直接输出底层动作,而是写短程序调用 observe、xyz、act 三个工具,一次发一个目标;控制器以 30 Hz 每步做一次逆运动学,到达目标、运动停滞或到步数上限时返回结果。作者说,工具的三轮修改比提示词的措辞更重要:改为每次调用一个目标并逐步闭环后,自由运动到达目标的误差在 0.83 mm 以内;改用深度图估计位置后,与仿真真值的最大误差为 1.06 μm(3,598 个样本);底座速度限制在 0.20 m/s,避免长距离移动时摔倒。
练习能否迁移,作者在没见过、场景布局不同的训练实例上检验:最后两天里,只靠笔记的首次尝试 17 次成功 8 次。作者练习了 27 项任务,选出 14 项交给智能体,条件是学习策略在这些任务上很弱(平均 Q 0.108),并且智能体在作者自己的测试中更好,或者策略得分接近零。智能体运行出错时(连续三次回答超时、API 错误、达到费用或墙钟上限),由学习策略接手本回合剩下的部分。
作者报告,这 14 项任务上 Astra 的平均 Q 为 0.639,学习策略单独为 0.108;installing_smoke_detectors 上 Astra 得 1.0,策略得 0.10。代价也写在报告里:一个智能体回合的墙钟时间中位数为 0.63 小时,约为实时的 17 倍,API 费用每回合几十美元。由于时间不够,公开结果只含 140 个智能体回合中的 106 个;公开提交的得分为 Q 0.446、完全成功率 27.3%。若把 0.639 全部计入,按任务平均,100 项的均值约为 0.466(本站推算,假设 0.392 与 0.108 来自同一批策略回合)。0.446 低于这个值,与只纳入部分 Astra 回合的说明相符。
本站介绍过的 GPT-GEAR 是另一篇让 GPT-6 Astra 只靠工具直接控机械臂的预印本;这份报告补充的是在长程家务基准上与训练好的 VLA 按任务对照,并给出每回合的时间与费用。智能体直接控制机器人时怎样做风险审查,见 LEASH。物理AI实验室 3.4 讲过多策略路由和只换高层的路由消融;这里的路由是赛前按任务固定的一张表,任务是根据作者自己的试验挑出的,所以 0.639 对 0.108 只描述这 14 项被挑出的任务,不能外推成智能体在全部任务上都优于策略。
和 2025 年相比,失败少在哪里
在两年都人工复查过的 10 项任务上,完全成功率从 2025 年提交的 20% 升到 2026 年学习策略的 36%。按作者人工标注的失败原因(一个回合有多个原因时平均分摊),顺序错误从 13.0 降到 6.7 个回合,摔倒从 7.2 降到 4.5,卡住从 2.8 降到 0,灵巧操作失败没有减少(29.8 对 32.2)。作者复查 2025 年的失败后,把相当一部分顺序错误追溯到示范在任务完成后的空闲尾段:2025 年训练用了这些帧,而官方评测在成功时就结束,2026 年的数据加载器在完成点截断示范。作者认为对齐更好的语义阶段可能也减少了顺序错误。改用 21 维动作空间后,策略给不出示范里没出现过的躯干构型,作者观察到深蹲时摔倒更少,并称摔倒计数下降与此相符;同一改动可能也解释了卡住的减少。作者解释,走到困难操作步骤的回合更多了,灵巧性的短板也就更显眼。论文没有用消融单独检验这些归因。怎样读这类失败标签,可以对照 物理AI实验室 1.8。
也有变差的任务:cook_bacon 从 0.757 降到 0。作者发现 2026 年公开评测中 7/10 个实例把培根托盘放在冰箱下层,比全部 199 条训练示范中的位置低约 41 cm,认为这可能是原因之一,但另外三个实例同样是零分。两种恢复数据只在单项任务上有小幅效果:脚本化恢复把 turning_on_radio 的成功率从约 50% 提高到 60–75%;人工纠正让一项任务的 Q 从 0.267 升到 0.367,单侧配对置换检验 p = 0.131,不显著。作者没能把它们扩展到 100 项任务。
局限 / 注意
- 这是 arXiv 上的参赛报告,全部数字为作者报告 [R]。组织方没有在私有测试集上复评这份提交,分数来自作者在公开实例 301–310 上的自测;“排名第 9、前 10 中唯一的独立团队”是作者的说法,本站没有核对排行榜。
- 14 项智能体任务是作者根据自己的试验挑出的、学习策略很弱的任务,其中部分任务没有完整成功的练习就被路由给智能体;论文没有给出 0.639 与 0.108 的区间。
- 50 项共有任务上的 0.260→0.371 混合了更长的训练、更多任务的数据、模型改动和 bug 修复,时限和仿真器版本也不同,不能归因于单一改动。寄存器、草稿 token 和注意力汇点是作者加进模型的专用 token 和每层可学习的汇点,用来给预训练 SigLIP 中错放的注意力一个专门的去处,主要目的是让注意力图能读、便于调试(论文第 4 节)。这组改动没有做消融,作者说除了便于调试,没有证据表明它们提高成功率。
- 全部结果来自 OmniGibson 仿真。Astra 回合约为实时的 17 倍,每回合几十美元,仿真在它思考时暂停等待。这些都不是真机或硬件安全验证。
- 论文给出了代码、检查点和项目页的地址,本站没有打开或运行它们。
链接
- One Policy for 100 Household Tasks: Our Solution for the 2026 BEHAVIOR Challenge(arXiv 2611.14432)
- 论文 HTML 全文
- 物理AI实验室 3.4:长程任务,手算单步与整条链的成功率,看进度记忆改变了哪一项,再审一次只换高层的路由消融
- 物理AI实验室 1.8:评测,把“净增 2”拆成配对表,再给失败标签和随机种子算一笔账
- 前沿雷达|GPT-GEAR:不训练动作策略,让 GPT-6 Astra 用五个工具直接控机械臂,深度、触觉和示范怎样给比给不给更关键
- 前沿雷达|LEASH:基础模型直接控机械臂时,在每轮规划前、每步动作前和松爪倾倒前分三处审查,作者用 RoboRisk 的五类风险检验
- 物理AI实验室:一套每个数字都能核对的物理 AI 课程


