
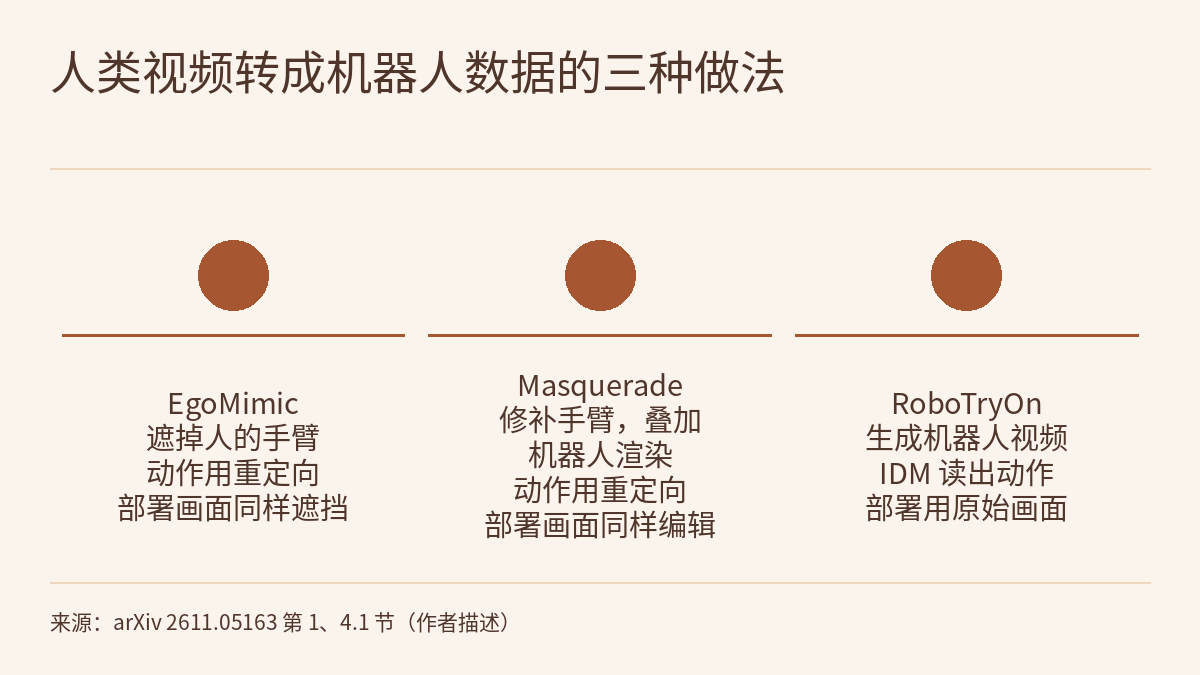
用人类视频教灵巧手,常见做法是在画面上把人的手臂遮掉或叠一个渲染的机器人,再把重建出的人手姿态重定向成机器人关节指令。预印本 RoboTryOn(arXiv 2611.05163,2026-11-03)换了顺序:先像“虚拟试衣”那样,保留示范的动作、任务、物体和背景,只把画面里的人换成目标机器人,生成一段机器人视频;再用逆动力学模型(IDM)从生成的视频里读出关节动作标签。作者报告,在两台双臂灵巧手机器人上,7 个没有任何遥操作示范的任务平均成功率从 2.1% 升到 60.0%。这篇论文值得细读的地方,是它把“视觉差距”和“动作差距”分开量了一遍,而“约三分之一采集成本”只数了采集人时。以下数字均为作者报告 [R],本站未复现。
思路:保留动作,换掉身体
论文认为人类视频和机器人示范之间隔着两道差距。视觉上,人类视频里是人的手臂,部署时策略看到的是机器人;此前的做法靠遮挡手臂或叠加渲染机器人来缩小差距,但训练和部署时都要对机器人相机画面做同样的编辑。动作上,重建的手部姿态本身不准,人手和机器人手的形态、运动学也不同,不存在精确的重定向映射;论文还指出,即使映射完美,也只复现手的形状,不包含抓握要用多大的力。
RoboTryOn 的流程分三步,三个模型和后面的策略都按条件 flow matching 训练:
- 关键帧翻译:从重建的双手腕轨迹里选关键帧,条件是两只手腕的速度都到局部最小(画面不模糊),且有一只手腕离上一关键帧移动超过阈值;首帧和末帧总是入选。图像模型把人手臂区域遮住、画上手部骨架,按参考图像补画出目标机器人;每个关键帧都以上一个已翻译的机器人关键帧为参考,第一帧的参考图像决定用哪台机器人。遮罩被放大并平滑,轮廓不泄露下面是谁的手。
- 视频合成:视频模型在相邻关键帧之间插值,运动由人手骨架序列引导。训练时骨架会被扰动和随机丢弃,所以它只给出手的大致位置和运动,手指细节来自模型学到的机器人手先验。
- 伪动作标签:IDM 从相隔 K 步的两帧预测其间的一段关节空间动作,用遥操作数据的真实动作训练;状态由动作按遥操作数据测得的延迟推出。因为 IDM 估计手腕位置不如手部重建准,作者用逆运动学把手腕位置换成重建值,手指关节仍用 IDM 的预测。
三个生成与标注模型只用机器人数据训练:四个分布内任务的遥操作示范,加上额外的机器人视频(不用于训练任何策略)。推理时从人类视频提取同样的遮罩和骨架条件,所以不需要成对的人–机示范。
实验设置:两台机器人、11 个桌面任务
两台机器人都是双臂灵巧手:OpenArm 有两条 7 自由度手臂和两只 6 自由度的 Inspire RH56F1 手;RB-Y1 有两条 7 自由度手臂和两只 20 自由度的 WujiHand2 手。每台机器人测 11 个任务:
- 分布内(4 个抓放):PnP Bottle、Doll、Box、Ball,每个任务每台机器人 50 段遥操作示范,另有 50 段人类视频。
- 分布外(7 个):每个任务只有 50 段人类视频,没有机器人示范。其中新物体 1 个(PnP Coffee Pot)、新目标 1 个(PnP Bottle to Shelf)、新技能 2 个(Pouring、Brushing)、双手协作 3 个(Box Convey、Air Fryer、PnP Ball in Cup)。所有遥操作示范都是单臂任务。
策略是微调的 π0.5,三种数据组合训练步数相同:200 段遥操作(每个分布内任务 50 段)、550 段 RoboTryOn 合成示范(11 个任务各 50 段),或两者合计 750 段。每个任务测 28 次,物体位置随机。对照组 EgoMimic 在人类画面里遮掉手臂,Masquerade 把手臂修补掉后合成重定向姿态的机器人渲染;两者都用重定向的手部动作,并按各自协议对部署时的实时画面做同样编辑。RoboTryOn 部署时用原始相机画面。
主结果:分布外 7 个任务从几乎为零到 73.0% 和 46.9%
| 数据(OpenArm / RB-Y1) | 分布内 4 任务 | 分布外 7 任务平均 | 其中双手 3 任务 |
|---|---|---|---|
| 仅遥操作 | 47.3% / 69.6% | 3.1% / 1.0% | 0.0% / 0.0% |
| 遥操作 + EgoMimic | 50.0% / 63.4% | 5.1% / 5.1% | 0.0% / 0.0% |
| 遥操作 + Masquerade | 67.9% / 63.4% | 8.2% / 7.7% | 0.0% / 0.0% |
| 遥操作 + RoboTryOn | 75.9% / 79.5% | 73.0% / 46.9% | 63.1% / 28.6% |
| 仅 RoboTryOn 合成数据 | 57.1% / 60.7% | 48.5% / 40.3% | 38.1% / 16.7% |
摘要里的“2% 到 60%”是两台机器人分布外平均值再取平均:(3.1 + 1.0) / 2 ≈ 2.1,(73.0 + 46.9) / 2 ≈ 60.0;双手任务的 45.9% 同理。两台机器人的差距不小:RB-Y1 上双手任务只有 28.6%。分母也要记住:分布外 7 个任务每台机器人共 196 次试验,本站换算 OpenArm 的 3.1% 和 73.0% 约为 6 次和 143 次成功;只含 1 个任务的列(新物体、新目标)每台机器人只有 28 次试验,例如新目标的 89.3% 是 25/28。所读正文的表 1 没有给出置信区间,逐任务结果在附录 F.2,本站没有读到。
作者另做了两组检查。消融(OpenArm):去掉手部骨架引导,分布外从 73.0% 降到 21.4%,是降幅最大的一项;只用第一个关键帧时为 39.3%;去掉手腕校正为 48.0%。换策略骨干:在另一种结构的 VLA RLDX-1-Img 上,分布外从 0.0% 升到 40.3%,分布内从 53.6% 升到 60.7%。
两道差距各用什么量,量到了哪一步
视觉差距:用 π0.5 的 SigLIP 视觉编码器编码各类画面,与真实机器人画面比较 Fréchet SigLIP 距离。RoboTryOn 合成视频从原始人类视频的 125.5 降到 32.7;作者称叠加渲染约减半,遮挡基本不变。这说明合成画面在策略自己的特征空间里接近真实机器人画面,不说明合成视频里的接触和物体运动在物理上正确。
动作差距:生成的视频没有真实动作可对照,作者把动作标签在每个场景的仿真复制品里开环回放,看任务能否完成。三个抓放任务共 66 段:IDM 标签 69.7%,不做手腕校正 63.6%,重定向标签 34.8%。作者说差别主要出在抓取那一下:重定向能把手带到物体附近,却抓不牢。这是在仿真中检验标签本身,不是真机策略成功率。
与遥操作数据是否“同向”:在 π0.5 预训练权重处,分别对遥操作分布内数据和各分布外任务数据求 flow matching 损失的梯度,再算两者的余弦相似度。RoboTryOn 数据为 0.53,两个对照为 0.17 和 0.14;只看动作专家部分,RoboTryOn 为 0.51,重定向数据略为负值(−0.03、−0.05)。作者据此推测重定向标签把策略推向与遥操作数据冲突的方向,“可能解释”对照组在分布外几乎没有提升。这是一个相关性的解释,不是因果证明。
“约三分之一采集成本”算的是什么
成本实验只在 4 个分布内任务上做,改变每个任务的示范数,按采集人时画成功率曲线。作者报告录一段人类视频约是遥操作一段的五分之一时间;只用翻译后的人类视频,约三分之一的采集成本就达到每任务 50 段遥操作的成功率;在遥操作数据上加同等数量的人类视频,成功率从 47.3% 升到 71.4%,多录不到一小时。71.4% 来自这组规模实验,表 1 的 75.9% 用的是含全部 11 个任务的 750 段组合,两者不是同一设置。
这笔账没有算进去的有三项,前两项在论文的局限一节(附录 A),第三项在第 4.1 节“实现细节”。一是生成和标注要算力,作者明说合成是用计算换采集时间;二是每接入一台新机器人,仍要先录几小时那台机器人的遥操作视频(任务不限)来训练生成模型和 IDM;三是三个模型本身也用了分布内任务的遥操作示范。所以“分布外任务没有机器人示范”成立,“整个系统不需要机器人数据”不成立。
速度也会被继承:人类示范者的速度约是遥操作的 1.25 倍。把骨架序列重新定时到遥操作速度再合成,分布内从 75.9% 升到 85.7%,分布外为 70.4%;按 2 倍速合成,策略最快,但两组成功率都下降(57.1%、42.9%)。
和站内已有内容的关系
物理AI实验室 1.5:数据从哪来说人类视频的难处是“人手不是机器手”,没有精确的关节角,也没有力。RoboTryOn 的处理是不直接翻译人手,而是先在像素上换成机器人手,再让 IDM 读出关节;力的问题它没有解决,作者自己写明伪标签捕捉不到力。物理AI实验室 1.6:模仿学习讲过示范覆盖范围;作者对分布内提升的解释正是合成示范覆盖了更多物体摆放和手臂动作。物理AI实验室 1.8:评测练过先问分母,本文的每个百分数都应连同“哪台机器人、哪组任务、每任务 28 次”一起转述。
同样想绕开重定向的还有 前沿雷达|EgoJEPA,它从第一视角人类视频学潜动作,换机器人时新增一对适配器再微调;前沿雷达|DexStitch 也把人类视频转换成灵巧手数据,用的是接触引导的修补。三篇论文的机器人、任务和试验次数都不同,成功率不能横向比较。
局限 / 注意
- 这是 arXiv 预印本,全部数字为作者报告 [R],本站没有复现。作者来自 KAIST 与 RLWRLD,论文由 RLWRLD Inc. 资助;用作第二个骨干的 RLDX-1 技术报告作者名单中也有本文作者 Suhyeok Jang。所读文本中没有代码或数据发布信息。
- 人类视频从机器人头部相机的位置录制,遥操作数据中机器人颈部和底座固定。作者写明,移动相机(如野外第一视角视频)超出视频模型和 IDM 的训练分布,IDM 总是预测颈部和底座不动。
- 动作是伪标签:IDM 从像素读关节,手腕位置来自手部重建,捕捉不到力,精度受立体视频和手部重建限制;紧配合插入这类依赖力或精度的任务还标不准。手腕校正依赖头部相机标定。
- 示范动作必须是机器人做得到的:流程可以重新定时,但纠正不了超出臂展的位置或机器人手做不出的抓法。
- 评测只覆盖两台机器人的桌面操作,每任务 28 次,表 1 没有置信区间。作者也把人类视频翻译到了 GR-1,但没有实体机器人,无法评测策略。
- 成本只按采集人时计,不含生成与标注的算力,也不含每台新机器人几小时的遥操作视频。本文结果不构成硬件安全验证。
链接
- RoboTryOn: Synthesizing Dexterous Robot Demonstrations from Human Videos via Virtual Try-On(arXiv 2611.05163)
- 论文 HTML 全文
- 物理AI实验室 1.5:数据从哪来,从 SO-101 元数据算出示范时长,再分清三条来路的单位与动作空间
- 物理AI实验室 1.6:模仿学习,手算误差怎样滚出示范覆盖范围,再把 ACT、扩散策略与数据规模律的数字放回各自条件
- 物理AI实验室 1.8:评测,把“净增 2”拆成配对表,再给失败标签和随机种子算一笔账
- 前沿雷达|EgoJEPA:不做人到机器人的重定向,从第一视角人类视频学潜动作,换机器人只加一对适配器再微调
- 前沿雷达|DexStitch:把“过渡”也标成一个技能,从人类视频切出、转换并拼接灵巧手技能
- 物理AI实验室:一套每个数字都能核对的物理 AI 课程(课程大纲)


