
预印本 Online Hamilton–Jacobi Reachability Onboard the Robot Control Loop(arXiv 2611.04096,2026-11-03,作者 Kevin Weekly(Mirror AI)与 Alexandre M. Bayen(UC Berkeley))没有提出新的数值格式。它把 Hamilton–Jacobi(HJ)可达性分析里的标准水平集求解器(WENO5 + TVD-RK3 + Lax–Friedrichs)写成 CUDA 核函数,让后向可达管(backward reachable tube,BRT)可以在机器人控制回路里按节拍重算,而不是在任务开始前离线算一次。作者报告,在一块 RTX 4000 Ada 工作站显卡上用 FP32,经典的 3D Air3D 案例单次求解 8.91 ms,约 112 Hz;在 Jetson AGX Thor 上,N = 41 时为 66 Hz。读这些数字要连同网格分辨率、精度和状态维数一起看:论文只覆盖 2D 到 4D,安全保证也只相对于写下的动力学与扰动模型成立。以下数字均为作者报告 [R],本站未复现。
后向可达管是什么,为什么要在线算
论文沿用 Mitchell、Bayen 与 Tomlin 的定义。系统 ẋ = f(x, u, d) 有控制 u 和扰动 d,失效集由带符号距离函数 ℓ 描述(ℓ(x) ≤ 0 即失效)。时域 T 的后向可达管是这样一组初始状态:无论控制怎么选,最坏的扰动都能在 T 之内把系统推进失效集。它等于值函数 V 的零下水平集 {x : V(t, x) ≤ 0};V 满足 Hamilton–Jacobi–Isaacs(HJI)偏微分方程,哈密顿量取 max_u min_d pᵀf(x, u, d),表示最坏情况下控制与扰动的博弈。
作者把 BRT 的三条性质分开讲:管内的状态,在最坏扰动下无法避免失效;管外的任一状态,总存在一个控制能在时域内保持安全;在管的边界上,必须施加至少一个特定的控制,才能不被扰动推进管内。据此构造的安全过滤器放在学习的规划器下游,要么认可它提出的动作,要么用值函数导出的控制替换它。
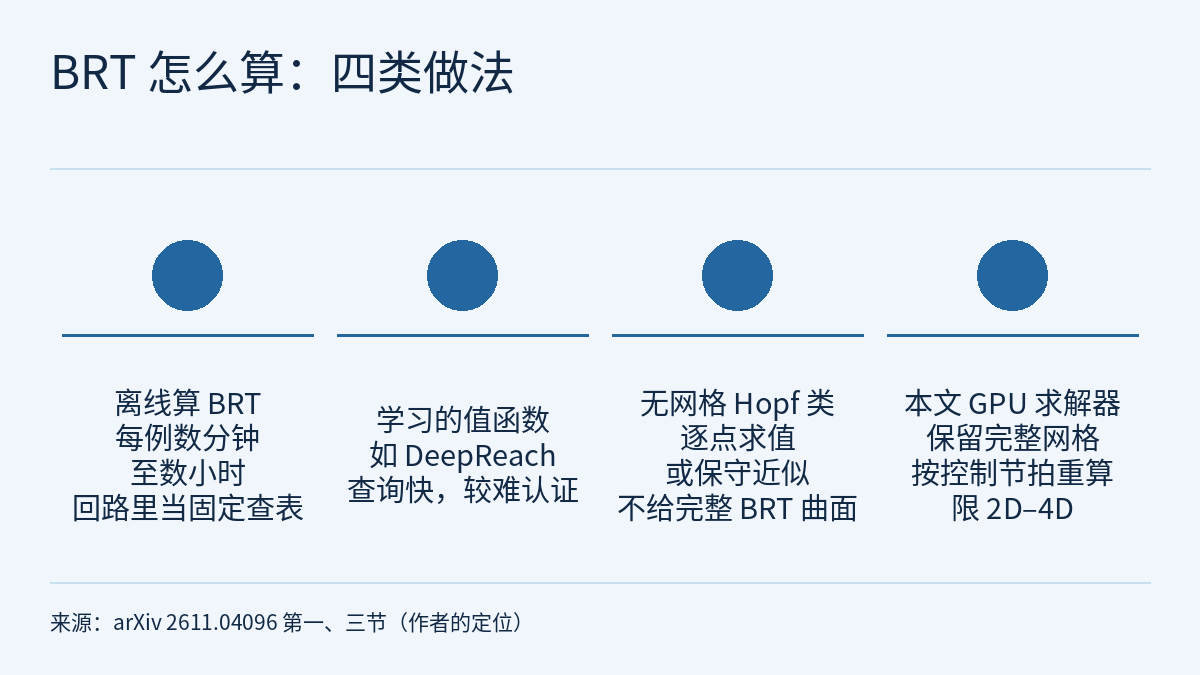
难处在于,网格上的水平集计算量随状态维数指数增长。过去的做法是离线算一次 BRT(论文称,以往工作通常每个案例要几分钟到几小时),再在控制回路里当固定查找表用。作者的论点是:扰动模型、障碍或动力学事先未知时,过时的 BRT 就是过时的安全保证。
论文在相关工作里给自己定了位置。DeepReach 等方法用神经网络拟合值函数,查询快,但更难认证;Hopf 类无网格方法逐点求值或给出保守近似,不给完整的 BRT 曲面。本文保留完整网格,把整面求解本身做快。DualGuard MPPI 把预先算好的 BRT 当作采样式 MPC 的硬约束,作者称自己的工作在它的上游:把预计算换成在线重算。
求解器:格式不变,换成融合的 CUDA 核函数
格式是标准做法:每个方向用六点模板的五阶 WENO5 重构梯度,数值哈密顿量用 Lax–Friedrichs 耗散(支持全局、局部、局部-局部三种),时间积分用三阶 TVD Runge–Kutta,步长满足 Δt·α_max/Δx ≤ 0.75。每个时间步后做 Mitchell 的 BRT 截断 V ← min(V_new, V_old),让 V 在反向积分中单调不增。作者称,提速来自离散格式本身暴露出的结构:
- 每个 RK3 阶段一个融合核函数。WENO5 重构、哈密顿量、阶段组合,以及最后一个阶段的 BRT 截断,都在寄存器里完成,阶段的右端项不经过全局内存;第三阶段原地写 V,省掉每步一次复制。
- WENO5 只做一次除法。权重归一化经过代数改写,一次重构从教科书写法的 13 次除法降到 1 次,结果在舍入误差内一致。作者指出,消费级 GPU 的 FP64 除法由软件实现,
--use_fast_math也不作用于双精度。 - CFL 步长在主机端只算一次。文中所有哈密顿量的波速上界都不随时间变化,所以不必在每个阶段做一次全网格归约。
- 模板直接从 L2 缓存取数。控制节拍下的网格整块放得进 L2(101³ 个 FP32 值约 4 MB,L2 为 40 MB)。作者测得,用共享内存分块的 3D 模板吞吐量约为直接取数的三分之一。
- 3D 求解器把整步录成 CUDA graph 回放。精度通过模板参数在 float 与 double 之间切换,FP32 模式面向嵌入式部署。
作为对照,作者另写了一个相同格式的 PyTorch 实现,用 torch.compile 编译。他们的解释是:上面几项是关于离散格式的代数恒等式和数据流事实,通用张量编译器在 IEEE 语义下不能自行假设。作者也写明,torch.compile 路线更容易编写和修改,并且带自动微分。
先对齐参考实现,再谈速度
参考实现是 Stanford ASL 的 JAX 库 hj_reachability。八个案例(2D 完整约束系统、双积分器、三种受风漂流器、3D Air3D、两种 4D 追逃)用同一份 JSON 规格,两边都用 WENO5、TVD-RK3、CFL 0.75 和 FP64。两边的截断算子不同:本文每个完整 RK3 步截断一次,hj_reachability 在每个子阶段截断哈密顿量;作者说明,报告的一致性是在这个差异存在的情况下测得的。
- 最大匹配网格上的逐点 L∞ 差:2D 案例为 0.00217–0.0130,Air3D 为 0.0223,4D 追逃为 0.347(V 的取值范围约 2.6)。作者认为差异主要来自 BRT 非光滑边界的抹平,而不是光滑区域的截断误差。
- Air3D(t = 2 s,两车速度 5 m/s,最大角速度 1 rad/s,5 m 碰撞圆柱)在 N = 51 时,两边的 BRT 格子数相差 4 个,总数约 11,200,即 0.04%。
- 4D 追逃在默认设置下,本文的 BRT 比参考小 7.1–7.5%。作者把差距归于两处格式选择:本文用梯度局部的 Lax–Friedrichs 系数,非周期边界用线性外推。两处对齐后,N = 31、41、51 的格子数差为 0.6%、0.4%、0.3%。
- FP64 单次求解在六种不同动力学上比 JAX 快 2.0–4.6 倍,比
torch.compile快 1.3–1.4 倍;按相同 L∞ 精度目标比较,比 JAX-GPU 快 3.1–4.9 倍。
实时数字要连同网格和精度一起读
闭环里要用的是 FP32。作者报告,在 RTX 4000 Ada 上,FP32 比自己的 FP64 快 21–33 倍;2D、3D 案例的 FP32 BRT 与 FP64 逐格一致,4D 案例最多差 0.1% 的格子。下表摘自论文表 IV,“频率”是单次求解时间的倒数:
| 案例 | 维数 | N | 本文(ms) | 频率 | JAX(ms) | torch.compile(ms) |
|---|---|---|---|---|---|---|
| air3d | 3D | 51 | 8.91 | 112 Hz | 52.3 | 50.0 |
| air3d | 3D | 101 | 102 | 9.8 Hz | 804 | 178 |
| drifter_const | 2D | 200 | 6.82 | 147 Hz | 86.4 | 107 |
| drifter_wg | 2D | 200 | 13.6 | 74 Hz | 159 | 223 |
| pe_4d | 4D | 31 | 16.4 | 61 Hz | 150 | 27.6 |
| pe_4d | 4D | 51 | 222 | 4.5 Hz | 3885 | 573 |
同一个 Air3D,N 从 51 提到 101,频率从 112 Hz 降到 9.8 Hz;同一个 4D 追逃,N = 31 是 61 Hz,N = 51 只有 4.5 Hz。按论文图 3 的扫描,FP32 下能进 30 Hz 预算的是:Air3D 到 N = 71(36 Hz),4D 追逃到 N = 31,2D 漂流器到 N = 200;能进 100 Hz 预算的是 Air3D 到 N = 51 和恒定风漂流器到 N = 200。同硬件、同为 FP32 时,本文比 hj_reachability 快 5.9–17.5 倍(表 IV),在整个扫描上为 5.7–17 倍(图 3),比 torch.compile 快 1.7–16 倍。
Jetson AGX Thor 开发套件(T5000 模组,2560 核 Blackwell GPU,128 GB LPDDR5X 统一内存,120 W 功耗模式上限)用同一份源码编译。作者报告,单次求解比桌面慢 2.7–3.5 倍:Air3D 在 N = 41 时 15.1 ms(66 Hz),N = 51 时 28.9 ms(35 Hz);漂流器在 N = 200 时,恒定风 18.6 ms(54 Hz),空间变化风 37.1 ms(27 Hz);4D 追逃在 N = 31 时 53.9 ms(19 Hz)。同设备上比 hj_reachability 快 3.8–8.9 倍,但这里的 JAX 用的是 XLA 默认、未调优的融合配置,因为 jaxlib 0.10.0 的自动调优不能在 sm_110 上运行。
多智能体演示:一次求解得到六架无人机的分区
论文用一个仿真演示说明在线求解能用在什么问题上:六架同构四旋翼守卫一块 20 × 20 km 的区域,巡航速度 20 m/s,风随时间和位置变化(背景风 12 m/s,在 15 分钟仿真内从东北转到西北;另有一个气旋,在 t = 500 s 前后 80 秒的阵风窗口里切向风速达到 30 m/s)。每个 10 Hz 外环节拍,都从每架无人机的当前位置重算“谁能最先到达每个格子”,也就是 10 分钟时域下的捕获盆 Voronoi 剖分;没有任何无人机能在时域内到达的格子单独标出。火点出现时查它所在格子的标签来派遣;格子不可达,或者负责它的无人机正在扑救别处,这处火就等待。
做法利用了同构智能体的最小值保持性质:各无人机到达时间场的最小值满足同一个 HJ 方程,所以只需一次联合求解,再在核函数里传播整数标签,前沿刚到达的格子继承已标记邻居中 V 最小者的标签。作者报告,带标签的联合求解成本约为单个智能体求解的 1.3 倍。K = 6、200 × 200 网格上,联合求解 15–17 ms,六次单独求解 69–77 ms(4.6 倍);与逐个求解再取 argmin 的结果相比,标签一致率 99.5%,不一致的是沿分界线一格宽的条带。闭环仿真中每个节拍 4.0 ms(9000 个节拍的平均),三处火点都在仿真时段内被扑灭。在 Thor 上,锁定时钟时每个节拍 9.69 ms,系统输入功率平均 34.4 W;默认动态时钟下为 10.35 ms、31.1 W。
这个演示用的是一阶模式(RK1 加迎风格式),不是前面 WENO5 + TVD-RK3 的高阶格式;风场被当作已知;它演示的是派遣,不是安全过滤。
和本站课程的关系
物理AI实验室 2.7:安全过滤器 用的是控制障碍函数(CBF):手写一个 h,过滤器是一道只有一条约束的小二次规划。HJ 可达性是另一条路:安全集不是手写的,而是从动力学和扰动集合算出来,代价就是本文要压下去的网格计算。论文在相关工作里还提到 BRT 的另外两种接法:作为 MPC 预测安全过滤器的终端安全集,或者作为 MPPI 的硬约束。2.7 强调,保证是相对模型说的。本站的读法是,这一点对 BRT 同样成立:方程里的 f(x, u, d) 和扰动集合写错了,算得再快,管也是错的。论文设想按当前摩擦系数、接触模型等重算 BRT,这要求先有这些量的当前估计;本站读到的正文没有讨论估计从哪里来。
物理AI实验室 2.6:上边缘 讲过,控制频率上限是单圈时延的倒数。表里的 112 Hz 只是求解器单次求解时间的倒数;放进真实回路,还要加上状态估计、把新的 V 交给过滤器和执行的时间。论文报告的是单次求解时间和仿真闭环的节拍,没有给出真机安全过滤回路的端到端时延。
局限 / 注意
- 这是 arXiv 预印本,全部数字为作者报告 [R],本站没有复现。论文称求解器是一个不依赖 Python 运行时的 C++/CUDA 库,但本站读到的文本(参考文献在第 13 条处截断)里没有它的代码地址。
- 论文没有做安全过滤器的闭环实验。作者在未来工作里写,对核心论点最直接的检验,是在扰动模型中途变化的任务里,把在线重算的 BRT 当作安全过滤器,与离线预计算和神经近似的基线在同一台机器人上比较。VLA、人形机器人、ADAS 都是作者列出的应用设想,不是实验结果。
- 维数上限没有改变。作者写明,计算量随状态维数指数增长这一点本文没有改变,只是改了常数:FP32 下 51⁴ ≈ 6.8 × 10⁶ 个格子的 4D 求解要 0.22 s,接近 30 Hz 预算的 7 倍;31⁴ 的网格能在 16 ms 内算完,但空间分辨率粗。4D 以上,作者认为仍应使用状态空间分解或学习的值函数近似。
- FP32 与 FP64 在 4D 上最多差 0.1% 的格子。作者建议把 BRT 边界附近的一条窄带当作分类不确定区,而不是硬边界。网格上的 BRT 本身也是数值近似。
- 桌面数字来自一台 RTX 4000 Ada(20 GB,130 W TDP),Thor 数字是锁定时钟、空闲主机上 7 次运行的中位数;Thor 上的 JAX 基线未经调优。
- 野火演示是仿真,用一阶模式,假设风场已知。作者也写明,目前每个节拍都要重新分配并上传静态流场。
- 论文致谢中写明,撰写过程中大量使用了生成式 AI(Claude),用于起草文字、编写和优化 CUDA/C++ 求解器以及基准与绘图代码;作者称已复核全部文字和代码,并重新运行了每一项测量。
- 所有结果都不是硬件安全验证。


