
プレプリント Online Hamilton–Jacobi Reachability Onboard the Robot Control Loop(arXiv 2611.04096、2026-11-03、著者は Kevin Weekly(Mirror AI)と Alexandre M. Bayen(UC Berkeley))は、新しい数値スキームを提案するものではありません。Hamilton–Jacobi(HJ)到達可能性解析の標準的なレベルセット・ソルバー(WENO5 + TVD-RK3 + Lax–Friedrichs)を CUDA カーネルとして書き直し、後退到達可能チューブ(backward reachable tube、BRT)をミッション前にオフラインで一度だけ計算するのではなく、ロボットの制御ループの周期に合わせて再計算できるようにしたものです。著者の報告では、RTX 4000 Ada ワークステーション GPU 1 枚で FP32 を使うと、古典的な 3D の Air3D の例は 1 回の求解が 8.91 ms、約 112 Hz です。Jetson AGX Thor では N = 41 のとき 66 Hz です。これらの数値はグリッド解像度、精度、状態次元と合わせて読む必要があります。論文が扱うのは 2D から 4D までで、安全性の保証も書き下したダイナミクスと外乱モデルに対してしか成り立ちません。以下の数値はすべて著者報告 [R] で、本サイトは再現していません。
後退到達可能チューブとは何か、なぜオンラインで計算するのか
論文は Mitchell、Bayen、Tomlin の定義に従います。システム ẋ = f(x, u, d) には制御 u と外乱 d があり、失敗集合は符号付き距離関数 ℓ で表します(ℓ(x) ≤ 0 が失敗)。時間 T の後退到達可能チューブとは、制御をどう選んでも、最悪の外乱が T 以内にシステムを失敗集合へ押し込める初期状態の集合です。これは値関数 V のゼロ劣位集合 {x : V(t, x) ≤ 0} に等しく、V は Hamilton–Jacobi–Isaacs(HJI)偏微分方程式を満たします。ハミルトニアンは max_u min_d pᵀf(x, u, d) で、最悪の場合の制御と外乱のゲームを表します。
著者は BRT の 3 つの性質を分けて説明しています。チューブの内側の状態からは、最悪の外乱に対して失敗を避けられません。外側の任意の状態からは、ホライズンの間安全を保つ制御が必ず存在します。チューブの境界上では、特定の制御を少なくとも 1 つ加えなければ、外乱によってチューブの内側へ押し込まれます。これに基づく安全フィルターは学習済みプランナーの下流に置かれ、提案された動作を認めるか、値関数から導いた制御で置き換えます。
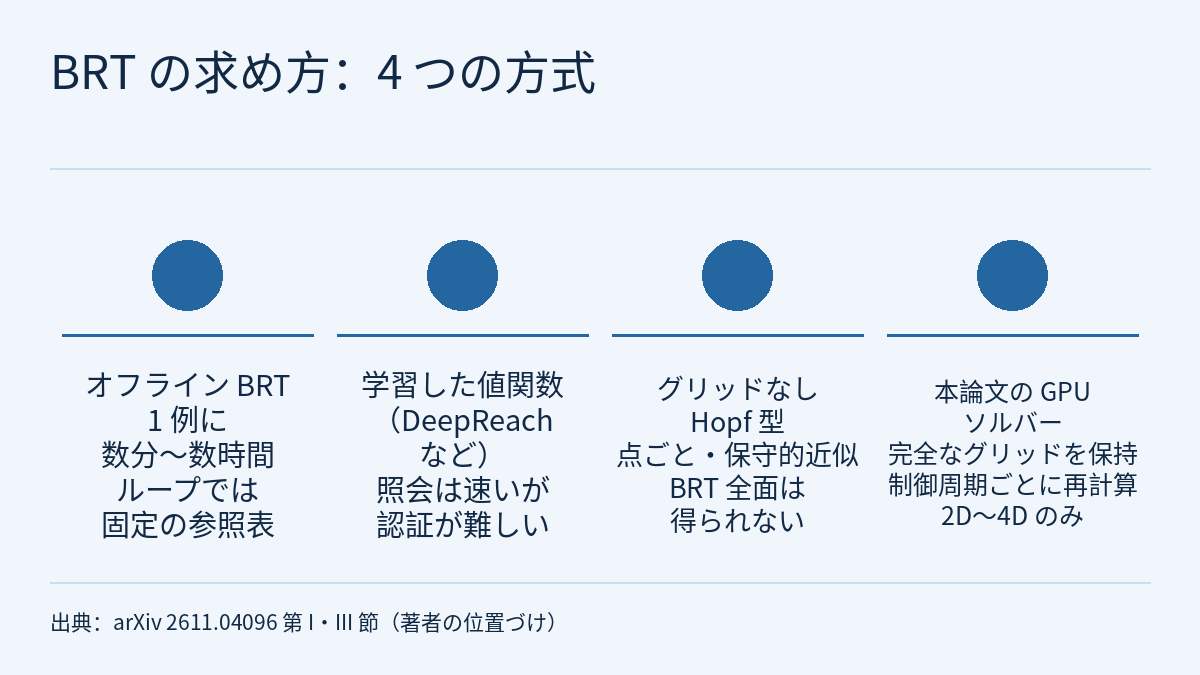
難しいのは、グリッド上のレベルセット計算が状態次元に対して指数的に増えることです。これまでは BRT をオフラインで一度計算し(論文によれば、従来の研究では 1 例あたり数分から数時間かかるのが普通です)、制御ループでは固定の参照表として使ってきました。著者の主張は、外乱モデル、障害物、ダイナミクスが事前に分からない場合、古い BRT は古い安全保証だということです。
関連研究の節で、論文は自らの位置を示しています。DeepReach などはニューラルネットワークで値関数を近似し、照会は速いものの認証が難しくなります。グリッドを使わない Hopf 型の手法は値を点ごとに求めるか保守的な近似を与え、BRT の曲面全体は得られません。本論文は完全なグリッドを保ったまま、曲面全体の求解を速くします。DualGuard MPPI は事前計算した BRT をサンプリング型 MPC のハード制約として使いますが、著者は自分たちの研究をその上流、つまり事前計算をオンラインの再計算に置き換える部分だと位置づけています。
ソルバー:スキームはそのまま、融合した CUDA カーネルへ
スキームは標準的なものです。各次元 6 点のステンシルを使う 5 次の WENO5 で勾配を再構成し、数値ハミルトニアンには Lax–Friedrichs 散逸(グローバル、ローカル、ローカル–ローカルの 3 種類に対応)を使い、時間積分は 3 次の TVD Runge–Kutta、時間刻みは Δt·α_max/Δx ≤ 0.75 を満たすようにします。各時間ステップの後に Mitchell の BRT クランプ V ← min(V_new, V_old) を適用し、後退積分の間 V が単調非増加になるようにします。著者は、高速化の源を離散化そのものが持つ構造に求めています。
- RK3 の各段を 1 つの融合カーネルに。WENO5 の再構成、ハミルトニアン、段の結合、そして最終段の BRT クランプをすべてレジスタ上で行い、段の右辺がグローバルメモリを経由しません。第 3 段は V をその場で書き換え、ステップごとのコピーをなくします。
- WENO5 の除算は 1 回だけ。重みの正規化を代数的に書き換え、1 回の再構成に必要な除算を教科書的な書き方の 13 回から 1 回に減らしています。結果は丸め誤差の範囲で一致します。著者は、民生用 GPU では FP64 の除算がソフトウェアで実行され、
--use_fast_mathも倍精度には効かないと指摘しています。 - CFL 刻みはホスト側で一度だけ計算。論文のすべてのハミルトニアンで波速の上界が時間に依存しないため、段ごとのグリッド全体のリダクションが要りません。
- ステンシルの値は L2 キャッシュから直接読む。制御周期で使うグリッドは L2 に収まります(101³ 個の FP32 値は約 4 MB、L2 は 40 MB)。著者の測定では、共有メモリでタイル化した 3D ステンシルのスループットは直接読み出しの約 3 分の 1 でした。
- 3D ソルバーは 1 ステップ全体を CUDA グラフに記録して再生。精度はテンプレート引数で float と double を切り替え、FP32 モードは組み込み機器への展開を想定しています。
比較用に、著者は同じスキームを PyTorch で実装し、torch.compile でコンパイルしたものも用意しました。著者の説明では、上の各項目は離散化に関する代数的な恒等式やデータフロー上の事実で、汎用のテンソルコンパイラーは IEEE の意味論のもとでこれらを仮定できません。著者は、torch.compile の方が書きやすく修正しやすく、自動微分も使えるとも書いています。
速度を論じる前に参照実装と合わせる
参照実装は Stanford ASL の JAX ライブラリ hj_reachability です。8 つの例(2D のホロノミック系、二重積分器、風の影響を受ける 3 種類のドリフター、3D の Air3D、2 種類の 4D 追跡・逃避)を共通の JSON 仕様で定義し、両者とも WENO5、TVD-RK3、CFL 0.75、FP64 を使います。クランプの演算子は両者で異なります。本ソルバーは RK3 の 1 ステップ全体ごとに 1 回クランプし、hj_reachability は各サブステージでハミルトニアンをクランプします。著者は、報告した一致度はこの違いを残したまま測ったものだと明記しています。
- 最大の共通グリッドでの点ごとの L∞ 差は、2D の例で 0.00217〜0.0130、Air3D で 0.0223、4D 追跡・逃避で 0.347(V の値域は約 2.6)です。著者は、差の主因は滑らかな領域の打ち切り誤差ではなく、BRT の滑らかでない境界がぼやけることだとしています。
- Air3D(t = 2 s、両機の速度 5 m/s、最大角速度 1 rad/s、半径 5 m の衝突円柱)では N = 51 のとき、両者の BRT のセル数の差は約 11,200 セル中 4 セル、つまり 0.04% です。
- 4D 追跡・逃避では既定の設定で、本ソルバーの BRT が参照より 7.1〜7.5% 小さくなります。著者はこの差を 2 つのスキーム上の選択に帰しています。勾配に局所的な Lax–Friedrichs 係数と、非周期境界での線形外挿です。両方をそろえると、N = 31、41、51 でのセル数の差は 0.6%、0.4%、0.3% です。
- FP64 の単発求解は、6 種類の異なるダイナミクスで JAX の 2.0〜4.6 倍、
torch.compileの 1.3〜1.4 倍の速さです。同じ L∞ 精度目標で比べると JAX-GPU の 3.1〜4.9 倍です。
リアルタイムの数値はグリッドと精度とあわせて読む
閉ループで使うのは FP32 です。著者の報告では、RTX 4000 Ada 上で FP32 は自身の FP64 の 21〜33 倍速く、FP32 の BRT は 2D と 3D の例では FP64 とセル単位で一致し、4D の例では最大 0.1% のセルが異なります。下の表は論文の表 IV から抜き出したもので、「周波数」は 1 回の求解時間の逆数です。
| 例 | 次元 | N | 本ソルバー(ms) | 周波数 | JAX(ms) | torch.compile(ms) |
|---|---|---|---|---|---|---|
| air3d | 3D | 51 | 8.91 | 112 Hz | 52.3 | 50.0 |
| air3d | 3D | 101 | 102 | 9.8 Hz | 804 | 178 |
| drifter_const | 2D | 200 | 6.82 | 147 Hz | 86.4 | 107 |
| drifter_wg | 2D | 200 | 13.6 | 74 Hz | 159 | 223 |
| pe_4d | 4D | 31 | 16.4 | 61 Hz | 150 | 27.6 |
| pe_4d | 4D | 51 | 222 | 4.5 Hz | 3885 | 573 |
同じ Air3D でも、N を 51 から 101 に上げると周波数は 112 Hz から 9.8 Hz に下がります。同じ 4D 追跡・逃避でも、N = 31 では 61 Hz、N = 51 では 4.5 Hz しかありません。論文の図 3 のスイープによると、FP32 で 30 Hz の予算に収まるのは Air3D の N = 71 まで(36 Hz)、4D 追跡・逃避の N = 31 まで、2D ドリフターの N = 200 までです。100 Hz の予算に収まるのは Air3D の N = 51 までと、一定風のドリフターの N = 200 までです。同じハードウェア、同じ FP32 で比べると、本ソルバーは hj_reachability の 5.9〜17.5 倍(表 IV)、スイープ全体では 5.7〜17 倍(図 3)、torch.compile の 1.7〜16 倍の速さです。
Jetson AGX Thor 開発キット(T5000 モジュール、2560 コアの Blackwell GPU、128 GB の LPDDR5X 統合メモリ、電力モード上限 120 W)向けには同じソースをビルドしています。著者の報告では、単発の求解はデスクトップより 2.7〜3.5 倍遅くなります。Air3D は N = 41 で 15.1 ms(66 Hz)、N = 51 で 28.9 ms(35 Hz)。ドリフターは N = 200 で、一定風が 18.6 ms(54 Hz)、空間的に変化する風が 37.1 ms(27 Hz)。4D 追跡・逃避は N = 31 で 53.9 ms(19 Hz)です。同じ機器上では hj_reachability の 3.8〜8.9 倍の速さですが、ここでの JAX は XLA の既定の、チューニングしていない融合設定を使っています。jaxlib 0.10.0 の自動チューナーが sm_110 で動かないためです。
マルチエージェントのデモ:1 回の求解で 6 機のドローンの領域分割
論文はシミュレーションのデモで、オンライン求解がどんな問題に使えるかを示しています。同一仕様のクアッドコプター 6 機が 20 × 20 km の領域を巡航速度 20 m/s で守り、風は時間と場所によって変わります(背景風 12 m/s が 15 分のシミュレーションの間に北東から北西へ回り、さらにサイクロン状の渦の接線風速が t = 500 s 前後の 80 秒間の突風の時間帯に 30 m/s に達します)。10 Hz の外側ループの各周期で、各ドローンの現在位置から「どのドローンが各セルに最初に着けるか」、つまり 10 分のホライズンでの捕獲盆 Voronoi 分割を再計算します。ホライズン内にどのドローンも到達できないセルは別に示します。火災が起きると、そのセルのラベルで出動するドローンを決めます。セルに到達できない場合や、担当のドローンが別の火災の消火中である場合、その火災は待ちになります。
この方法は、同一仕様のエージェントに対する最小値保存の性質を使います。各ドローンの到達時間場の最小値は同じ HJ 方程式を満たすので、統合した 1 回の求解で足ります。カーネル内で整数のラベルを伝播させ、前線が到達したばかりのセルは、ラベル付きの近傍のうち V が最小のもののラベルを受け継ぎます。著者の報告では、ラベル付きの統合求解のコストは 1 エージェントの求解の約 1.3 倍です。K = 6、200 × 200 グリッドでは、統合求解が 15〜17 ms、6 回の個別求解が 69〜77 ms(4.6 倍)で、エージェントごとに求解して argmin をとる参照とのラベル一致率は 99.5% です。不一致は境界線に沿った幅 1 セルの帯です。閉ループのシミュレーションでは 1 周期 4.0 ms(9,000 周期の平均)で、3 件の火災はすべてシミュレーション時間内に消し止められました。Thor ではクロックを固定して 1 周期 9.69 ms、システム入力電力は平均 34.4 W、既定の動的クロックでは 10.35 ms、31.1 W でした。
このデモは前述の高次の WENO5 + TVD-RK3 ではなく、1 次のモード(RK1 と風上差分)を使っています。風の場は既知として扱い、示しているのは出動の割り当てで、安全フィルターではありません。
本サイトの講座との関係
フィジカルAIラボ 2.7:安全フィルター では制御バリア関数(CBF)を使いました。h を手で書き、フィルターは制約が 1 本だけの小さな二次計画になります。HJ 到達可能性は別の道です。安全集合は手で書くのではなく、ダイナミクスと外乱の集合から計算し、その代価が本論文が削ろうとしているグリッド計算です。論文は関連研究で BRT の別の使い方も 2 つ挙げています。MPC による予測型安全フィルターの終端安全集合として使う方法と、MPPI のハード制約として使う方法です。2.7 では、保証はモデルに対するものだと強調しました。本サイトの読み方では、これは BRT にも同じく当てはまります。方程式の f(x, u, d) や外乱の集合が間違っていれば、どれだけ速く計算してもチューブは間違っています。論文は現在の摩擦係数や接触モデルなどのもとで BRT を再計算することを構想していますが、そのためにはまずそれらの量の現在の推定値が必要です。本サイトが読んだ本文には、その推定値をどこから得るかについての議論はありません。
フィジカルAIラボ 2.6:エッジへ では、制御周波数の上限は 1 周の遅延の逆数だと説明しました。表の 112 Hz はソルバー 1 回の求解時間の逆数にすぎません。実際のループでは、状態推定、新しい V をフィルターに渡す時間、実行の時間が加わります。論文が報告しているのは単発の求解時間とシミュレーションの閉ループの周期で、実機での安全フィルターのループのエンドツーエンド遅延は示していません。
制約と注意点
- arXiv のプレプリントで、数値はすべて著者報告 [R] です。本サイトはどれも再現していません。論文はソルバーを Python ランタイム不要の C++/CUDA ライブラリとしていますが、本サイトが読んだテキスト(参考文献は 13 番目で途切れています)にはコードの所在が書かれていません。
- 論文には安全フィルターの閉ループ実験がありません。著者は今後の課題として、中心的な主張を最も直接的に検証するには、ミッションの途中で外乱モデルが変わるタスクで、オンラインで再計算した BRT を安全フィルターとして使い、同じロボットでオフライン事前計算とニューラル近似のベースラインと比べる定量的な閉ループ研究が必要だと書いています。VLA、人型ロボット、ADAS は著者が挙げた応用の構想で、実験結果ではありません。
- 次元の上限は変わっていません。著者は、状態次元に対する指数的な増加は本研究でも変わらず、定数が変わっただけだと明記しています。FP32 で 51⁴ ≈ 6.8 × 10⁶ セルの 4D 求解は 0.22 s かかり、30 Hz の予算のほぼ 7 倍です。31⁴ のグリッドは 16 ms で解けますが、空間解像度は粗くなります。4D を超える場合、著者は状態空間の分解や学習した値関数の近似が引き続き適切な手段だとしています。
- 4D では FP32 と FP64 で最大 0.1% のセルが異なります。著者は、BRT の境界に沿った細い帯を硬い境界ではなく分類が不確かな領域として扱うよう勧めています。グリッド上の BRT 自体も数値近似です。
- デスクトップの数値は RTX 4000 Ada(20 GB、TDP 130 W)1 台のもので、Thor の数値はクロックを固定し、アイドル状態のホストで 7 回実行した中央値です。Thor 上の JAX ベースラインはチューニングされていません。
- 山火事のデモはシミュレーションで、1 次のモードを使い、風の場を既知としています。著者は、現状では周期ごとに静的な流れ場を再確保・再転送しているとも書いています。
- 論文の謝辞には、執筆にあたって生成 AI(Claude)を広く使ったと書かれています。文章の下書き、CUDA/C++ ソルバーの作成と最適化、ベンチマークと図の作成コードに使い、著者はすべての文章とコードを確認し、報告した測定をすべて再実行したとしています。
- いずれの結果もハードウェアの安全性検証ではありません。
リンク
- Online Hamilton–Jacobi Reachability Onboard the Robot Control Loop: A Real-Time GPU Solver for Safety-Critical Autonomy(arXiv 2611.04096)
- 論文の HTML 全文
- フィジカルAIラボ 2.7:安全フィルター――制御バリア関数による修正を一歩手で計算し、入れるループと残すべき安全の余裕を求める
- フィジカルAIラボ 2.6:エッジへ――遅延のログから制御周波数の上限を求め、量子化で減るのが容量か時間かを見分け、動作チャンクの長さを決める
- フィジカルAIラボ:すべての数字を確認できるフィジカルAI講座(講座の概要)


