動作チャンキングでは、VLA が将来の動作をひとまとまりで生成するため、大規模モデルを呼び出す回数を減らせます。しかし、そのうちどこまでを実行してから世界を見直すかは別の判断です。実行が短すぎればクエリが増え、長すぎれば環境の変化に気づけず、実行誤差も積み重なります。ソウル大学校、KAIST、Dnotitia の著者によるプレプリント(arXiv 2610.21434、2026-10-15)は、policy-aligned predictive verifier(PAV)を提案しています。実行する前に、VLA 自身のタスク条件付き表現空間で、各候補プレフィックスがロボットをどの状態へ導くかを予測し、そこからタスクを完了できるかを見積もって、実行長を選びます。著者報告によると、LIBERO で π0.5(チャンク長 H = 50)を使った場合、平均成功率は常に 5 ステップずつ実行する方式より 7.50 ポイント高く、クエリは 63.3% 少なくなりました。実機の 3 タスクでは平均成功率 74.4% で、最良の固定実行長は 41.1% でした。以下では、「成功/失敗」しかないエピソード結果から区間ごとの判断をどう学ぶのか、何と比べたのか、どの比較で利得が小さくなるのかを見ていきます。数値はすべて著者報告 [R] で、本サイトでは再現していません。
問題:1 つの動作チャンクをどこまで実行するか
方策 π が時刻 t に観測と指示から長さ H のチャンクを生成するとします。実行長 h を選ぶとは、最初の h 個の動作だけを実行し、h ステップ後に新しい観測を得て方策に再度問い合わせることです。論文はこれを、推論コストと時間的一貫性、そして応答性とのトレードオフとしてまとめています。固定の実行長はすべてのチャンクと状態に同じ h を使い、適応的な実行は毎回決め直します。
論文は既存の適応的手法を、使う信号によって 2 種類に分けています。
- 生成の安定性:方策内部の情報から判断します。AutoHorizon は動作の自己注意から実行の上限を推定します。A3 は動作の合意と再デコードの安定性から実行長を選びます。つまり、チャンク内のほかの動作を文脈として固定したうえである動作を生成し直し、同じものが出るかを確かめます。DVAC もこの分類に入り、題名からするとデノイジングの分散で再計画の時期を決めます。
- 予測の一致:実行中に、動作条件付きの予測と実際の観測を比べます。VLA-Corrector は予測と観測の視覚的なダイナミクスが持続的にずれたとき実行を打ち切って再計画し、CheckVLA は予測と観測の食い違いを失敗リスクと関連づけます。
論文の主張は、どちらの信号もそれだけでは、あるプレフィックスを実行した後にタスクを完了できるかを示さない、というものです。図 1 の例では、つかみ損ねてタスクに失敗する場面でも生成の安定性と予測の一致は高いままで、著者が提案する「提案の妥当性」(proposal validity)はより早く再計画を促し、この例は成功に終わります。これは著者が選んだ 1 つの例で、信号が機能しない場合があることは示しますが、それがどのくらいの頻度で起こるかは示しません。
手法:結果を予測し、タスクを続けられるかを検証する
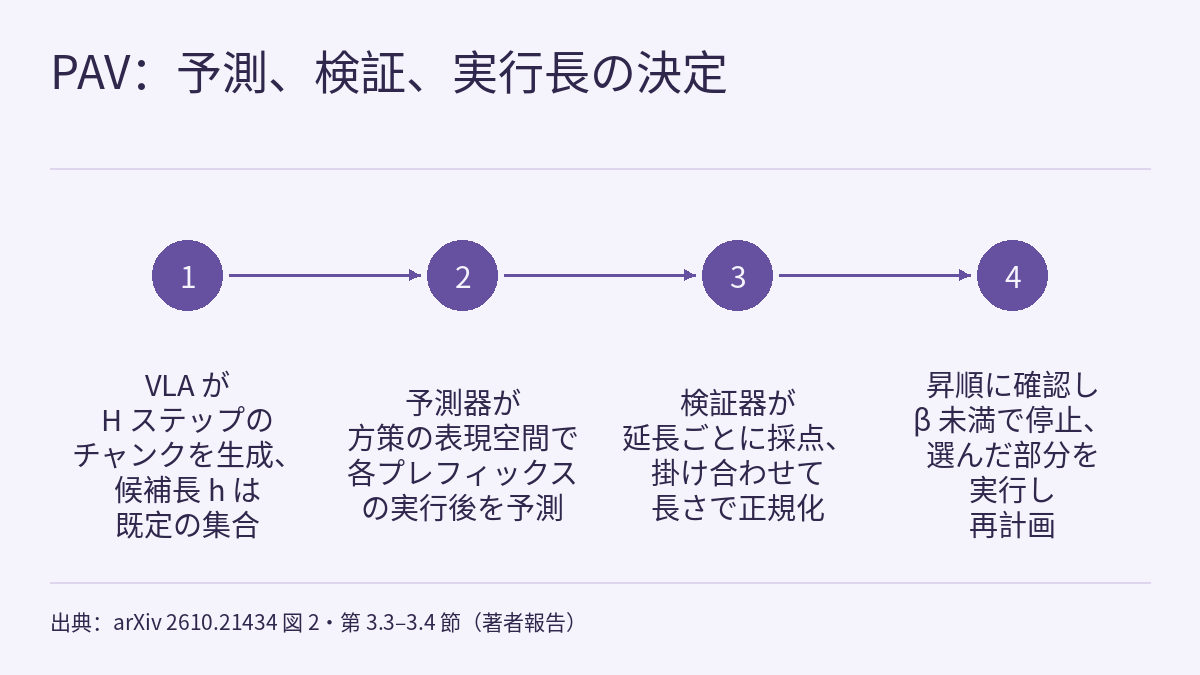
判断の対象。提案の妥当性 V_t(h) は、固定した提案の最初の h 個の動作を実行した後も、方策 π がタスクを成功させられる確率として定義されます。しかも、延長するたびに「まだ完了可能」であることを求めます。このように定めた集合はプレフィックスに関して閉じています。完了可能な軌道は、それより短いプレフィックスも完了可能です。したがって V_t(h) は、V_t(h−1) に「h 番目の延長後も完了可能である」条件付き確率を掛けた形に書けます。論文はこの条件付き確率をさらに 2 段階に分けます。実行後の将来の表現を予測し、次にその表現が成功裏の継続を支えるかを検証します。
予測器。表現 z_t は、方策自身のエンコーダーが観測と指示から取り出します。予測器 f_θ は z_t と最初の h 個の動作を受け取り、h ステップ後の予測表現を出力します。学習の目標は、実際に実行した後の観測の符号化です。損失は 2 項あります。真の将来表現とのコサイン距離と、動作入れ替えによる順位付けです。後者では、同じタスクの別の動作プレフィックスに対する予測が、実際に実行したプレフィックスの予測よりもマージン m だけ目標から離れていることを求めます。入れ替えた動作には失敗のラベルを付けません。
検証器。検証器 q_φ は予測された将来表現だけを読み、0 から 1 の局所的な妥当性 q を出力します。各区間の q を掛け合わせたものがプレフィックスのスコアで、V_t(h) を近似します。
エピソードの結果から区間ごとの判断を学ぶ。学習用エピソードには最終的な成功か失敗しかなく、区間ごとのラベルはありません。失敗したエピソードにも妥当なプレフィックスが含まれていることがあります。論文は区間ごとの妥当性を潜在変数として扱います。成功したエピソードではすべての因子を引き上げ、長いエピソードの重みが大きくなりすぎないよう区間数で平均します。失敗したエピソードでは積全体だけを引き下げ、各区間に失敗のラベルは付けません。それでもモデルは、失敗したエピソードのすべての区間を少しずつ下げて当てはめることができ、そうすると妥当な区間まで下がります。そこで論文は、失敗したエピソードで Σ(1 − q_i) を罰する局在化の事前分布を加えています。積が一定なら、この和を最小化すると低下は少数の区間に集中します。
本サイトが作った仮想の例で説明します。失敗したエピソードが 10 区間からなり、積を 0.5 まで下げる必要があるとします。案 1 は均等に分け、各区間 q = 0.5^(1/10) ≈ 0.933 で、Σ(1 − q) ≈ 0.67 です。案 2 は 1 区間だけ q = 0.5 に下げ、残りを q = 1 にするので、Σ(1 − q) = 0.5 です。軌道レベルの失敗損失は両者で同じですが、局在化の項は案 2 を選び、残る 9 区間は高いスコアを保ちます。これは仕組みを説明するための計算で、論文のデータではありません。
実行長の選び方。デプロイ時には、累積スコアをブロック数の平方根で長さ正規化します。掛け合わせる回数が少ないというだけでスコアが短いプレフィックスに偏らないようにするためです。そのうえで候補を短いものから順に確認し、しきい値 β を下回る最初のスコアで止め、その手前までで最も長いプレフィックスを実行し、新しい観測から方策に再度問い合わせます。正規化後のスコアは単調とは限らないので、この規則は手前の不合格点を越えて受け入れることを防ぎます。仮想の例です。β = 0.9 で、h = 5、10、15、20、25 のスコアが順に 0.97、0.94、0.91、0.88、0.92 なら、h = 15 が選ばれます。h = 25 は 0.9 を上回っていても受け入れられません。
実装(π0.5、LIBERO、H = 50 の構成)。方策の PaliGemma 言語モデルから、動作のデノイジング前の最終プレフィックス隠れ状態を取り出します。マスク付き平均プーリング、マスク付き最大プーリング、最後の非パディングトークンからそれぞれ 2,048 次元を得て、32 次元の状態と連結した 6,176 次元を 128 次元に射影します。VLA のパラメーターは変更しません。50 × 7 の動作列を 5 ステップずつ 10 ブロックに分け、GRU で再帰的に処理するので、1 回の展開で 10 通りの候補長をすべて評価できます。検証器は動作の埋め込みも GRU の隠れ状態も読まず、動作の情報は予測された結果を通じてのみスコアに届きます。モジュール全体は 2,011,208 パラメーターで、学習時だけに使う完了ヘッドを含みます。学習データは LIBERO の 4 スイート計 40 タスクについて各 150 エピソード、合計 6,000 エピソードで、問い合わせのたびに実行長を {5, 10, …, 50} から一様に抽出しています。初期状態で分割し、学習・検証・テストは 4,200 / 840 / 960 エピソードです。しきい値は β = 0.9、局在化の重みは 0.01、入れ替え順位付けのマージンは 0.1 です。著者は「われわれの知る限り」、プレフィックス条件付きの将来予測と提案の妥当性の推定を組み合わせ、適応的な動作チャンク実行に用いた最初の手法だとしています。
結果:何と比べ、何回のクエリを使ったか
動作チャンクの生成 1 回を 1 クエリと数え、表中のクエリ数はエピソードあたりの平均です。LIBERO では各シミュレーションタスクで 50 回試行しています。下表は論文の表 1(Spatial、Object、Goal、Long の 4 スイートの平均成功率)からの抜粋で、† は引用された公表済みの結果で、プロトコルが異なる可能性があります。
| 設定 | 手法 | 平均成功率(%) | クエリ/エピソード |
|---|---|---|---|
| π0、H = 50 | 固定 h = 5 | 92.10 | 34.6 |
| π0、H = 50 | 固定 h = 10 | 93.05 | 17.2 |
| π0、H = 50 | 固定 h = 50 | 76.05 | 4.4 |
| π0、H = 50 | AutoHorizon | 94.05 | 10.6 |
| π0、H = 50 | PAV | 94.30 | 12.3 |
| π0.5、H = 10 | 固定 h = 10 | 97.50 | 16.1 |
| π0.5、H = 10 | AutoHorizon | 97.8 | 27.8 |
| π0.5、H = 10 | A3 | 97.55 | 16.4 |
| π0.5、H = 10 | DVAC † | 98.00 | 18.6 |
| π0.5、H = 10 | VLA-Corrector † | 97.80 | 報告なし |
| π0.5、H = 10 | PAV | 98.10 | 16.8 |
| π0.5、H = 50 | 固定 h = 5 | 87.15 | 38.1 |
| π0.5、H = 50 | 固定 h = 10 | 87.45 | 19.2 |
| π0.5、H = 50 | 固定 h = 50 | 56.80 | 5.4 |
| π0.5、H = 50 | AutoHorizon | 94.45 | 12.7 |
| π0.5、H = 50 | PAV | 94.65 | 14.0 |
3 つの設定すべてで PAV の平均成功率が最も高くなっています。固定実行長との差が最も大きいのは π0.5、H = 50 の場合で、h = 5 より 7.50 ポイント高く(94.65% 対 87.15%)、クエリは 38.1 から 14.0 へと 63.3% 減りました。50 ステップを一度に全部実行すると 56.80% にとどまります。H = 10 では候補が 5 と 10 の 2 つしかなく、PAV は 97.50% から 98.10% に上がり、クエリは 16.8 対 16.1 です。
最も強い適応的ベースラインである AutoHorizon との差はずっと小さくなります。π0、H = 50 では 0.25 ポイント高いもののクエリは多く(12.3 対 10.6)、π0.5、H = 50 では 0.20 ポイント高く、クエリは 14.0 対 12.7 です。表には信頼区間がなく、本サイトはこれほど小さな差を優劣とは読みません。付録ではクエリ数が近い条件での比較もしています。β = 0.91 で PAV は 89.45%、19.7 クエリ、固定 h = 10 は 87.45%、19.2 クエリで、2.00 ポイント高くなりました。π0.5 の H = 50 は H = 50 で別にファインチューニングしたチェックポイントを使っており、著者はチェックポイントの違いのためにチャンク長の影響を切り分けられないと明記しています。
RoboTwin 2.0 では π0.5 を既定の H = 32 で使い、固定実行長 h ∈ {4, 8, 20, 32}、各タスク 50 評価エピソードです(表 2)。
| 手法 | 16 タスクの成功率(%) | 16 タスクのクエリ | 全 50 タスクの成功率(%) | 全 50 タスクのクエリ |
|---|---|---|---|---|
| 固定 h = 4 | 17.38 | 181.3 | 27.40 | 136.5 |
| 固定 h = 8 | 46.75 | 75.0 | 55.76 | 54.5 |
| 固定 h = 20 | 47.88 | 28.2 | 55.16 | 20.8 |
| 固定 h = 32 | 35.38 | 19.7 | 43.64 | 14.6 |
| DVAC † | 41.6 | 報告なし | 報告なし | 報告なし |
| PAV | 54.13 | 59.8 | 58.64 | 58.5 |
DVAC が使った 16 タスクのサブセットでは、PAV は 54.13% で、最良の固定実行長 h = 20 は 47.88%、DVAC の引用値は 41.6% です。全 50 タスクでは PAV が 58.64%、最良の固定実行長 h = 8 が 55.76% です。クエリ数もあわせて見る必要があります。16 タスクのサブセットでは PAV はエピソードあたり 59.8 クエリで、h = 20(28.2)の約 2.1 倍です(本サイトによる換算)。全 50 タスクでは h = 8 とほぼ同じです(58.5 対 54.5)。付録によると、RoboTwin の検証器は β = 0.91 でタスク埋め込みを含み、LIBERO の構成とは異なります。h = 32 のベースラインは別の評価から取ったもので、エピソードの初期条件がほかの手法と対応している保証はありません。DVAC は、公表済みの H = 50 方策と評価プロトコルによる外部の参考値です。RoboTwin の表には AutoHorizon や A3 はありません。
実機実験では、7 自由度の Franka Panda に前方、手首、右側の 3 台の RGB カメラを付けています。タスクごとに π0.5 をベースのチェックポイントから遠隔操作のデモでファインチューニングし(H = 50)、そのうえでロボットのロールアウトを集めて検証器を学習させます。3 つのタスクは、オレンジの立方体をトレイに置く(Place Cube in Tray)、それを緑の立方体に積む(Stack Cubes)、赤い非常停止ボタンを押す(Press Button)で、物体の位置は 50 cm × 50 cm の作業領域内でランダムに変え、各タスク 30 回試行しています(表 6)。
| 手法 | Place Cube in Tray(%) | Stack Cubes(%) | Press Button(%) | 平均成功率(%) | 平均再計画回数 | 平均実行長 |
|---|---|---|---|---|---|---|
| 固定 h = 5 | 16.7 | 10.0 | 23.3 | 16.7 | 69.58 | 5.00 |
| 固定 h = 10 | 66.7 | 16.7 | 40.0 | 41.1 | 36.54 | 10.00 |
| 固定 h = 30 | 23.3 | 43.3 | 53.3 | 40.0 | 11.97 | 30.00 |
| 固定 h = 50 | 26.7 | 33.3 | 50.0 | 36.7 | 6.91 | 50.00 |
| PAV | 80.0 | 66.7 | 76.7 | 74.4 | 12.87 | 30.22 |
PAV は 3 タスクすべてで最も高く、平均 74.4% です。最良の固定実行長 h = 10 は 41.1% で平均再計画回数は 36.54 回、PAV は 12.87 回です。再計画回数が近い h = 30(11.97 回)と比べると平均成功率は 40.0% から 74.4% に上がり、PAV の平均実行長は 30.22 ステップです。著者はここから、利得は一定の実行長を別の値に替えたことではなく、状況に応じて実行長を変えたことによると見ています。注意点として、実機の表には固定実行長のベースラインしかなく、適応的な手法は含まれていません。各タスク 30 回で、表に信頼区間はありません。また、読んだ本文には実機用の検証器の学習に使ったロールアウト数が書かれていません(詳細は付録 E にあり、本サイトが読んだテキストには含まれていません)。固定 h = 5 は平均 16.7% と h = 10 を大きく下回りますが、読んだテキストにはその理由の説明がありません。
アブレーション:どの要素が効いているか、しきい値はどれほど敏感か
以下の分析はすべて LIBERO、π0.5、H = 50 で、同じ方策のチェックポイントと同じロールアウトデータを使っています(表 3、表 12)。
| 変種 | 平均成功率(%) | クエリ/エピソード |
|---|---|---|
| Direct:将来を予測せず、現在の表現と動作から採点 | 84.55 | 22.3 |
| DINOv2 の特徴空間で予測 | 87.00 | 22.2 |
| 将来との整合の損失を除去 | 85.30 | 23.99 |
| 動作入れ替えの順位付けを除去 | 85.70 | 24.26 |
| 局在化の事前分布を除去 | 83.65 | 25.60 |
| 完全な PAV | 94.65 | 14.0 |
完全な手法はどの変種よりも 7.65 から 11.00 ポイント高く、クエリも少なくなっています。DINOv2 との比較は同じ予測・検証の流れを保ったまま表現空間だけを替えたもので、著者はこれを、提案の評価にタスク条件付きの情報を残すことが役立つ根拠と見ています。予測器は本当に動作を見ているのでしょうか。保留したエピソードで現在の入力と観測の目標を固定すると、予測と真の将来とのコサイン類似度は、実行した動作で 0.9401、同じタスクの別の動作列で 0.5304、逆順の動作で 0.4816、ゼロの動作で 0.4103 でした。予測長ごとに集計すると、実行した動作のほうが近い予測を与えたペアは 89.3%–95.2% です。
一方、しきい値はかなり敏感です。表 11 は学習済みの検証器を固定し、β だけを変えています。表の注記によると、スイープのクエリ数は選択の総数を 2,000 エピソードで割って数え、既定の行は本文の主結果の PAV の値を使っています(“the default row uses the PAV results from the main paper”)。したがって β = 0.90 の 94.65% は、ほかの 4 行と同じスイープの実行で得られたものではありません。
| β | 平均成功率(%) | クエリ/エピソード | 平均実行長 |
|---|---|---|---|
| 0.88 | 82.75 | 13.8 | 15.200 |
| 0.89 | 85.65 | 15.1 | 13.443 |
| 0.90(既定) | 94.65 | 14.0 | 12.783 |
| 0.91 | 89.45 | 19.7 | 9.685 |
| 0.92 | 88.30 | 25.1 | 7.614 |
既定の行と比べると、β を 0.01 動かした行の平均成功率は 5.20 から 9.00 ポイント低く、既定値が狭いピークの上にあるように見えます。ただし、この低下も「狭いピーク」も、スイープの各行と別の実行で得た既定の行との比較であり、1 回のスイープ内での比較ではありません。読んだテキストには、β = 0.90 をどう選んだのか、選ぶ際に評価エピソードとは独立したデータを使ったのかが書かれていません。新しいタスクや方策にこの手法を移すときは、このしきい値を別途確かめる価値があります。
オーバーヘッドについては、4 つの方策・チャンク構成で検証器の GPU 計算時間は 0.90–2.49 ms で、動作生成時間(180.34–216.95 ms)の 0.45%–1.24% です。著者は、これは GPU 計算時間であり、エンドツーエンドの制御ループのレイテンシではないと明記しています。
本サイトの既存記事との関係
フィジカルAIラボ 0.3:見る・考える・動くでは、π0 の論文で 50 Hz で動くロボットが 25 個の動作を実行するごと、つまり約 0.5 秒ごとに推論し直すことを紹介しました。これはまさに固定の実行長です。PAV はこの間隔を提案ごとに変えます。0.3 の原則はここでも当てはまり、間隔はそれを報告したシステムと構成にだけ属します。
フィジカルAIラボ 1.6:模倣学習では、動作チャンキングと、誤差が雪だるま式に膨らむ仕組みを扱いました。PAV の論文も、新しい観測を見ずにチャンク全体を実行すると実行誤差が積み重なると指摘しています。表 1 で 50 ステップを一度に全部実行したときの成功率が最も低い(76.05% と 56.80%)ことは、LIBERO でのその一例です。
本サイトで紹介した VeriVLA は、2 つの動作サンプルの変化で検証を起動し、潜在世界モデルが予測進捗によって 10 個の候補チャンクから 1 つを選びます。RESETTLE は 2 つのサンプルが食い違い続けたときだけ介入します。これらが答えるのは「どのチャンクを選ぶか」と「いつ介入するか」で、PAV が答えるのは「このチャンクをどこまで実行するか」です。PAV の論文が扱う生成の安定性の信号には A3 の動作の合意と再デコードの安定性が含まれ、この 2 本がサンプル間の差を使う考え方に近いものです。ただし PAV の論文はこの 2 手法を評価しておらず、3 つはベンチマークも設定も異なるため、数値は直接比較できません。
RoboTwin の表を読むときは、h = 32 のベースラインが対応づけられていないことや、DVAC のプロトコルが異なることを、フィジカルAIラボ 1.8:評価の問い、すなわち条件、試行回数、対応づけの有無に沿って一つずつ確かめられます。
制約と注意点
- arXiv のプレプリントで、数値はすべて著者報告 [R] です。本サイトでは再現していません。著者は実装を補足資料として提出するとしていますが、読んだテキストに公開コードのアドレスはありません。
- シミュレーションの結果は LIBERO と RoboTwin 2.0 によるものです。実機は 1 つのプラットフォーム(Franka Panda)、3 タスク、各 30 回で、ベースラインは固定実行長だけです。シミュレーションの結果もこの実機の結果も、ハードウェアの安全性の検証ではありません。
- AutoHorizon に対して、PAV は LIBERO の 2 つの H = 50 設定で 0.20–0.25 ポイント高いだけで、クエリは多くなっています。表に信頼区間はありません。
- † のベースラインは引用された公表済みの結果で、プロトコルが異なる可能性があります。RoboTwin の h = 32 のベースラインはほかの手法と対応づけられておらず、DVAC は H = 50 の方策を使っています。
- 検証器は方策の構成とベンチマークごとに別に学習します(シミュレーションでは、同じ構成・同じベンチマークのタスクで 1 つを共有)。ランダムな実行長で集めたロールアウトが必要で、LIBERO の構成では 6,000 エピソードを使いました。LIBERO と RoboTwin では構成(β、タスク埋め込み)が異なります。
- しきい値 β は既定値の付近で敏感で、読んだテキストにはその選び方が書かれていません。表 11 の既定の行は本文の主結果を流用しており、ほかの行と同じスイープの実行から得たものではないため、5.20–9.00 ポイントの低下は実行をまたいだ比較です。0.90–2.49 ms のオーバーヘッドは GPU 計算時間だけです。
- 読んだ HTML テキストは付録 C.4 の表 13 で途切れており、付録 E(実機のハードウェアと学習の詳細)は含まれていません。論文本文のいくつかの表番号は表の見出しと一致しません。たとえば RoboTwin の結果を表 3 として参照していますが実際は表 2、コサイン類似度を表 5 として参照していますが実際は表 4 です。本記事は表の見出しに従って引用しています。
リンク
- Policy-Aligned Predictive Verification for Adaptive VLA Action-Chunk Execution(arXiv 2610.21434)
- 論文 HTML 全文
- フィジカルAIラボ 0.3:見る・考える・動く――3 つの周波数をそれぞれのシステムに戻す
- フィジカルAIラボ 1.6:模倣学習――誤差がお手本のカバー範囲からはみ出すまでを手で計算し、ACT・拡散方策・データのスケーリング則の数字をそれぞれの条件に照らして読む
- フィジカルAIラボ 1.8:評価――「差し引き +2」を対応表に分解し、失敗ラベルと乱数シードを計算で確かめる
- フロンティア・レーダー|VeriVLA:2 つのサンプルで追加計算の要否を判断し、潜在世界モデルが予測進捗で 10 個の候補動作チャンクから 1 つを選ぶ
- フロンティア・レーダー|RESETTLE:凍結した方策の 2 つの動作サンプルが食い違い続けたときだけ介入し、デモを参照して補正動作を 1 回だけ実行する
- フィジカルAIラボ:すべての数字を確認できるフィジカルAI講座(講座の概要)