flow matching に基づく VLA はガウスノイズから動作チャンクをサンプリングします。同じ観測・同じ指示でも、ノイズのシードが変われば得られる動作チャンクの質は変わりえますが、デプロイ時の方策はふつう 1 つのサンプルだけを実行します。香港大学のチームによるプレプリント VeriVLA(arXiv 2610.21985、2026-10-15)は、このランダム性を選択に使える資源とみなします。まず 2 つの初期サンプルから学習不要の「2 軸」トリガースコアを計算し、追加計算に見合う重要な状態かどうかを判断します。トリガーが作動すると、さらに 8 個をサンプリングして計 10 個の候補とし、JEPA ベースの潜在世界モデルが各候補を実行した後の未来の潜在状態とタスク進捗の増分を予測して、予測進捗が最大の候補を実行します。著者報告では、実機 3 タスクの平均完了スコアが 50.8% から 65.5% に上がり、トリガーが作動した判断 1 回あたりの追加時間は RTX 4090 1 枚で 326 ms でした。シミュレーションでも RoboTwin 2.0 と LIBERO で向上していますが、RoboTwin 2.0 の主な表は常時オンの検証で、トリガーモードではありません。以下の数値はすべて著者報告 [R] で、本サイトでは再現していません。
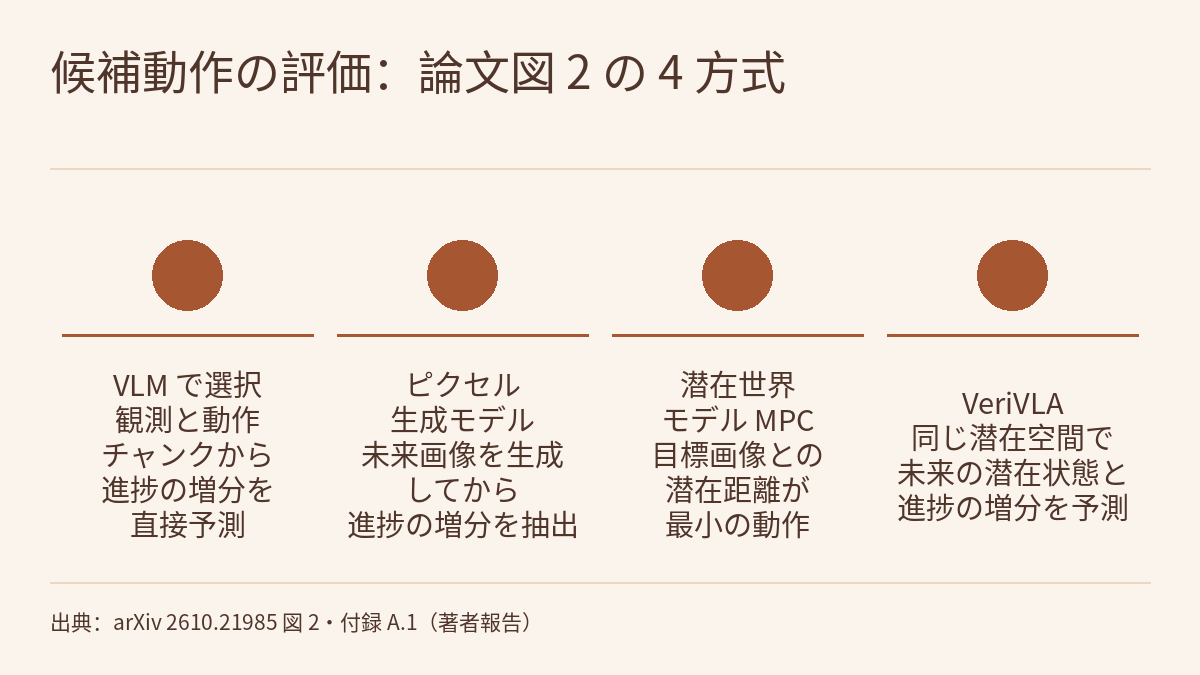
論文の図 2、付録の表 6、関連研究の節(§2、§3.4)は、同種の手法をいくつかに分けています。RoboMonkey は合成した動作の選好データで 7B の VLM をファインチューニングし、現在の観測と動作チャンクから直接スコアを出します。GPC-RANK と DreamAvoid は、まず未来のピクセル画像を生成してから報酬や進捗を取り出す 2 段階方式です。DINO-WM や V-JEPA 2-AC のような潜在世界モデルは探索で計画を立て、目標画像を必要とします。VeriVLA は世界モデルを残しつつ、同じ潜在空間で未来の潜在状態と進捗の増分を 1 段階で出力し、ピクセルの再構成も目標画像も使いません。著者の理由は次のとおりです。動作チャンクがタスクをどれだけ進めるかはスカラーの判断で、カメラ画像の大半のピクセルはそれに関係しません。ピクセル単位の世界モデルは生成が遅いうえ、簡単な進捗推定の前により難しい画像生成を解く必要があり、検証の質が生成の質に左右されてしまいます。
追加計算に見合うのはいつか:2 つのサンプルと 2 つの軸
著者は、方策の分散がタスクの進行に沿って一様ではないことを観察しています。LIBERO で繰り返しサンプリングすると、エンドエフェクタが接触の多い領域に近づくにつれて動作の分散が大きくなり、失敗もこうした高分散の区間で起こりやすいといいます(論文の図 1)。そこでトリガーには 2 つの条件を課します。操作がより複雑になる接触の多い領域で作動すること(C1)と、繰り返しサンプリングで多様な候補が得られ、検証器に選ぶ余地がある状態で作動すること(C2)です。
各判断ステップでは、まず方策から k = 2 個の動作チャンクを得ます。動きの速い段階に偏らないよう、各チャンクはそれ自身の平均動作の大きさで正規化します。そのうえで 2 つの軸から計算します。
- 時間軸(C1 に対応):各動作チャンク内で隣り合う動作の差の二乗平均を求め、k 個のサンプルで平均したもので、T_temp と表します。
- サンプル軸(C2 に対応):各ステップで各サンプルが k 個のサンプル平均からずれる量の二乗平均で、T_cross と表します。著者は、AdaFlow の分散適応型の計算に着想を得たとしています。
新しい環境にデプロイする前に、基盤方策を少数のエピソードで実行し、各時刻の T_temp と T_cross を計算して 2 つの経験的な参照分布を作ります。実行時には 2 つの値をそれぞれの分布内のパーセンタイルに変換し、大きい方 τ = max(τ_temp, τ_cross) がしきい値 τ0 を超えたら作動します。つまり、どちらか一方の軸が超えれば作動します。τ0 はトリガー唯一のハイパーパラメータです。作動しないときは追加のサンプリングを行わず、最初のサンプルをそのまま実行します。
著者はシミュレーションで 2 つの診断指標を使ってトリガーを評価しています。Status AUC は、トリガースコアと「重要な瞬間」ラベルの一致度です。ラベルはシミュレータの特権状態だけから作り、グリッパーと物体、または物体どうしの接触状態が切り替わる時刻にガウスカーネルを置いて足し合わせ、1 で頭打ちにしたうえで 0.5 を境に二値化します。トリガーが使う画像や動作は使いません。Variance Correlation は、トリガースコアと、各状態で K 個のサンプルから推定した参照分散との Spearman の ρ です。付録によると、DINO ベースラインは他の手法と一緒に LIBERO-Plus の摂動セットで評価されています。
| トリガー | Status AUC | Variance Correlation | サンプル数 k /追加レイテンシ(ms) |
|---|---|---|---|
| ランダム | 0.487 | – | – |
| DINOv2 特徴 + MLP(学習が必要) | 0.702 | 0.630 | 0 / 0 |
| 動作チャンクのエントロピー ACE | 0.588 | 0.716 | 2 / 14 |
| T_temp のみ | 0.704 | 0.789 | 1 / 0 |
| T_cross のみ | 0.694 | 0.877 | 2 / 14 |
| 2 軸トリガー | 0.727 | 0.887 | 2 / 14 |
時間成分は Status AUC が高く、サンプル成分は分散との相関が高いことから、著者は両者が補い合う信号だとみています。組み合わせると、どちらの指標もそれぞれの成分を少し上回ります。これらの指標が測るのはトリガースコアと接触の瞬間や方策の分散との一致度で、閉ループの成功率ではありません。成功率と計算量の閉ループでのトレードオフは、論文の図 6 で別に評価されています。実機では、接触の多い段階で検証がオンになる水準にしきい値を設定したとされていますが、具体的なしきい値とタスクごとの作動率は図 5b にしかなく、本サイトが読んだ本文には数値がありません。
どう採点するか:1 つの動作チャンクがどれだけ進めるかを潜在空間で予測する
論文は、動作チャンクの質を、それを実行する前後のタスク進捗の差、つまり delta progress(進捗の増分)Δp = p_{t+H} − p_t と定義しています。著者は、絶対的な進捗と比べて増分はそのチャンクの効果に直接対応すると述べています。
検証器は JEPA 世界モデルの枠組みで作られています。視覚エンコーダーは凍結した事前学習済みの V-JEPA 2 で、現在の観測を潜在表現に圧縮します。動作条件付きの自己回帰予測器は DROID データセットの 23k 本の軌道で事前学習されており、ロボットの動作に応じて潜在状態がどう変化するかを予測します。特定のロボットに合わせるため、著者はロボットの身体ごとに状態エンコーダーと動作エンコーダーを加え、長さ H の動作チャンクを M 個のサブチャンクに等分して段階的に展開します(実機実験のハイパーパラメータ表では M = 5)。
その上に進捗予測の分岐を加えます。同じ状態変化でも「クローゼットを閉める」なら正の進捗、「クローゼットを開ける」なら負の進捗になるため、進捗予測にはタスクの情報が必要です。そこでタスクごとに学習可能なクエリトークンを設け、予測器は各サブチャンクについてまず次の潜在状態を、続いてそれに対応する進捗の増分を予測します。アテンションマスクにより、潜在状態の予測からはこのタスクトークンが見えません。タスクの意味がダイナミクスのモデルに漏れ込むのを防ぎ、潜在ダイナミクスをタスクに依存しないものに保つためです。
学習では進捗推定を主な目的とします。各サブチャンクで、Huber 回帰損失が進捗の目標値に合わせ、同じタスク内のサンプル対に対するペアワイズのランキング損失が順序を保ちます(ランキング損失は DreamAvoid に従っています)。さらに V-JEPA 2-AC の定義に従う潜在状態の L1 予測損失を加え、teacher forcing と self-forcing を併用します。絶対的な進捗は Robometer で自動ラベル付けし、そこから増分を計算します。データについては、実機の各タスクで 50 本のデモを使って基盤方策 π0.5 をファインチューニングし、別に 50 本の方策実行を集めて Robometer でラベル付けします。同じ環境のタスクはすべて 1 つの検証器を共有し、H800 1 枚で学習します。シミュレーション実験も同じ手順です。
推論時、予測器は自分が予測した潜在フレームだけを条件として、各候補の M 個のサブチャンクを自己回帰的に展開し、M 個の進捗増分を出します。それらを合計し、累積予測進捗が最大の候補を実行します。実機で使えるよう、著者は 3 つのレイテンシ最適化を重ねています。自己回帰展開のあいだ KV キャッシュを再利用すること、候補チャンクの並列生成や、VLA が動作を生成するのと並行した潜在特徴の符号化など、互いに独立した計算を重ねて実行すること、事前コンパイルを含む PyTorch レベルの最適化です。図 5a では KV キャッシュによる削減が最も大きいとされていますが、本文には段階ごとの数値はありません。
結果:実機 3 タスクと 2 つのシミュレーションベンチマーク
実機実験では AgileX PiperX 双腕ロボットを使い、前方に RealSense D455 を 1 台、手首に RealSense D435 を 2 台取り付けています。3 つのタスクは、ペン挿し(ペンを取ってヨーグルトの瓶に挿す)、ピペット操作(ピペットで右の瓶から左の瓶へ液体を移す)、リンゴ置き(リンゴを取って容器に入れる)で、1 つが片腕、2 つが双腕です。各手法を各タスク 50 回試行し、トリガーには k = 2、検証には K = 10 を使います。完了スコアは段階ごとの配点で、ペン挿しとリンゴ置きはそれぞれ 0.5 点の 2 段階、リンゴを入れるのに何度も試みが必要だった場合はその段階が 0.25 点になります。ピペット操作は 0.25 点ずつの 4 段階です。
| 手法 | Rank 損失 ↓ | Huber 損失 ↓ | ペン挿し(%) | ピペット操作(%) | リンゴ置き(%) | 平均(%) |
|---|---|---|---|---|---|---|
| π0.5(1 回のサンプリング) | – | – | 45.0 | 52.5 | 55.0 | 50.8 |
| + RoboMonkey(VLM 検証器) | 1.19 | 0.37 | 49.0 | 55.5 | 63.5 | 56.0 |
| + GPC-RANK(ピクセル単位の世界モデル検証器) | 1.18 | 0.30 | 46.0 | 54.5 | 58.0 | 52.8 |
| + VeriVLA | 1.09 | 0.25 | 60.0 | 63.5 | 73.0 | 65.5 |
2 つの損失は検証データでのオフライン指標で、Rank 損失はタスク内でサンプルを順位付けする能力、Huber 損失は進捗増分の回帰精度を表します。完了スコアは閉ループの結果です。RoboMonkey ベースラインは学習目標を進捗増分の推定に変えています。著者は差を次のように説明しています。RoboMonkey は粗い位置合わせだけで済むタスク(リンゴ置きなど)では健闘するものの、細かな操作では苦戦し、その理由は VLM が世界のダイナミクスを明示的に理解していないこと「と考えられる」としています。GPC-RANK は実際の観測から進捗を推定する場合は良好ですが、テスト時に生成した展開画像では性能が落ち、生成の質がボトルネックになっていることを示すといいます。本サイトが読んだ本文には、ベースラインが同じトリガーと同じ候補数を使ったかどうかの記載はなく、信頼区間もありません。
アブレーション(表 4)は同じ実機 3 タスクで行われ、どの変種でも視覚エンコーダーは事前学習済みです。潜在状態の予測目標を外して進捗増分だけを予測させると、平均完了スコアは 65.5% から 55.2%(ペン 52.0、ピペット 55.5、リンゴ 58.0)に下がり、RoboMonkey ベースラインの 56.0% をわずかに下回ります。予測器を DROID で事前学習せずランダムに初期化すると、平均は 59.5%(54.0、61.0、63.5)に下がります。著者は、汎化の要求が高いリンゴ置きで最も下がり、瓶の位置がほぼ固定のピペット操作では下がり方が小さいと指摘しています。
シミュレーションでも各手法を各タスク 50 回試行しています。RoboTwin 2.0 では Hy-Embodied-0.5-VLA を基盤方策とし、ベースラインの成功率が比較的低い細かな操作タスク 5 つを選んでいます。表 2 の 2 組の結果はどちらも常時オンの検証で、Clean2Random 設定では方策も検証器もクリーンなデータだけで学習し、ランダム化した環境で評価します。LIBERO では π0.5 と StarVLA-GR00T の 2 つの基盤方策で 40 タスクを扱い、基盤方策ごとに検証器の重みを持ち、40 タスクで共有しています。本サイトが読んだ本文には、LIBERO の結果がトリガーと常時オンのどちらによるものかの記載がありません。
| ベンチマーク(基盤方策) | ベースライン(%) | + RoboMonkey(%) | + GPC-RANK(%) | + VeriVLA(%) |
|---|---|---|---|---|
| RoboTwin 2.0 Clean、5 タスク平均(Hy-VLA) | 66.4 | 65.2 | 68.8 | 73.6 |
| RoboTwin 2.0 Clean2Random、5 タスク平均(Hy-VLA) | 62.8 | 64.8 | 64.8 | 69.6 |
| LIBERO、4 スイート平均(π0.5) | 96.9 | 97.3 | 95.3 | 97.6 |
| LIBERO-10(π0.5) | 92.4 | 94.0 | 89.0 | 94.0 |
| LIBERO、4 スイート平均(StarVLA-GR00T) | 96.2 | 96.3 | 96.7 | 97.2 |
| LIBERO-10(StarVLA-GR00T) | 91.0 | 91.6 | 92.4 | 93.6 |
RoboTwin 2.0 は各タスク 50 回なので、1 回の試行は 2 ポイントにあたります。5 タスクで計 250 回のうち、Clean の 7.2 ポイントは成功が約 18 回、Clean2Random の 6.8 ポイントは約 17 回増えたことに相当します(本サイトによる換算)。タスクごとに見ると VeriVLA がどこでも首位というわけではなく、Clean2Random の Seal では 78% で GPC-RANK の 80% を下回ります。また Clean では RoboMonkey の平均が基盤方策を下回っています。LIBERO での向上は、まだ飽和していない LIBERO-10 に集中しており、π0.5 では VeriVLA と RoboMonkey がともに 94.0% です。シミュレーションでのトリガーモードの効果は図 6 にあります。Clean 設定で全タスク共通のしきい値を調整し、判断ステップのおよそ r の割合で検証が作動するようにしています。著者は、常時オンの検証が 5 タスクすべてで成功率を上げ、トリガーは最初の 4 タスクで向上分の大部分を保ちながら計算量を減らせたと述べていますが、図の数値は本サイトが読んだ本文には出てきません。
レイテンシとメモリ:326 ms に含まれるもの
付録の表 9 は実機デプロイの内訳を示しています。方策と検証器は同じ RTX 4090 で動いています。
| 構成要素 | レイテンシ(ms) |
|---|---|
| VLA 方策 | 82 |
| 2 軸トリガー(k = 2) | 14 |
| 追加サンプリング(K − k = 8 個の候補) | 80 |
| 検証器のフォワード(K = 10 個の候補すべて) | 246 |
| 作動しない判断の合計 | 96 |
| 作動した判断の合計 | 422 |
| 検証だけによる追加レイテンシ | 326 |
326 ms は追加サンプリングと検証器のフォワードの合計(80 + 246)で、14 ms のトリガーは含みません。作動しない判断は 82 + 14 = 96 ms、作動した判断は 422 ms です(本サイトによる計算)。メモリは VLA 方策が 9.8 GB、10 候補での検証器のフォワードが 8.7 GB で、合計 18.5 GB です。動作チャンクあたりの平均追加レイテンシは作動率によって決まり、図 5b にしか示されていません。本サイトが読んだ本文には、作動した判断の計算中にロボットが待つのかどうか、その計算が動作チャンクの実行とどう重なるのかの説明はありません。
本サイトの既存ページとの関係
フィジカルAIラボ 1.6:模倣学習では、拡散方策の強みは、左回りと右回りを平均して衝突させるのではなく、「同じ場面に正しいやり方が複数ある」多峰性の動作分布を学べることだと説明しました。VeriVLA が注目するのは、このランダム性のデプロイ時のもう一つの面です。毎回 1 つのサンプルしか実行しないので、引いたサンプルが悪いこともありえます。そこで重要な場面では複数を引き、その中から 1 つを選びます。1.6 で扱った誤差の蓄積も、この論文の出発点の一つです。悪い動作チャンク 1 つが失敗に直結したり、軌道を分布の外へ押し出したりしうるからです。
最近のレーダー記事 2 本は、それぞれ一部が重なります。フロンティア・レーダー|RESETTLEも凍結した方策の 2 つのサンプルから介入の要否を判断しますが、2 つのサンプルが食い違い続けたときだけ介入します。作動後は同じタスクのデモを検索して補正動作を 1 回だけ実行します。VeriVLA はチャンク内の時間変化とサンプル間の分散という 2 つの軸を使い、どちらかが超えれば作動し、その後 10 個の候補から 1 つを選びます。フロンティア・レーダー|LiteNWMも潜在空間で候補を採点し、候補ごとに RGB 画像を生成しませんが、対象はナビゲーションの軌道で、VeriVLA が予測するのは操作タスクの進捗増分です。3 本の論文はベンチマークも基盤方策もハードウェアも異なり、直接比較されていないため、数値で順位を付けることはできません。
VeriVLA の数値を読むときは、フィジカルAIラボ 1.8:評価の問いが当てはまります。実機の平均は 3 タスクの完了スコアの平均で、部分点を含みます。各タスク 50 回ですが、本文には試行ごとに良くなった・悪くなった数も信頼区間もありません。シミュレーションの主な表は常時オンの検証で、「適応的」にしたことによる計算の節約は図でしか示されていません。
制約と注意点
- arXiv のプレプリントで、数値はすべて著者報告 [R] です。著者は全員香港大学の所属です。本サイトはいずれの結果も再現していません。
- 参考文献 [11](DreamAvoid)の著者表記は X. Fan、Y. Lu、… H. Zhao で、本論文の著者 3 人とイニシャルが一致しますが、同一人物かどうかは論文に書かれていません。本論文のランキング損失におけるサンプル対の作り方は DreamAvoid に従っており、トリガー比較の DINOv2 + MLP ベースラインは DreamAvoid のような視覚ベースのトリガーを代表するものです(付録 C.3)。DreamAvoid そのものは表 1–3 の閉ループ比較には含まれていません。
- 進捗ラベルは Robometer が自動生成したもので、検証器が学ぶのはこの報酬モデルが付けた進捗です。本サイトが読んだ本文には、これらのラベルと人の判断との一致度の報告はありません。
- RoboTwin 2.0 の主な結果は常時オンの検証です。トリガーモードでの成功率と計算量のトレードオフ(図 6)と実機の作動率(図 5b)は図でしか示されていません。トリガーの診断(表 5)はシミュレータの特権的な接触状態に依存しており、このようなラベルは実機では直接得られません。
- 実機は 3 タスク・各 50 回だけで、完了スコアは部分点を含み、信頼区間はありません。326 ms は RTX 4090 1 枚、π0.5、K = 10 の構成でのみ計測されています。
- 著者が挙げる制約:検証器は方策が出した候補の中から選ぶことしかできず、ランダムシードを変えて得られる多様性はまだ限られています。視覚エンコーダーは凍結されているため、その表現は進捗推定向けに最適化されておらず、物体の配置、接触状態、タスク完了の細かな変化を見落とすおそれがあります。
- 検証器が選ぶ基準は予測進捗で、衝突や力の制約ではありません。シミュレーションの結果も実機の試行も、ハードウェアの安全性検証ではありません。
リンク
- VeriVLA: Adaptive Test-Time Verification for Flow-Based VLAs with Latent World Models(arXiv 2610.21985)
- 論文の HTML 全文
- フィジカルAIラボ 1.6:模倣学習――誤差がお手本のカバー範囲からはみ出すまでを手で計算し、ACT・拡散方策・データのスケーリング則の数字をそれぞれの条件に照らして読む
- フィジカルAIラボ 1.8:評価――「差し引き +2」を対応表に分解し、失敗ラベルと乱数シードを計算で確かめる
- フロンティア・レーダー|RESETTLE:凍結した方策の 2 つの動作サンプルが食い違い続けたときだけ介入し、デモを参照して補正動作を 1 回だけ実行する
- フロンティア・レーダー|LiteNWM:1 回の符号化で 16 本の候補と現行軌道の結果を潜在空間で同時予測し、候補ごとの RGB 生成をやめる
- フィジカルAIラボ:すべての数字を確認できるフィジカルAI講座(講座の概要)