
Witsense AI 的 Suvarna Kadam 与 University of Huddersfield 的 Soran Parsa 在 arXiv 2611.18372(2026-11-13)发布了一篇 VLA 综述,覆盖 2022 年 12 月到 2026 年 10 月的 88 项工作。它沿一个 VLA 从模型设计、训练到部署的生命周期定出七条设计轴,把 22 个主要模型逐一放上去,并从各论文正文里摘出训练数据、参数量、推理速度和硬件。读新论文时,这套轴可以当一张核对表:这项工作改的是哪一轴,它报告的数字能不能和别人的并排比较。下文是综述作者的归纳与摘录 [R];其中各模型的数字仍是原论文作者报告,本站没有复现。
88 项工作的构成是:5 项基础工作、38 个操作 VLA、12 个导航 VLA、5 篇综述,以及 28 项人形控制、世界-动作模型与评测工作。作者说明这是结构化综述,不是系统综述:从常用的 VLA 出发,沿引用和被引追踪,再检索 arXiv。
七条设计轴
四条轴描述模型本身,两条描述训练,一条描述部署:
- 输入与记忆:模型看到什么(相机、语言、机器人状态、额外条件),保留多少过去。
- 架构:指整条流水线的结构,不是骨干网络。分三种:单一网络;慢的 VLM 加快的动作模块、两者联合训练的双系统;由分开训练的模型组成的分层系统。
- 动作输出:怎样把视觉-语言特征变成电机指令,从离散词元到扩散、流匹配和回归,通常一次输出一段未来动作。
- 中间预测:动作之外还预测什么,可以是文本推理(思维链、子任务),也可以是世界模型给出的未来观测。
- 预训练数据:机器人示范、跨本体汇集的数据、网络数据、人类视频、仿真与生成轨迹,以及它们怎样配比。
- 后训练:怎样适配目标机器人或任务,从微调配方到部署中的强化学习。
- 实时执行:只有几赫兹的模型怎样平稳控制机器人,手段包括动作分块、异步推理,以及远程服务器与机器人之间的分工。
分类上有一处要留意:作者把 π0 算作单一网络,尽管它的动作专家有独立的权重,理由是专家属于同一个 transformer,每一层都关注 VLM 的词元;双系统则是在两个网络之间只传一个潜变量。OpenVLA、π0 和 GR00T N1 三个模型的动作头与参数构成,站内课程 物理AI实验室 3.1 已经逐一拆过,本文不重复,只看综述怎样把更多模型放在同一张表里。
表 3:22 个模型的选择集中在哪
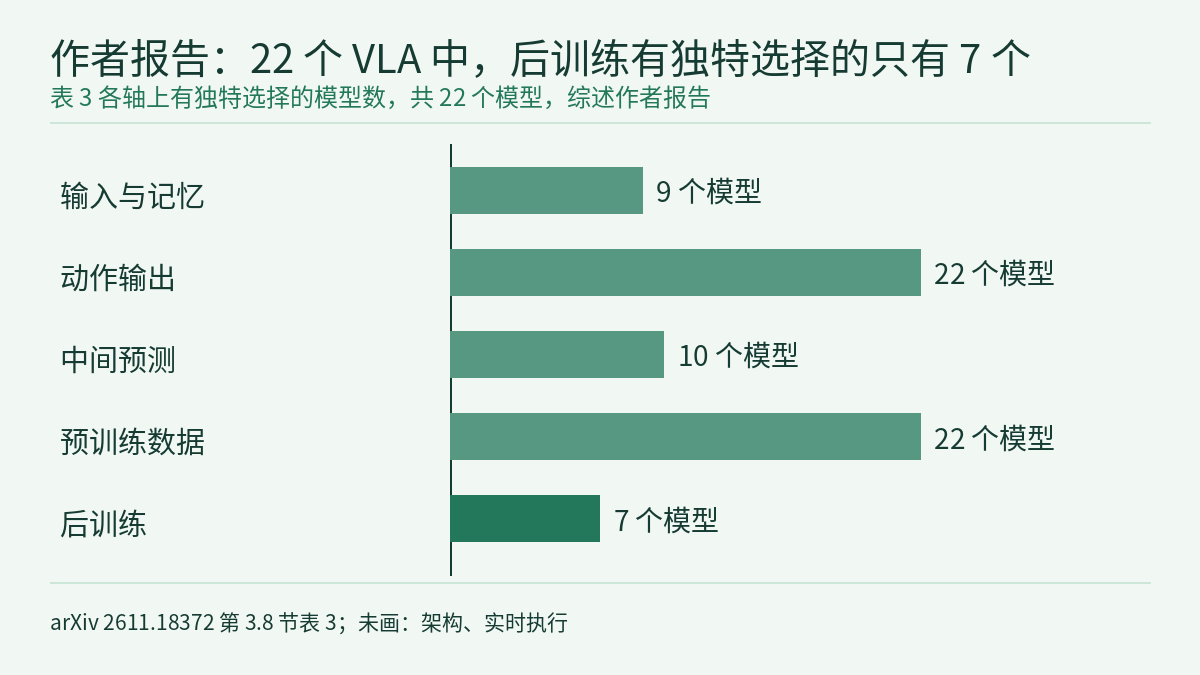
第 3.8 节的表 3 把 22 个模型(15 个操作、7 个导航)放到七条轴上。表中短横表示该工作在这一轴上没有独特选择,不表示模型没有这一部分。作者按列读出的结果是:动作输出和预训练数据两列,每个模型都有条目;9 个模型扩展了输入;10 个在动作之外还预测别的东西,其中预测未来观测的只有 2 个,即 VLA-JEPA 和 π0.7;在后训练上有独特选择的只有 7 个。7 个导航模型中有 5 个在输入上加了历史或额外视角,作者的解释是导航取决于机器人去过哪里。按行读,π0.7 在七条轴上都有独特选择,RT-2 和 OpenVLA 各有四条。本文配图画出其中五条轴的计数;架构和实时执行两轴,作者没有给出计数,图中未画。
按表 3 的条目,后训练一栏有内容的 7 个是:OpenVLA(LoRA 微调、量化)、π0(任务微调)、OpenVLA-OFT(并行解码、分块、L1 损失)、π0.6*(RECAP 离线 RL)、π0.7(元数据条件)、StreamVLN(DAgger)和 VLingNav(在线 RL)。这份名单是本站据表 3 列出的。其中 OpenVLA-OFT 的配方把 OpenVLA 在 LIBERO 上的平均成功率从 76.5% 提高到 97.1%,吞吐提高到 26 倍。RECAP 的“吞吐翻倍”放回原实验条件后怎样读,见 物理AI实验室 3.3。
训练数据:来源变宽,单位对不上
综述列出的预训练规模,从 RT-1 的约 13 万段、OpenVLA 的 97 万段 Open X-Embodiment 数据,到 π0 的约 1 万小时、LingBot-VLA 的约 2 万小时;π0.6* 只写了“数万小时”。来源也在变宽:GR00T N1 用了 78 万条仿真轨迹和约 30 万条视频生成轨迹,Qwen-VLA 用了 720 万条仿真轨迹,GR00T N1.7 在预训练中加入 2 万小时 EgoScale 第一人称人类视频。GR00T N1.5 到 N1.7 只有 NVIDIA 代码仓库的发布说明,没有论文,综述写明这几版的数据和评测无法按其他论文的标准核对。
问题在于单位。图 6 只能放下报告了单一段数的 16 项工作,π0 和 LingBot-VLA 只报告小时数,放不上同一条轴。作者在引言里把这列为亲身遇到的一个开放问题:相当一部分论文用互不兼容的单位描述训练数据,或者根本没有给出数量。
数据量少的一端也有结果。SmolVLA 用约 2.3 万段社区数据(表 5 记为 22.9k 段,来自 481 个社区 SO-100 数据集);TinyVLA、VLA-Adapter 和 VLA-0 完全不做机器人预训练。综述同时提醒,它们最强的结果来自 LIBERO 这类仿真基准,而这类基准测到的东西远少于真实使用。SimVLA 用一个 0.5B 的极简设计和标准化的训练配方追平大得多的模型,并据此认为,很多论文报告的增益很难和训练配方的差异分开。
配比也不是越杂越好。综述引用 π0.5 的消融:来自其他机器人和环境的数据,对没见过的家庭场景很重要;网络数据主要帮助识别机器人数据之外的物体,它对整体任务成功率的影响在统计上不显著。
模型规模、部署速度与操作-导航合流
参数量出现分化。2025–2026 年的多数模型在 3–7B;同时出现了一组 1B 以下的模型:SmolVLA(0.45B)、VLA-Adapter 与 SimVLA(0.5B)、X-VLA(0.9B)。RT-2(55B)仍是其中最大的机器人策略。VLA-Adapter 在单块消费级 GPU 上训练 8 小时。
速度数字更难比较。表 2 汇总了各论文自己报告的推理速度,单位各不相同:π0 在 RTX 4090 上机载推理每段 73 ms;OpenVLA-OFT 在 A100 上的 LIBERO 吞吐为 71.4 Hz、延迟 0.11 s;GR00T N1 在 L40 上每段 16 个动作用 63.9 ms;NaVILA 在 RTX 4090 上约每秒 1 帧。作者明确说,这些数字是吞吐、单段延迟、帧率和有效控制频率的混合,测在不同 GPU 上,不能直接排名。凡写明硬件的模型,都跑在单块桌面或数据中心 GPU(RTX 4090 或 5090、A6000、A100、L40、H100)或云端 TPU 上;嵌入式硬件只出现在拆分系统的边缘部分,例如 AsyncVLA(导航)放在 Jetson Orin 上的适配器。基于 7–8B 视频 VLM 的导航 VLA 通常放在远程 RTX 4090 或 A100 上,经网络调用。SmolVLA 的异步推理和动作块长度怎样算时间账,见 物理AI实验室 2.3 和 物理AI实验室 2.6。
第三个趋势是同时处理操作和导航的通用 VLA,例子是 UniVLA 和 Qwen-VLA。Qwen-VLA 的作者报告,一个模型在 LIBERO 上达到 97.9%,在 RxR 上成功率 59.6%。综述的看法是,两者都在训练阶段统一(汇集数据、共享动作接口),评测仍分在各自的操作和导航基准上;作者认为,统一模型的主要障碍可能正从架构转向数据和评测。
局限 / 注意
- 这是 arXiv 预印本综述 [R]。选文由作者按三条标准判断(原创想法、核心问题上的明显进展、提供社区工具),只带来小幅增益或把已有方法用到新领域的工作只引用、不讨论。
- 表 3 的计数取决于作者对“独特选择”的判断和这 22 个模型的选取;短横不表示模型缺少这一部分。这些是分类计数,综述没有给出不确定度;换一组模型,计数就可能不同。
- 综述摘录的数字仍是各原论文作者报告的。GR00T N1 一线四个版本都未经同行评审,N1.5 到 N1.7 只有发布说明。
- 本站读到的全文在第 8 节(VLA 与世界-动作模型)中途截止。第 9 节的基准与公平评测、第 10 节的开放问题和附录 A 的实践指南都不在所读文本中。摘要称部分在基准上接近满分的 VLA 在物体或相机稍有移动时就会失败,这一点本文只按摘要转述,没有核对其证据。
链接
- Vision-Language-Action Models: A Life-Cycle Survey of Design, Training and Deployment(arXiv 2611.18372)
- 论文 HTML 全文
- 物理AI实验室 3.1:VLA 拆解,把一个放杯动作编成 256 个区间的词元,再给三个模型的参数量与频率标清口径
- 物理AI实验室 3.3:RL 后训练,把 HIL-SERL 的“2 倍”和 RECAP 的“吞吐翻倍”放回各自条件,再复算三颗种子的配对区间
- 物理AI实验室 2.3:微调 SmolVLA,为一句指令配好示范数据,核对每个数字的口径,再给异步动作队列算时间账
- 物理AI实验室 2.6:上边缘,从时延日志算出控制频率上限,分清量化省下的是体积还是时间,再给动作块定长度
- 物理AI实验室:一套每个数字都能核对的物理 AI 课程


