
ロボット操作のシミュレーションベンチマークの多くは「横方向」に広がっています。ピック・アンド・プレース、押す、ドアを開けるといった比較的単純なスキルを、より多くの場面や物体に移していく形です。シンガポール国立大学などの Chongkai Gao らはプレプリント ManiLadder(arXiv 2611.16374、2026-11-12)で別の問いを立てました。ある方策はどの難度レベルの操作タスクまで安定して解けるのか、という問いです。著者らは、1 つの固定した参照方策が共通プロトコルで出す成功率によって 112 個のシミュレーションタスクを 4 レベルに分け、各タスクが目標の範囲に入るまでタスクを修正しました。このレベル分けを読むときは、まずどの方策に固定されているか、方策を替えるとどれだけ一致が残るかを確認する必要があります。以下の数字はすべて著者報告 [R] で、本サイトは著者のコードを実行していません。
タスクの構成
112 タスクは 32 のスイートに分かれ、各スイートは 3〜4 タスクです。同じスイート内のタスクは難度レベル、物体の種類、エンボディメントが共通で、スキルか物体だけが異なります。4 つのレベルはどれも同じ 3 つの軸で構成されています。物体は剛体(ドアや引き出しなどの関節物体を含む)と変形物体に分かれます。エンボディメントは単腕グリッパー、単腕多指ハンド、双腕グリッパー、双腕多指ハンドの 4 種類で、アームは Franka Panda、ハンドは LeapHand、台車の移動が必要な少数のタスクでは TidyBot++ を使います。スキルは文献に基づいて 9 つのファミリーに整理され、道具の使用、接触の多い組み立て、動的操作などを含みます。変形物体は次元で分けられ、ロープはカプセル形の剛体をつないだ関節チェーン、布は PBD ソルバー、粘土状の物体は MPM、液体は SPH で扱います。著者らは、40 を超える変形物体タスクを整理された構造に収めたシミュレーションベンチマークは ManiLadder が初めてだとしています。シミュレータは Genesis で、インターフェースは Gym 形式です。
標準の学習セットはタスクごとに 20 本のスクリプト示範、合計 2,240 本の軌跡で、20 Hz です。単腕タスクは 4 視点、双腕タスクは 5 視点で、画像は 640 × 480 です。標準の観測は RGB 画像と 1 文のタスク指示だけで、固有受容感覚もシミュレータの特権状態も与えません。外部での事前学習は、チェックポイントと入手可能な学習データの情報を開示すれば認められます。各タスクは固定した 50 個のテスト初期化シードで評価され、このシードは示範収集のシードと分けられ、全手法で共通です。
難度の校正方法
参照方策は学習可能パラメータ 50M の小型フローマッチング模倣学習方策です。凍結した RADIO 視覚エンコーダが多視点 RGB を読み、Transformer エンコーダ・デコーダがフローマッチングで行動チャンクをデノイズします。各タスクに示範 20 本を与え、batch size 256 で 40k ステップ学習し、5k ステップごとに 50 エピソードで評価します。学習中で最も高い成功率 s(T) によってレベルを決めます。
| レベル | 参照方策の成功率 s(T) | 50 エピソード換算の成功回数(本サイトの計算) |
|---|---|---|
| Level 1 | 60%–100% | 30–50 |
| Level 2 | 24%–58% | 12–29 |
| Level 3 | 6%–22% | 3–11 |
| Level 4 | 0%–4% | 0–2 |
50 エピソードの成功率は 2 ポイント刻みでしか動かないため、58% と 60%、22% と 24%、4% と 6% は隣り合う刻みで、区間のあいだに空白はありません。目標の範囲に入らないタスクは、設計(初期化範囲、空間的な許容誤差、物体の複雑さ、時間的な協調など)を変え、示範を集め直し、再学習・再評価します。著者らは 1 タスクあたり平均で約 4 回の修正が必要だったと報告し、人の主観的な難度の見積もりと、標準プロトコルでの経験的な難度信号との差が大きいことを示すと解釈しています。また、ManiLadder は方策に依存しない「絶対的な難度」を定義するものではなく、参照方策を測定器として使うと明記しています。
シードや方策を替えるとレベルはどれだけ残るか
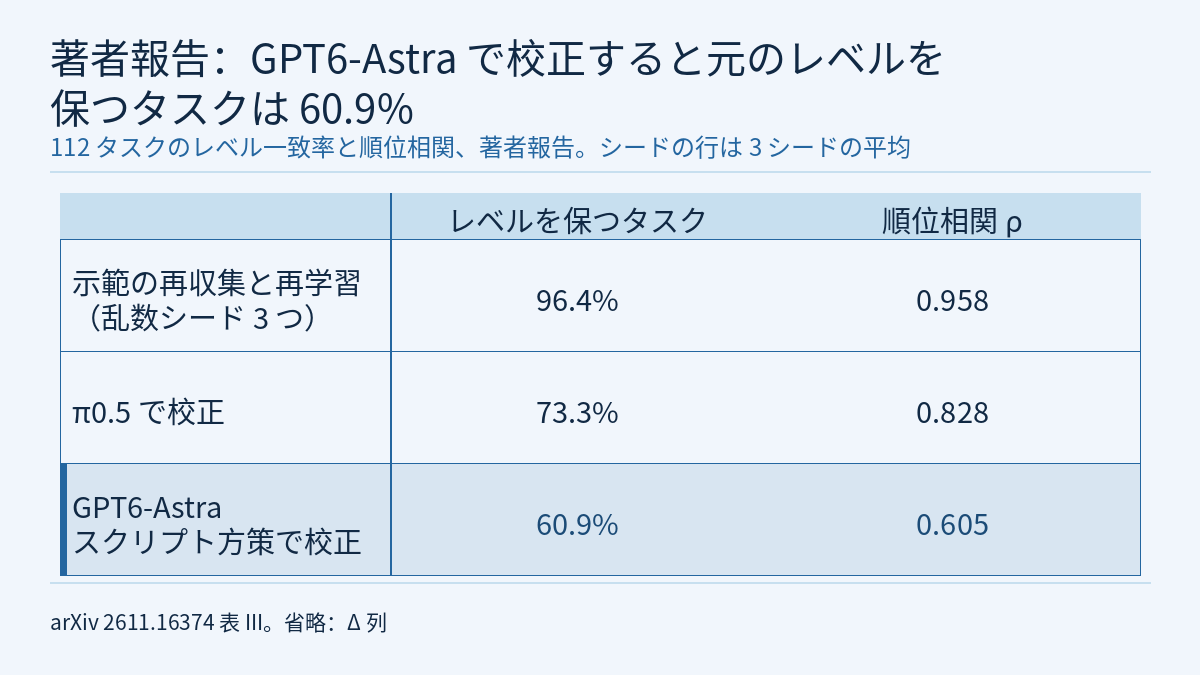
この測定器を確かめるため、著者らは 2 種類の検証を行い、各指標は 112 タスクすべてで計算しました。1 つ目は 3 つの乱数シードで示範 20 本を集め直し、再学習・再評価したものです。2 つ目はタスクを変えずに、別の 2 つの方策で校正をやり直したものです。π0.5(大規模な事前学習済みフローマッチング VLA)と、GPT6-Astra スクリプト方策です。後者では GPT-6 Astra Medium がコーディングエージェントとして、示範 20 本と最大 20 回の環境との相互作用エピソードから実行可能な Python 方策を合成します。ρ は元の校正とのタスク順位の相関、Δ は成功率の平均絶対変化、A は元のレベルを保ったタスクの割合です(論文の表 III)。
| 設定 | ρ | Δ(ポイント) | A(%) |
|---|---|---|---|
| 乱数シード 3 つ | 0.958 ± 0.006 | 5.67 ± 0.361 | 96.4 ± 3.100 |
| π0.5 | 0.828 | 12.95 | 73.3 |
| GPT6-Astra | 0.605 | 18.26 | 60.9 |
A から換算すると、π0.5 で校正した場合は約 26.7%、GPT6-Astra では約 39.1% のタスクがレベルを変えます(本サイトの計算)。著者らが強調するのは別の面で、3 手法とも平均成功率が Level 1 から Level 4 へ単調に下がるため、レベル単位の傾向は参照方策の外にも移ると述べています。個々のタスクでは差が大きく、GPT6-Astra は Stack6Blocks-v1 で 100%、DualArmRubikCube-v1 で 84% に達し、2 つの模倣学習方策はどちらも最大 8% でした。一方で、低いレベルの PushSoccer-v1 や ShapeTToI-v1 では成績が悪くなっています。
著者らは各タスクに 4 つの属性を付けました。時間スコア、物体の複雑さ、操作の複雑さ、知覚の難しさです。論文の図 6 では時間スコアが成功率と負の相関を示し、操作の複雑さや知覚の難しさが高いタスクも成功率が低い傾向にあります。ここから著者らは、難度は単一の属性ではなく複数の要因から生じると結論しています。
Attained Level:手法がはしごの何段目まで上れるか
ベンチマークの要約指標は Attained Level(AL)です。あるレベルとそれより下のすべてのレベルで、割合 ρ 以上のタスクが成功率のしきい値 τ に達したとき、そのレベルに到達したとみなします。論文は ρ = 0.8 に固定し、主指標の AL@50 は τ = 0.5、厳格な AL@80 は τ = 0.8 とします。50 エピソードでは、それぞれ 25 回以上、40 回以上の成功に当たります。AL = 0 は Level 1 の条件を満たしていないことを意味します。単一タスク学習(ST)での結果は次のとおりです。
- 小型フローマッチング方策:AL@50 = 1、AL@80 = 0。
- π0.5:AL@50 = 1、AL@80 = 0。
- GPT6-Astra:AL@50 = 0、AL@80 = 0。
GPT6-Astra は Level 2〜4 の平均成功率が 2 つの模倣学習方策より高いのに、AL は 0 です。理由は定義にあります。あるレベルに到達するには、それより下のどのレベルでもカバー率の条件を満たす必要があり、GPT6-Astra は Level 1 で満たしていません。AL と平均成功率は別の問いに答える指標なので、報告では両方を並べるのが適切です。エージェント型の手法は D20-E20 設定を使います。同じ示範 20 本に、探索エピソード 20 回の予算を加えたものです。開発中はオンラインの RGB と固有受容感覚を読めますが、タスク専用のエキスパートコード、隠れたシミュレータ状態、評価結果の利用は禁じられ、開発後はコントローラを凍結します。著者らは、GPT6-Astra には追加の探索エピソードと固有受容感覚の観測があるため、その向上をモデルの能力だけに帰することはできないと注意しています。
実験から得られた知見
- すべてで優位な手法はありません。小型フローマッチング方策と比べ、π0.5 は Level 1 の剛体・単腕多指ハンドのスイートで 27.5 ポイント、Level 2 の変形物体・単腕多指ハンドで 36.0、Level 3 の変形物体・単腕グリッパーで 34.0 高くなりました。一方、Level 1 の剛体・単腕グリッパーで 23.5、Level 2 の剛体・双腕多指ハンドで 27.5 低くなっています。π0.5 と比べ、GPT6-Astra は Level 3 の剛体スイート 4 つすべてで高く(7.0〜31.3 ポイント)、Level 2 の変形物体・双腕グリッパーで 63.3、Level 4 の剛体・双腕グリッパーで 37.5 高い一方、Level 3 の変形物体・双腕多指ハンドでは 0 でした。
- レベルをまたぐ転移の効果は小さく、同じレベル内のスイート間の転移は多くの場合プラスです。π0.5 をソース集合で学習してからターゲット集合でファインチューニングすると、改善したのは L2 → L1(+4.1 ポイント)だけで、L1 → L2 と L3 → L2 はそれぞれ −2.3、−4.4 でした。Level 2 で事前学習しても Level 3 はほぼ解けないままです。Level 2 内のスイート間 6 設定のうち 5 つがプラスで、最も大きいのは剛体 → 変形物体(+9.2)と 2 種類のエンドエフェクタ間(+6.1、+7.0)です。
- 112 タスクすべてを 1 つの方策で学習すると大きく下がります。MT-A(1 つの π0.5 方策を全タスクで同時に学習)は 32 スイートすべてで単一タスク学習を下回りました。Level 1 は 75.4% から 25.9%、Level 2 は 40.7% から 8.2% に下がり、Level 3 と Level 4 はいずれも 0.1% で、全体では 8.6% 対 33.5% です。論文の記述では、MT-A の総学習ステップ数は単一タスクの予算の 112 倍です。
- データを増やすと成功率は上がりますが、飽和にはほど遠い状態です。Level 2 の剛体タスク 16 個で π0.5 を同時にファインチューニングすると、タスクあたり示範 20、50、100、200 本で平均成功率は 21.4%、27.8%、29.6%、31.8% でした。単腕多指ハンドのスイートは 31.0% から 53.0%、双腕多指ハンドは 12.5% から 29.0% に上がり、双腕グリッパーのタスクは 20.0% から 12.0% に下がっています。
実機実験では 8 タスクを選び、X-Arm、Meta Quest 3 による遠隔操作、RealSense D435i 2 台を使いました。タスクごとに示範 20 本でフローマッチング方策を学習し、50 回評価しています(論文の表 IX)。
| タスク | 実機 | シミュレーション |
|---|---|---|
| PickPlacePen | 100% | 80% |
| HangMug | 40% | 44% |
| Stack6Blocks | 10% | 10% |
| PingPongTransport | 0% | 0% |
| UnfoldShirt | 80% | 70% |
| FoldShirt | 40% | 44% |
| BagHanging | 10% | 6% |
| BuildTent | 0% | 0% |
著者らの結論は、実機の結果がシミュレーションで校正した難度の順序をおおむね保っているというものです。シミュレーション列を上のレベル区間に当てはめると、前の 4 タスクと後ろの 4 タスクがそれぞれちょうど Level 1 から Level 4 に並びます(本サイトの推定。論文の図 7 は 8 タスクが 4 つの難度レベルから選ばれたとだけ述べています)。
本サイトの評価の講座との関係
フィジカルAIラボ 2.8 では成功率に Wilson 区間を付ける方法を扱いました。同じ方法で計算すると、50 エピソード中 30 回成功(60%、Level 1 の下限)の 95% Wilson 区間は約 46.2%–72.4% で(本サイトの計算)、Level 1 と Level 2 の境界をまたぎます。1 回の 50 エピソード評価だけでは、境界付近のタスクがどのレベルに属するかを決められません。レベル分けが安定していることを示す根拠は著者らのシード検証で、3 つのシードで 96.4% のタスクが元のレベルを保っています。2.8 では、複数回の実行から最良の 1 回だけを報告すると数字が高めに出ることにも触れました。ManiLadder の校正スコアは、まさに学習中の複数回の評価の最大値です(40k ステップを 5k ごとに評価するので約 8 回。本サイトがステップ数から換算)。これはレベル分けの規則の一部で、すべてのタスクに同じく適用されますが、s(T) を通常の 1 回の評価の成功率として読むべきではありません。対応のある比較、失敗ラベル、乱数シードの読み方は フィジカルAIラボ 1.8、シーズン全体の構成は講座の概要にあります。
制約と注意点
- arXiv のプレプリントで、数字はすべて著者報告 [R] です。本サイトは再現していません。論文はタスク定義、示範、評価プロトコルをバージョン付きのリリースとして凍結したとしていますが、読んだ本文にはコードやデータの入手先が書かれていません。
- 難度レベルは 50M パラメータの参照方策 1 つに固定されています。π0.5 や GPT6-Astra で校正すると、約 26.7% と 39.1% のタスクがレベルを変えます(本サイトが表 III から換算)。
- 標準偏差が示されているのはシード検証だけです。スイート別の成功率の表、AL の結果、実機の表には区間がなく、学習を何回繰り返したかも示されていません。そのため、数ポイントの差を確定した順位として読むべきではありません。
- GPT6-Astra と模倣学習方策では入力と予算が異なり(追加の探索エピソード 20 回と固有受容感覚)、比較しているのは異なる学習設定です。
- 実機実験は 1 つのプラットフォームでの 8 タスクで、確かめたのは難度の順序です。ハードウェアの安全性検証ではありません。
リンク
- ManiLadder: Benchmarking Robot Manipulation Through a Categorized and Multi-Difficulty Level Task Ladder(arXiv 2611.16374)
- 論文の HTML 全文
- フィジカルAIラボ 2.8:再現できる評価――Wald 区間と Wilson 区間を手で計算し、1/√n から評価回数を決め、失敗ゼロのあとの失敗率の上限を求める
- フィジカルAIラボ 1.8:評価――「差し引き +2」を対応表に分解し、失敗ラベルと乱数シードを計算で確かめる
- フィジカルAIラボ:すべての数字を確認できるフィジカルAI講座


