
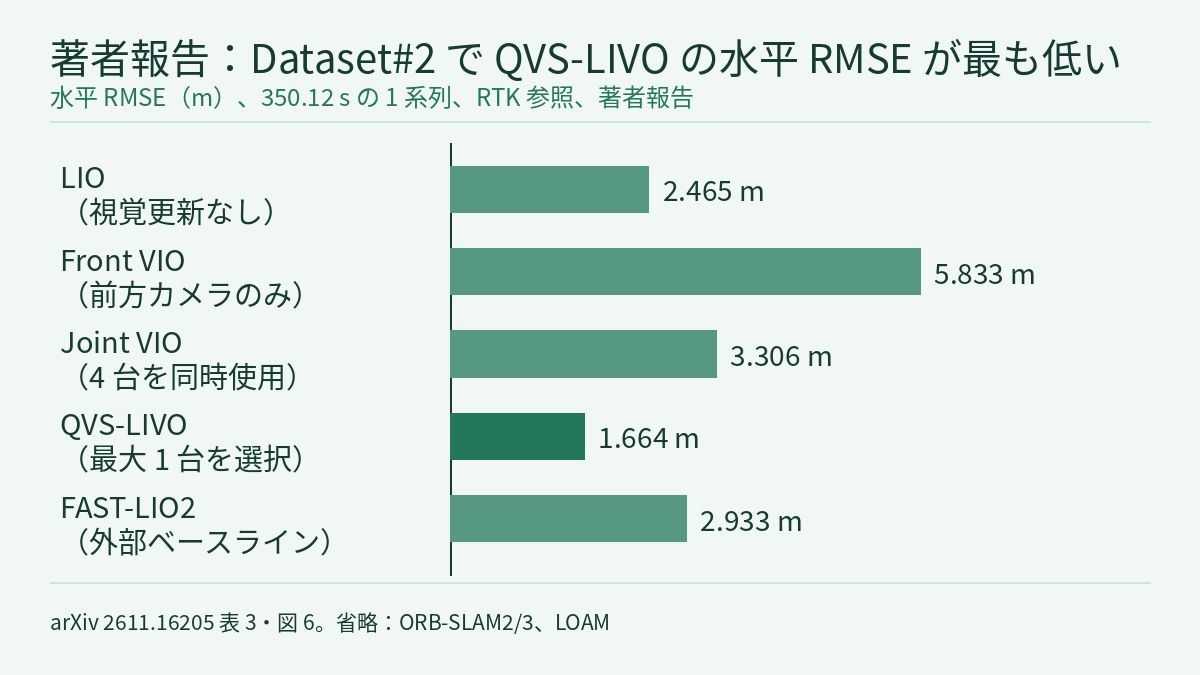
オフロードロボットに 4 台のカメラを載せても、どのカメラもいつでも信頼できるわけではありません。樹冠の影、急な明暗の変化、1 系統だけのフレーム欠落で、特定の方向の画像が劣化します。一方、構造の少ない場所ではライダーが一部の姿勢方向を十分に拘束できません。ハルビン工業大学 State Key Laboratory of Robotic Technology and System の Zihan Pan らはプレプリント QVS-LIVO RiskMap(arXiv 2611.16205)で、複数カメラの 2 つの用途を分けました。状態推定では 1 回の測光補正に使うカメラを最大 1 台に絞り、条件を満たす視点がないときや補正がチェックを通らないときはライダー・慣性の結果を保持します。セマンティックなリスク地図には、利用できるすべての視点を使います。著者報告では、350.12 s の Dataset#2 で水平 RMSE は 1.664 m で、4 台を同時に使う Joint VIO は 3.306 m でした。以下の数値はすべて著者報告 [R] で、本サイトは著者のコードを実行していません。
プラットフォームと課題
実験プラットフォームは AgileX Scout Mini の車体に、IMU 内蔵の Airy ライダーと、前・左・後・右を向いた Intel RealSense D435i 4 台を載せたものです。各カメラの水平視野は 69° で、4 つの視野は重ならず、隣り合う視野の間にすき間があります。さらに 4 本の支柱がライダーの水平カバー範囲を 86° の扇形 4 つに分けています。カメラ間にハードウェア同期はなく、ソースのタイムスタンプを使ってソフト同期の窓内で組み合わせます。搭載計算機は NVIDIA Jetson AGX Orin です。これとは別に C430i RTK-GNSS/INS が 1 Hz で参照位置を記録しますが、水平軌跡のオフライン評価にだけ使い、自己位置推定と地図作成には使いません。
推定器は FAST-LIVO2 のライダー・慣性推定と直接測光更新の枠組みを引き継いでいます。論文の出発点は次の観察です。画質のよい視点は、ライダーがすでに十分拘束している方向を補強しているだけかもしれません。ライダーの弱い方向を補える視点は、画像自体が信頼できないかもしれません。劣化した視点や時刻の対応がずれた画像を姿勢更新に入れると、計算量が増え、姿勢がずれるおそれもあります。地図作成の事情は異なり、自己位置推定に選ばれなかったカメラも、主視野の外にある障害物を写している可能性があります。
自己位置推定のフロントエンド:1 台をどう選ぶか
各周期の処理は次のとおりです。パラメータは論文の表 2 にある実験設定です。
- バッチ化:ソースのタイムスタンプに従い、[t0, t0 + 2Δs] の範囲でカメラごとに最大 1 枚の画像を取ります。ソフト同期の許容幅は Δs = 20 ms です。
- 読み取り専用の事前追跡:各視点が同じライダー・慣性の事後分布の上で残差と姿勢ヤコビアンを計算しますが、事後分布と視覚地図は変更しません。これが比較の共通基準になります。事前追跡の点数の上限は全体で 240、1 視点あたり最大 60 です。
- 健全度 h:7 つの指標をそれぞれ [0, 1] に正規化して加重平均します。重みは追跡点数 25%、追跡成功率 15%、測光残差 20%、画像のカバー範囲 10%、白飛び画素の割合 10%、暗い画素の割合 10%、平均勾配 10% です。
- 相補性 c:正規化したライダー情報行列を固有値分解し、情報量がしきい値(最大固有値の 5%)を下回る方向ほど大きな重みを与え、その視点の視覚情報がこれらの弱い方向にどれだけ乗るかを測ります。c はその回の条件を満たす視点の中の最大値で割り、c̃ ∈ [0, 1] とします。総合スコアは q = h × (1 + γc̃)、γ = 2 です。
- チャネル状態:各カメラは Healthy、Degraded、Isolated、Probation の 4 状態のいずれかにあります。低い健全度や追跡失敗が続けば劣化と判定され、致命的な画像障害があれば直ちに隔離されます。回復中のチャネルは Probation に入り、必要な健全観測の回数と回復時間を満たして初めて再び選択の対象になります。途中で回復が途切れると Isolated に戻ります。
- 切り替えのヒステリシス:現在選ばれている視点が条件を満たしている間は、挑戦側の q が現在の視点の 1.10 倍を有効な 3 周期連続で上回らないと切り替わりません(マージン m = 0.10)。現在の視点が条件を満たさなくなった場合は、すぐに選び直します。
- 確定前のチェック:バッチ、カメラ、タイムスタンプ、事後分布の世代が評価時と一致しなければ補正を棄却します。健全度が低いほど視覚の共分散を大きく膨らませ、その係数は κ = min(10, 1 / max(h, 0.10)) です。解いた後に残差、姿勢の増分、正規方程式の数値的な妥当性を確認します。どれかを満たさなければ事後分布を保持し、補正を捨てます。
総合スコアによる順位付けを、本サイトが作った架空の数値(論文のデータではありません)で示します。現在選ばれているカメラ A は h = 0.80、c̃ = 0.25 で、q = 0.80 × 1.5 = 1.20 です。挑戦側の B は画質が劣るものの、ライダーの弱い方向をちょうど補います。h = 0.60、c̃ = 1.00 で、q = 0.60 × 3 = 1.80 です。1.80 は 1.10 × 1.20 = 1.32 を上回りますが、B が選ばれるには有効な 3 周期連続で上回り続ける必要があります。選ばれた後は κ = 1 / 0.60 ≈ 1.67 となり、測光残差は健全度に応じて重みを下げられます。γ = 2 なので相補性はスコアを最大 3 倍にでき、健全度がやや低くても相補性の高い視点が勝つことがあります。
リスク地図:上限は幾何が決め、セマンティクスは範囲を限った補正だけ
地図作成の系統は自己位置推定の選択とは独立に、利用できるすべてのカメラを使います。セマンティックネットワーク TraverNet は Ultralytics YOLO26s の密なセマンティックモデルを grass、road、tree、other の 4 クラスに適応させたものです。セマンティックの結果はソースのタイムスタンプで点群と組み合わせ(窓は 0.5 s)、世界座標に固定した 2.5D グリッドへ投影します。複数の視点が同じ点を写している場合は光学的な奥行きが最も小さいものを使い、セマンティックの証拠は半減期 5 s で減衰させます。
幾何のリスクは傾斜、段差の高さ、粗さから作る連続値です。車両の通過高さの範囲に地面より上の構造があるセルは、セマンティックのクラスに関係なくリスクを最大値にします。セマンティクスは占有されていないセルだけを補正でき、重みの上限は 0.35 なので、連続値では幾何が常に大きい重みを持ちます。確定の経路は 2 つです。占有信頼度のしきい値を満たす硬い障害物はすぐに確定します。傾斜や段差から出た候補は、連結した 2 セル以上の支持と、直近 3 回の評価のうち 2 回以上の票が必要です。信頼度の高い低リスクのセマンティクスや走行済みの軌跡は候補の票を拒否できますが、硬い障害物を取り消すことも、単独で確定した高リスクを作ることもできません。有効な幾何観測のないセルは「不明」のまま残し、リスク 0 とは扱いません。出力は局所の Risk BEV、全域の 2.5D セマンティック・地形リスク地図、障害物インスタンスのボクセルの 3 種類です。
著者報告では、TraverNet の 4 クラス mIoU は 11 枚のローカル検証画像で 82.29%、962 枚の GOOSE 検証画像で 70.37% です。Dataset#1 のシーン統計では、road、grass、other、tree の平均リスクはそれぞれ 0.159、0.287、0.660、0.741 でした。今回読んだ本文には、リスク地図を走行可能性の正解データと比べた定量評価はありません。
著者が報告した自己位置推定と障害の結果
2 本の実地系列 Dataset#1(178.78 s)と Dataset#2(350.12 s)にはオフロード地形と舗装路の両方が含まれ、参照軌跡は C430i から得ています。4 通りの視覚の使い方はいずれも FAST-LIVO2 に基づきます。LIO は視覚更新を無効にし、Front VIO は前方カメラだけを使い(FAST-LIVO2 の元の構成)、Joint VIO は 4 台を同時に使い、QVS-LIVO は毎回最大 1 台を選びます。η_V は有効な視覚追跡ができていた時間の割合です。Joint VIO はどれか 1 台が有効なら有効とし、QVS-LIVO は選ばれた 1 台だけで判定します。
| 手法 | Dataset#1 RMSE(m) | Dataset#1 η_V(%) | Dataset#2 RMSE(m) | Dataset#2 η_V(%) |
|---|---|---|---|---|
| LIO | 1.042 | – | 2.465 | – |
| Front VIO | 1.222 | 44.9 | 5.833 | 64.9 |
| Joint VIO | 1.190 | 90.0 | 3.306 | 96.0 |
| QVS-LIVO | 0.910 | 86.6 | 1.664 | 95.3 |
この表で注目すべきは Joint VIO です。Dataset#2 で視覚追跡の時間割合は最も高い(96.0%)のに、水平 RMSE は 3.306 m で、視覚をまったく使わない LIO(2.465 m)より大きくなっています。著者はこれを、追跡できていることがよりよい姿勢拘束にはつながらず、劣化した視点や冗長な視点はライダー・慣性の事後分布にほとんど寄与しない、と解釈しています。色付き地図では、QVS-LIVO は地図作成に 4 台を使うため、有効な色付きボクセル数が Dataset#1 と Dataset#2 でそれぞれ Front VIO の 2.24 倍と 3.02 倍になり、同じく 4 台で色付けする Joint VIO よりわずかに少ない結果でした。
外部ベースラインとの比較では、FAST-LIO2(論文で使った車両対応版)が 2 系列で 0.987 m と 2.933 m で、QVS-LIVO はそれより 7.8% と 43.3% 低くなりました。ORB-SLAM2 は 1.197 m と 4.425 m、ORB-SLAM3 は 1.323 m と 4.011 m、LOAM は 5.682 m と 7.036 m です。
障害実験は Dataset#2 だけで行われました。ソース時刻 [105, 120) s の間、前・左・後・右のいずれか 1 台に 1 種類の障害を加え、他の入力は変えません。3 種類の障害と 4 台のカメラの組み合わせで 12 通りの構成になります。
- フレーム欠落:評価した Joint VIO の実装は 4 構成すべてで処理の滞留を起こし、軌跡が途中で終了しました。前方カメラだけを使う FAST-LIVO2 は前方カメラの欠落で 5.83 m から 14.40 m に、ARTI-VIO は 7.27 m から 17.42–29.24 m に悪化しました。QVS-LIVO は 1.76–2.21 m でした。
- 黒フレーム:Joint VIO は 2.08–2.39 m でした。QVS-LIVO は前・後・右カメラの障害で 1.75 m、1.86 m、1.94 m、左カメラの障害では両者とも 2.09 m でした。
- タイムスタンプのずれ +60 ms:前方カメラの ORB-SLAM2 は 4.43 m から 58.70 m に悪化しました。Joint VIO は 2.14–3.25 m、QVS-LIVO は 1.54–2.23 m で、左カメラでは Joint VIO がわずかに低い値でした(2.14 m に対して 2.23 m)。
12 構成すべてで QVS-LIVO は完全な軌跡を出力し、水平 RMSE は 1.54–2.23 m でした。カメラに依存しない FAST-LIO2 の通常実行の結果 2.93 m より 23.9%–47.4% 低い値です。ただし、障害時の最小値 1.54 m は、QVS-LIVO 自身の通常入力時の 1.664 m より低くなっています。本サイトの推測では、1 回ごとの実行のばらつき、または障害で選ばれる視点が変わったことを反映している可能性があります。論文は繰り返し実行もばらつきも報告していないため、障害構成どうしの 0.1 m 単位の差を確かな順位と読むべきではありません。
搭載環境での実行時間
AGX Orin 上で、局所の Risk BEV は 9.94 Hz で出力され、処理時間の中央値は 32.4 ms、P95 は 37.9 ms でした(観測窓 30 s)。全域地図は 2.00 Hz で、中央値 486.4 ms、P95 516.1 ms です(観測窓 180 s)。論文の表 2 では 2 つの配信周期がおよそ 10 Hz とおよそ 2 Hz に設定されているので、9.94 Hz と 2.00 Hz は設定どおりのペースで達成された出力周期であり、処理能力の上限はここからは読み取れません。全域地図の P95 は 2 Hz に対応する 500 ms の周期をすでに超えていますが(本サイトの計算)、今回読んだ本文には、パイプラインがこの超過をどう扱うかの説明はありません。これらの時間はすべて地図作成のものです。Orin 上での自己位置推定フロントエンドの 1 周期あたりの時間は、今回読んだ本文には個別に示されていません。
本サイトの講座との関係
フィジカルAIラボ 1.3 では、1 種類のセンサーは世界の一側面しか見ておらず、どのセンサーも完全ではないので互いに確かめ合う必要がある、と説明しました。この論文はその具体的なやり方の 1 つを示しています。まず共通のライダー・慣性の事後分布の上で各カメラを採点し、そのうえで姿勢を変えさせるかを決め、条件を満たさなければ元の結果に戻ります。周波数、中央値、P95 がそれぞれ何を表すか、設定された周期と能力の上限の違いについては フィジカルAIラボ 2.6 を参照してください。論文は 12 通りの障害構成について繰り返し実行を報告していません。条件ごとに結果を分けて読む方法や、繰り返し回数がなぜ重要かは フィジカルAIラボ 1.8 で扱っています。シーズン全体の構成は講座の概要にあります。
制約と注意点
- arXiv のプレプリントで、数値はすべて著者報告 [R] です。本サイトは再現していません。論文はコードと関連資料を公開したとしていますが、本サイトはそのリポジトリを確認していません。
- 評価はプラットフォーム 1 台、系列 2 本(178.78 s と 350.12 s)だけで、参照は 1 Hz の RTK-GNSS/INS、指標は水平誤差だけです。論文は繰り返し実行、信頼区間、ばらつきを報告していません。
- 障害は Dataset#2 の 15 s の区間で 1 台ずつ注入したもので、複数カメラの同時障害や長時間の劣化は含みません。フレーム欠落時に Joint VIO が終了した件について、論文は「評価した Joint VIO の実装」に限定しており、すべての同時融合手法に当てはまるわけではありません。
- リスク地図について論文が示しているのはセマンティックセグメンテーションの mIoU とクラスごとの平均リスクで、今回読んだ本文には走行可能性の正解データやナビゲーションの結果はありません。ローカルのセマンティック検証画像は 11 枚だけです。
- 本サイトが読めた本文は考察の節の途中で切れており、著者自身による制約の節は読んでいません。
- カメラ A、B の数値は本サイトが作った架空の教材例で、論文の結果ではありません。これは実地データとオフライン再生による評価であり、ハードウェアの安全性検証ではありません。
リンク
- QVS-LIVO RiskMap: Health- and Information-Aware View Selection for Multi-Camera LIVO and Off-Road Risk Mapping(arXiv 2611.16205)
- 論文の HTML 全文
- フィジカルAIラボ 1.3:センサー――1 つのコップで画素数、深度の測定範囲、握る力を手計算する
- フィジカルAIラボ 2.6:エッジへ――遅延のログから制御周波数の上限を求め、量子化で減るのが容量か時間かを見分け、動作チャンクの長さを決める
- フィジカルAIラボ 1.8:評価――「差し引き +2」を対応表に分解し、失敗ラベルと乱数シードを計算で確かめる
- フィジカルAIラボ:すべての数字を確認できるフィジカルAI講座


