この回の動画
ナレーションは AI 合成音声です。 動画の章・文字起こし・出典
文字起こし
文字起こし
知行の問い
ロボットはコップを持ち上げられる。なのに、キッチン全体の片づけだと、どうしてよく途中で止まっちゃうの?今回は長期タスクの話です。なぜ仕事が長くなると崩れるのか。そして、階層化とルーティングで、どう立て直すのか。
長いタスクはなぜ崩れる
前回は、一つの方策をどんどん強くしました。でも得意なのは、数秒の動作です。それより長いと、手が回りません。キッチンの片づけは何十ステップもあります。台をふく、皿を下げる、ゴミを出す。どのステップでも、小さなミスが起こりえます。綱渡りにたとえましょう。一歩進むのは難しくありません。難しいのは、何十歩も落ちずに進むこと。しかも、途中でやり直せません。言いかえると、モデルは一歩ごとに推測しています。一歩を当てる確率は高い。でもその確率は掛け算で効くので、何十歩も続くと、全部を当てられる確率は下がっていきます。さらに悪いことに、小さなミスは、積み重なっていきます。一歩目が少しずれると、二歩目はもっとずれ、先へ行くほどひどくなります。閉じたループでは、もっと厄介です。ロボットは動きながら見ていて、自分の動作が、次に見える画面を変えてしまいます。一歩まちがえると、見える世界もゆがむのです。研究者はこれを、誤差の蓄積と呼びます。最初から最後まで一つで受け持つ単一の方策では、なかなか耐えきれません。この種の仕事には名前があります。長期タスクです。求められるのは、一歩ずつ正しくやることだけではありません。長い手順を、しっかりつなげることです。どこか一歩が難しすぎるんじゃなくて、ミスが一歩ずつ雪だるまになるんだ!
ゆっくり考え、すばやく動く
解決策の一つは、頭を二つの層に分けることです。一つは全体をゆっくり考え、もう一つは手足をすばやく動かします。単一の方策を大きくすればいいのでは、と思うかもしれません。少しは役に立ちます。でも、考えることと動くことは、もともとテンポが違うのです。エヌビディアのある論文は、これを二つのシステムとして書きました。システム二は画像を見て、指示を聞き、環境を理解する。システム一は、動作をリアルタイムで生成します。エヌビディアのブログは、新しいグルート、エヌ一点七を紹介しています。そのシステム二こそが、タスクの分解と多段階の推論を行う場所です。高速な層は、どれくらい速いのか。AWSのエンジニアリングブログが、H100 の上で、ODE を一ステップだけ解いて実測しました。この条件で、π0 は、五十ステップの動作を一つのまとまりにします。まとまり全体の生成は、二百ミリ秒未満です。ですから、一ミリ秒ごとに考え直す必要はありません。一つのまとまりは約一秒分の動作ですが、計算は二百ミリ秒未満で終わります。そのため一秒に約五回、計画を立て直せます。前のまとまりが終わる前に、新しいまとまりに切り替わるのです。この分担の利点は、はっきりしています。ゆっくりした層は大規模モデルでじっくり考え、速い層は高い頻度で安定して力を出す。それぞれが自分の役目を果たします。大脳はゆっくり考えて、小脳はすばやく動く。ロボットも同じように分担するんだ!ただし、これはたとえにすぎないけどね。
複数方策のルーティングと記憶
二つの層に分けるだけでは足りません。ゆっくりした層は、段取りもできなければなりません。つまり、このステップでどのスキルを呼ぶかを決めるのです。これは、オーケストレーターのようなものです。手元に、いくつものスキルを持っています。つかむ、ドアを開ける、机をふく。それぞれが一部分を受け持ちます。なんでもできる一つの方策では、だめなのでしょうか。それもできます。でも、スキルを分けておくと利点があります。一つずつテストし、一つずつ入れ替え、一つずつ原因を探せるのです。オーケストレーターは、どう選ぶのか。大きく分けて、二つの考え方があります。一つは、スキルごとに実行できそうかの点数をつけ、いちばん高いものを選ぶ。もう一つは、モデルに次の一歩を直接考えさせる方法です。初期のロボット研究に、こんなものがあります。論文によると、言語モデルが次の一歩を提案し、スキルの価値関数が、それを実行できるかを判断します。どこがうまいのか。言語モデルは自由に発想し、価値関数がそれを現実に引き戻す。思いつくだけでなく、手が届かなければならないのです。もう一つの論文は、ハイ・ロボットといいます。上位の層がまず次の一歩を考え、それから下位の層が動きます。論文は、三種類のロボットで検証しました。その上で、パイゼロてんごは、さらに一歩進みました。論文によると、まず次のサブタスクを予測し、それを具体的な動作に落とします。まず何をするか、次にどうするか、です。論文によると、パイゼロてんごは、何種類ものデータを混ぜて学習します。そのおかげで、入ったことのない新しい家でも、キッチンや寝室をだいたい片づけられるそうです。最後のピースは、記憶です。オーケストレーターは、どのステップが終わり、どれがまだかを覚えていなければなりません。それが進み具合の表です。記憶には二種類あります。一つは、ごく短い今、手にいま何を持っているか。もう一つはタスク全体の記憶、仕事がどこまで進んだかです。記憶がないと、ロボットは、もう出したゴミを、もう一度出そうとするかもしれません。記憶があってはじめて、自分がどこにいるか分かるのです。だから長いタスクは、一つの大きなモデルじゃなくて、段取りのできる小さなチームなんだ!
実践:オーケストレーターを作る
これらを組み合わせたものが、今回の主役です。一つのオーケストレーターと、部分ごとに分かれた方策のセットです。完全版のオーケストレーターは、本来、公開ベンチマークのリベロテンで動かすものです。AWSのブログによると、十種類の卓上の操作タスクがあります。ここでは動かしていません。今回の付属の実験は、その代わりに CPU 上で動かす、二次元の簡易版です。どのベンチマークを使うにしても、長いタスクの評価では、何ステップも続けてやる力を試す必要があります。単一ステップのベンチマークでは、誤差の蓄積は見えません。オーケストレーターは、こう動きます。まず上位の層が画面をちらっと見て、次のサブタスクを告げます。このステップは考えるだけで、手は動かしません。次に、そのサブタスクを下の層の方策に渡して、実行させます。たとえば、ファインチューニングしたグルート。そのやり方は、次回で説明します。一ステップ終わったら、進み具合の表に記入し、次のステップを見ます。これが、ルーティングと記憶のへいループです。ぐるぐると回り続けます。乱数シードを変えて、何回か多めに走らせるのを忘れずに。長いタスクの成功率は、ぶれが大きいのです。一回だけの数字を、信じすぎないでください。再現に成功したと、どう判断するか。ポイントは、成功率を二種類に分けて見ることです。一つはステップごと、もう一つはチェーン全体です。上位の層だけを入れ替えて、ほかは何も変えない、という手もあります。チェーン全体の成功率が変われば、ボトルネックは段取りの部分です。きれいな対照実験になります。まだとけていないのは、上位の層がスキルを選びまちがえると、やはり誤差が積み重なること。それに、いまの記憶はたいてい短い。長期の記憶は、まだ難題です。ふりかえりです。ポイントは三つ。一つ、長いタスクの難しさは、誤差が積み重なること。二つ、階層化で、ゆっくり考え、すばやく動く。三つ、オーケストレーターがルーティングと記憶を受け持つ。大きな問題を小さなステップに分けて、一歩ずつ見張れば、ロボットはそう簡単には崩れないんだ!でも、下位のあの方策を、自分のロボットに合わせるには、どう調整するの?また次回!
根拠と出典
練習とセルフチェック
小テストは公開で、回答するとすぐ解説が出ます。読み物の練習問題の答えはログイン会員向けです。
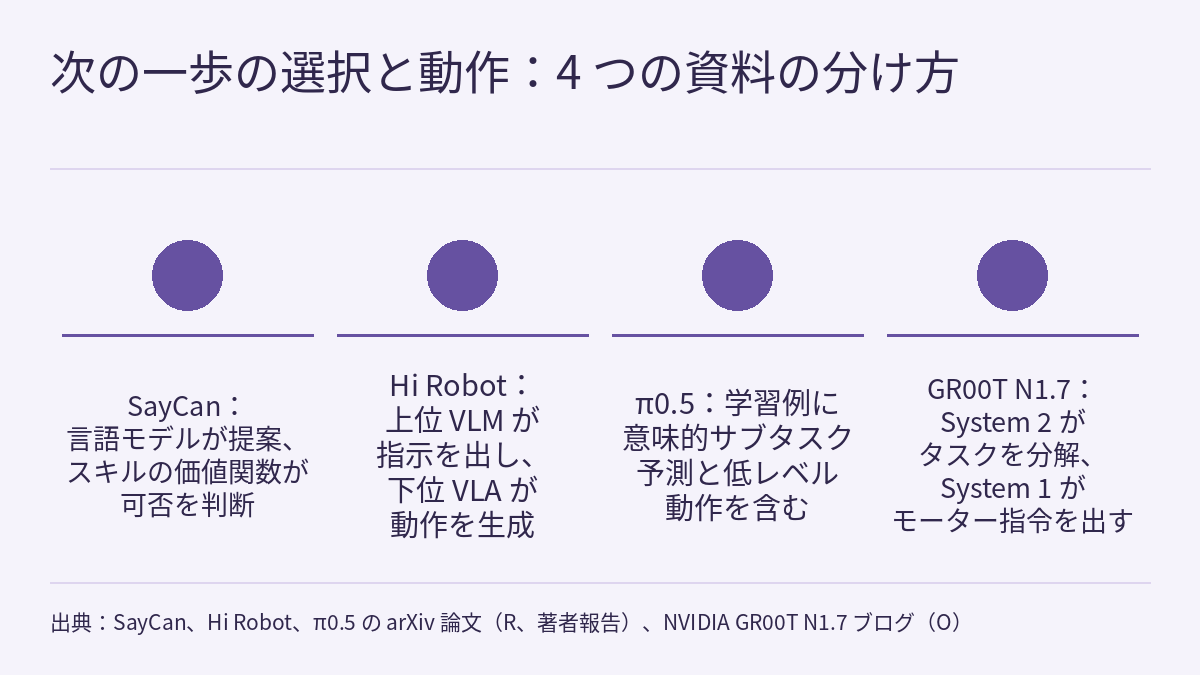
第 3.4 回の動画は、長期タスクを扱います。コップを持ち上げられるロボットでも、キッチン全体の片づけになると途中で崩れることがよくあります。一歩ごとの小さなミスが積み重なり、最初から最後まで一つで受け持つ単一の方策では耐えきれないからです。対策は階層化で、ゆっくりした層が大局を考え、速い層がリアルタイムで動作を出します。さらにオーケストレーターが、このステップでどのスキルを呼ぶかを決め、進み具合の表でどこまで終わったかを覚えます。動画は四本の論文と二本のブログを引用しています。SayCan(arXiv 2204.01691)、Hi Robot(arXiv 2502.19417)、GR00T N1(arXiv 2503.14734)、π0.5(arXiv 2504.16054)、NVIDIA による GR00T N1.7 の Hugging Face ブログ、そして SageMaker HyperPod での π0 のファインチューニングについての AWS のブログです。このページはこの回の解説と練習です。文字起こしは繰り返さず、動画が結論だけを述べて展開しなかった三つのことを行います。SayCan、Hi Robot、π0.5、GR00T N1.7 のブログという四つの資料がそれぞれ「次の一歩を選ぶこと」と「動作を出すこと」をどう分けているかを原文に戻し、AWS のブログから速い層のタイミングを一行だけ加えます。架空のキッチンのタスクを使い、ステップごとの成功率がどのようにチェーン全体の成功率になるのか、そして「各ステップは独立」という仮定がいつ計算を誤らせるのかを手で計算します。さらに、進み具合の記憶と再試行が変えるのはどの量で、その代償は何かを確かめます。全体を通す約束は、ステップごとの成功率とチェーン全体の成功率は別の量で、分けて報告すること、そして成功率や遅延はそれを報告したシステム、タスク、設定だけのものだ、ということです。
この回の動画、文字起こし、出典はこのページの上部にあります。シーズン全体の構成は講座の概要をご覧ください。前回のフィジカルAIラボ 3.3:RL事後学習――HIL-SERL の「2 倍」と RECAP の「処理量 2 倍以上」をそれぞれの条件に戻し、三つのシードの対応のある区間を計算し直すは、方策は強くなったが、長いタスクではどう覚え、どう計画するのか、という問いで終わりました。この回はその続きです。一本の軌跡の中で誤差がお手本のカバー範囲からどうはみ出すかは、フィジカルAIラボ 1.6:模倣学習――誤差がお手本のカバー範囲からはみ出すまでを手で計算し、ACT・拡散方策・データのスケーリング則の数字をそれぞれの条件に照らして読むで手計算しました。見る・考える・動くの三つの周波数がそれぞれどのシステムのものかはフィジカルAIラボ 0.3:見る・考える・動く――3 つの周波数をそれぞれのシステムに戻すで、GR00T N1 のデュアルシステムの構造とパラメータはフィジカルAIラボ 3.1:VLA を分解する――コップを置く動作を 256 区間のトークンに直し、三つのモデルのパラメータ数と周波数の範囲を確かめるで扱いました。AWS のブログの「200 ms 未満、約 5 Hz で再計画」の時間の計算と、動作チャンクの長さの決め方はフィジカルAIラボ 2.6:エッジへ――遅延のログから制御周波数の上限を求め、量子化で減るのが容量か時間かを見分け、動作チャンクの長さを決めるで計算しました。対応表と区間は、フィジカルAIラボ 1.8:評価――「差し引き +2」を対応表に分解し、失敗ラベルと乱数シードを計算で確かめるとフィジカルAIラボ 2.8:再現できる評価――Wald 区間と Wilson 区間を手で計算し、1/√n から評価回数を決め、失敗ゼロのあとの失敗率の上限を求めるで計算しました。この回はそれらを繰り返さず、複数のサブタスクを一本のチェーンにつないだあとの成功率、記憶、ルーティングだけを扱います。次回 3.5 は GR00T ファインチューニング実践です。
公開小テストの 5 問には詳しい解説が付いています。ログインすると、三つの練習に取り組めます。架空のテーブル片づけの記録から、ステップごとの周辺成功率、独立近似、本当のチェーン成功率を求める。三つの架空のルーターの集計表から、チェーン成功率、呼び出しのコスト、失敗の内訳を計算し、どこを先に直すかを決める。架空のルーティングのアブレーション報告を審査し、対応のある差の区間を計算して結論を書き直す。いずれにも段階的な解答例、よくある誤り、20 点満点の採点基準が付いています。
1. 四つの資料は「次の一歩を選ぶ」と「動作を出す」をどう分けるか
SayCan、Hi Robot、GR00T N1、π0.5 はいずれも arXiv のプレプリントで、本講座の区分では R レベルです。GR00T N1.7 のブログは NVIDIA による自社モデルの紹介、AWS のブログは AWS による自社のファインチューニング実験の報告で、どちらも O レベルです。以下の構成と数字はすべて著者またはベンダーの報告で、本サイトはどのシステムも動かしていません。動画の数字カードに対応する原文を、それぞれ独立に引用します。ここで横に並べて比べる四つの資料は SayCan、Hi Robot、π0.5、GR00T N1.7 のブログです。GR00T N1 の論文は N1.7 の背景としてのみ引用し、AWS の行は速い層のタイミングを補うだけで、五つ目の分け方ではありません。
SayCan(arXiv 2204.01691)の要旨は、言語モデルとスキルの分担をこう書いています。
We show how low-level skills can be combined with large language models so that the language model provides high-level knowledge about the procedures for performing complex and temporally-extended instructions, while value functions associated with these skills provide the grounding necessary to connect this knowledge to a particular physical environment.
要旨はさらに、言語モデルには実世界の経験がないこと、事前学習したスキルでモデルを制約し、実行可能で文脈にも合う自然言語の行動だけを提案させることを述べています。手法は移動マニピュレーター上の複数の実世界タスクで評価されています。この一節によれば、「次の一歩を選ぶ」のは二つの部分の組み合わせです。言語モデルが手順の知識を出し、各スキルの価値関数がその一歩を今の環境で実行できるかを判断します。動画の「思いつくだけでなく、手が届かなければならない」はこの意味です。
Hi Robot(arXiv 2502.19417、著者の所属は Physical Intelligence、Stanford University、UC Berkeley)は、上位層も下位層も視覚・言語モデルで作ります。上位の VLM は自由形式のタスクの指示とカメラ画像を読み、「grasp the cup」のような原子的な指示を出します。下位は VLA で、その指示、画像、ロボットの状態から動作チャンクを生成します。論文は二つの層のテンポが違うことを明記しています。
The two processes run at different rates: the low-level process produces action chunks at a high frequency, while the high-level process is invoked less often, either after a set time or upon receiving new language feedback.
読んだ範囲では、それぞれの層の周波数は示されていません。動画の「3 種類のロボット」の数字カードは、この一文に対応します。
We evaluate our system across three robotic platforms, including single-arm, dual-arm, and dual-arm mobile robots, demonstrating its ability to handle tasks such as cleaning messy tables, making sandwiches, and grocery shopping.
論文はまた、Hi Robot が人の意図との一致とタスクの成功の両方で、API 経由の VLM や階層のない VLA 方策を含むいくつかの既存手法を上回ったとしています。読んだ範囲に具体的な数字はありません。上位層を学習させるため、著者は VLM を使い、ロボットのデータにあり得た指示や人の割り込みを合成しています。いずれも著者の報告です。
π0.5(arXiv 2504.16054)の要旨は、まず π0 との関係を述べます。
We describe $\pi_{0.5}$, a new model based on $\pi_{0}$ that uses co-training on heterogeneous tasks to enable broad generalization.
次に、学習例に何が含まれるか、そして著者の結論を述べます。
Our system uses a combination of co-training and hybrid multi-modal examples that combine image observations, language commands, object detections, semantic subtask prediction, and low-level actions. Our experiments show that this kind of knowledge transfer is essential for effective generalization, and we demonstrate for the first time that an end-to-end learning-enabled robotic system can perform long-horizon and dexterous manipulation skills, such as cleaning a kitchen or bedroom, in entirely new homes.
要旨の書き方に注意してください。意味的なサブタスクの予測と低レベルの動作が同じ種類の学習例に入っていて、システムはエンドツーエンドで学習されます。動画はこれを「まず次のサブタスクを予測し、それを具体的な動作に落とす」と説明しています。要旨は成功率を示しておらず、「初めての家」がいくつあったか、各家で何回試したかも書いていません。「初めて示した」は著者の言い方です。
GR00T N1.7 の Hugging Face ブログ(NVIDIA、2026 年 4 月 17 日公開)は、3B パラメータのオープンな推論型 VLA で、上位の推論と低レベルのモーター制御をデュアルシステムの設計で分けている、と説明しています。
System 2 (Vision-Language Model): A Cosmos-Reason2-2B backbone processes image tokens and language instructions to produce high-level action tokens. This is where task decomposition and multi-step reasoning happen.
System 1 は 32 層の拡散 transformer で、VLM の出力とリアルタイムのロボットの状態を受け取り、ノイズを除いてモーター指令をリアルタイムで出します。Hi Robot と違い、二つの層の間で渡されるのは「上位の行動トークン」で、読める言語の指示ではありません。動画は前の版の GR00T N1 の論文も引用しています。この論文は System 2 を環境を理解する視覚・言語モジュール、System 1 を動作をリアルタイムで生成する拡散 transformer モジュールとし、System 2 は NVIDIA L40 上で 10 Hz、System 1 は 120 Hz で閉ループの動作を出すと書いています。N1 の構造は 3.1 で分解したので、ここでは繰り返しません。N1 論文の数字は N1 だけのもので、N1.7 に当てはめることはできません。
速い層の時間の計算は AWS のブログから来ています。ブログは H100 を 8 基積んだ 1 台のノードで π0 をファインチューニングしています。π0 は一度に先の 50 タイムステップ分の動作チャンクを予測し、推論時間も H100 上と明記されています。
At 1 ODE step on H100, a full 50-timestep chunk takes under 200 ms, so the policy can re-plan at about 5 Hz while each chunk covers roughly one second of robot motion.
ブログは LIBERO で ODE のステップ数を変えて測っています。10 ステップから 1 ステップに減らすと、遅延は 379 ms から 197 ms に下がり、著者によると精度は落ちませんでした。これらの時間は π0、このファインチューニング、このハードウェアだけのものです。2.6 ですでに再計画の周期を計算したので、ここでは繰り返しません。
次の表は、読んだ範囲を本講座が整理したもので、どの原文の表でもありません。
| 資料 | レベル | 次の一歩を選ぶのは | 層の間で渡すもの | 読んだ範囲で示されたテンポ |
|---|---|---|---|---|
| SayCan(arXiv 2204.01691) | R | 言語モデルが提案し、スキルの価値関数が実行可能性を判断 | 事前学習したスキルに対応する自然言語の行動 | 示されていない |
| Hi Robot(arXiv 2502.19417) | R | 上位の VLM | 原子的な言語の指示 | 下位は高い頻度で動作チャンクを出す。上位は設定した時間ごと、または新しい言語のフィードバックを受けたときに呼ばれる |
| π0.5(arXiv 2504.16054) | R | 要旨は推論時の分担を明記していない | 学習例に意味的サブタスクの予測と低レベルの動作を含む | 示されていない |
| GR00T N1.7 ブログ(NVIDIA) | O | System 2 がタスクを分解 | 上位の行動トークン | 引用した一節には示されていない |
| AWS π0 ブログ | O | 上位層は扱わない | 該当しない | H100、ODE 1 ステップ:50 ステップの動作チャンクが 200 ms 未満、約 5 Hz で再計画、各チャンクは約 1 秒分 |
四つの分け方と速い層のタイミングの一行を横に並べたのは、原文どうしが互いに比較していないからです。表の順番は順位ではありません。四つが一緒に示しているのは、「次の一歩を選ぶ」ことと「その一歩を実行する」ことを、別々のモジュールが別々のテンポで受け持てる、という一点だけです。どの分け方があなたのタスクでうまくいくかには、どの資料も答えていません。
ログインすると、このレッスンの続きと確認問題、解答を読めます。
制約と注意点
- SayCan、Hi Robot、GR00T N1、π0.5 はいずれも arXiv のプレプリントで R レベル、GR00T N1.7 のブログと AWS のブログは O レベルで、それぞれ NVIDIA と AWS による自社のモデルや実験の報告です。構成、数字、「初めて」といった言い方は著者またはベンダーの報告で、本サイトは再現しておらず、どのシステムも動かしていません。
- この回で読んだのは、SayCan と π0.5 の要旨、Hi Robot の要旨と第 1〜4 節の一部、GR00T N1 の要旨、序論、第 2 節の一部、GR00T N1.7 のブログ、AWS のブログの一部の節だけです。読んだ範囲には、π0.5 の成功率、Hi Robot の各層の周波数、ほかの手法に対する Hi Robot の具体的な数字はありません。
- AWS のブログの時間は π0、そのファインチューニングの設定、H100 だけのものです。LIBERO で報告されているのは動作予測の誤差で、評価は取り分けたエピソード 5 本だけです。閉ループのタスク成功率ではありません。
- 動画は、この回では完全版のオーケストレーターを LIBERO-10 で動かしていないと説明しています。この回の計算はすべて架空の数字を使い、どの実行記録も引用していません。
- 次のものは本講座の整理、計算、推論です:1 節の対照表、2 節と 3 節の掛け算・条件付き確率・呼び出し回数、4 節の比較のチェックリスト。
- キッチン K、ルーター A〜D、チーム L、テーブル片づけのタスク、すべての対の件数は架空です。紙の上の計算もシミュレーションの結果も、ハードウェアの安全性の検証ではありません。
リンク
- フィジカルAIラボ:すべての数字を確認できるフィジカルAI講座(講座の概要)
- フィジカルAIラボ 3.3:RL事後学習――HIL-SERL の「2 倍」と RECAP の「処理量 2 倍以上」をそれぞれの条件に戻し、三つのシードの対応のある区間を計算し直す
- フィジカルAIラボ 3.1:VLA を分解する――コップを置く動作を 256 区間のトークンに直し、三つのモデルのパラメータ数と周波数の範囲を確かめる
- フィジカルAIラボ 2.6:エッジへ――遅延のログから制御周波数の上限を求め、量子化で減るのが容量か時間かを見分け、動作チャンクの長さを決める
- フィジカルAIラボ 1.6:模倣学習――誤差がお手本のカバー範囲からはみ出すまでを手で計算し、ACT・拡散方策・データのスケーリング則の数字をそれぞれの条件に照らして読む
- フィジカルAIラボ 0.3:見る・考える・動く――3 つの周波数をそれぞれのシステムに戻す
- フィジカルAIラボ 1.8:評価――「差し引き +2」を対応表に分解し、失敗ラベルと乱数シードを計算で確かめる
- フィジカルAIラボ 2.8:再現できる評価――Wald 区間と Wilson 区間を手で計算し、1/√n から評価回数を決め、失敗ゼロのあとの失敗率の上限を求める
- SayCan:ロボットのスキルの実行可能性で言語モデルを接地する(arXiv 2204.01691)
- Hi Robot: Open-Ended Instruction Following with Hierarchical Vision-Language-Action Models(arXiv 2502.19417)
- GR00T N1: An Open Foundation Model for Generalist Humanoid Robots(arXiv 2503.14734)
- π0.5:π0 をもとに、異種のタスクで共同学習した VLA(arXiv 2504.16054)
- NVIDIA Isaac GR00T N1.7: Open Reasoning VLA Model for Humanoid Robots(Hugging Face ブログ)
- AWS:Fine-Tuning π0 (Pi-Zero) for robotic manipulation on Amazon SageMaker HyperPod EKS