
プレプリント Kinematic Hypothesis Context: Embodiment-Conditioned Learned Video Coding for Bandwidth-Limited Robot Policy Uplinks(arXiv 2611.07411、2026-11-05、著者 Yuze Lu、清華大学)が扱うのは、VLA 方策をリモートの GPU で動かし、ロボットは数 kbps の上りリンクでしかカメラ画像を送れない状況です。出発点は、ロボットのカメラ画像の変化の多くがロボット自身の動きによるものであり、受信側はもともと関節角、ロボットモデル、カメラキャリブレーションを持っているので、その部分は両端でそれぞれ計算でき、ビットを使って送る必要はない、という点です。著者は、LIBERO のシミュレーション閉ループで、6 kbps の予算における OpenVLA-OFT の成功率が 22.8% から 43.1% に上がったと報告しています。以下の数字はすべて著者の報告 [R] で、本サイトでは再現していません。閉ループの成功率はすべてシミュレーションによるものです。
問題:リモート方策の上りリンク
論文のシステムモデルでは、方策は k 制御ステップごとに動作チャンクを返します。OpenVLA-OFT は k = 8、制御周波数 20 Hz なので、0.4 s に 1 回の問い合わせになります。問い合わせのたびに、ロボットはパケットを 1 つ送ります。中身は可逆符号化した固有受容・関節の状態と、カメラごとに 1 フレームの符号化画像です。そのフレームを復号する前に、受信側はすでに、これまでに復号した画像、すべての関節状態、自分が生成した動作、ロボットモデル(運動連鎖とリンクのメッシュ。セッションごとに 1 回共有)、カメラキャリブレーション(内部パラメータ、外部パラメータ、ハンドアイ変換)を持っています。著者が挙げる低帯域の例は、携帯網や衛星回線を使う屋外ロボット、1 つのアクセスポイントを共有するロボット群、水中プラットフォームで、ロボット 1 台あたりの上りは数 kbps だとしています。これは想定する用途の説明であり、測定値ではありません。
フィジカルAIラボ 2.6:エッジへでは、モデルをロボットに載せてクラウドとの往復を避ける理由を扱いました。この論文はもう一方の選択肢を取ります。モデルはサーバーに置いたまま、上りリンクをできるだけ絞るという方法です。どちらも同じ予算に向き合っています。観測を撮ってから方策が使うまでに、どれだけ時間がかかるかです。
仕組み:運動学から両端で同じ参照画像をつくる
前回と今回の問い合わせ時の関節角があれば、順運動学で各リンク、エンドエフェクタ、手首カメラの姿勢が求まります。フィジカルAIラボ 1.1で見たように、順運動学の答えは 1 つです。ここではそれが重要です。送信側と受信側が同じデータで同じ決定的な生成器を動かせば同じ結果になるので、この「運動学コンテキスト」自体はビットを使いません。追加で送るのは固有受容に含まれない 7 個の関節角だけで、著者はこれらのバイトもすべてレートに計上したとしています。
KHC は前フレームの復号結果を運動学で変形し、J = D + 5 枚の参照画像(D = 32 なら 37 枚)を、それぞれ有効マスク付きでつくります。
- 恒等:カメラと一緒に動く内容(手首視点のグリッパー)、または固定カメラの静止シーン。
- 平面スイープ(D 枚):逆深度 1/3〜12.5 m⁻¹(3 m〜8 cm に相当)に等間隔で D 枚のカメラに平行な平面を置き、それぞれのホモグラフィで動くカメラの自己運動を説明します。論文は、カメラの動きがわかれば、静止した各画素の動きに残る自由度は逆深度の 1 つだけであることを示しています。
- ロボット層:両端でロボットだけをレンダリングし、ロボットの各画素をそれが属するリンクに合わせて動かします。レンダリング深度が 5% + 1 cm を超えて食い違う画素は自己遮蔽とみなし、無効にします。
- エンドエフェクタ平面:エンドエフェクタと一緒に動く平面で、つかんだ物体を運びます。
- 背景メモリ:固定カメラでは、アームに隠れる前の背景を受信側が保持し、アームがどいても再送せずに済みます。
- 補助スロット:対照実験でのみ使います。
融合ネットワークがこれらの参照画像を 3 つのスケールのコンテキストに変換し、DCVC 型の条件付きコーデックの分析変換、エントロピーモデル、合成変換を条件付けます。ベースラインの HIST は同じネットワークを使い、すべてのスロットを前フレームの復号画像で埋めるだけです。どちらも 7.0M パラメータです。レートが非常に低いときは、送信側が 2 バイトのスロット番号だけを送り(kinematic SKIP)、受信側がその参照画像を表示することもできます。HIST の SKIP は前フレームを繰り返すことしかできませんが、KHC の SKIP はロボットの現在の姿勢での画像を表示します。
なぜ姿勢ベクトルをそのままコーデックに入れないのでしょうか。論文の命題 2 によれば、受容野が限られた同位置の予測器は、どんな大域ベクトルを加えても、変位が受容野を超えるとこの情報を使えません。運動学の知識は画素の移動に変換する必要があります。実験の GVEC 対照(カメラとエンドエフェクタの相対運動を 24 次元ベクトルとして全体に与える)は、まさにこの点を確かめるものです。
符号化の結果:節約したビットはロボット自身の動きの分
LIBERO の 4 つのホールドアウトのスイートから取った 200 件のテストエピソード(256 × 256、三人称カメラと手首カメラの 2 系統)で、著者は次のように報告しています。
- 同じ PSNR で、KHC は同容量の HIST よりビットレートが 23.9% 少なくて済みます(95% 区間 −25.0%〜−22.8%)。三人称カメラでは 37.9%、手首カメラでは 12.3% の削減です。
- 対照:別エピソードの運動学を与える SHUF は HIST に対して +1.2%、2 枚目の参照フレームを加える HIST2 は +2.9%、GVEC は −0.6%(区間がゼロを含む)にとどまります。著者はここから、効果は容量や追加の時間コンテキストではなく運動学そのものから来ていると結論づけています。
- 同じ低遅延構成の x264、x265、SVT-AV1 に対しては、それぞれ 54.9〜55.8%、49.0〜49.1%、39.7% の削減です。
- リアルタイムのニューラルコーデック DCVC-RT に対しては、PSNR では KHC のほうがまだ 7.5% 多くのビットを必要とします(区間 −0.5%〜16.4%、有意差なし)。「動作の偏差」で見ると、同じ偏差で 23.2% 少なくて済みます。動作の偏差とは、OpenVLA-OFT が復号画像と元画像からそれぞれ出力する 8 × 7 の動作チャンクの L1 距離で、開ループの指標です。
- VVC の参照エンコーダ VTM-23 は全レート範囲でなお少ないビットで済みます(4:2:0 で KHC が 29.0%、4:4:4 で 42.1% 多い)。ただしこれはオフラインのエンコーダで、論文は DCVC-RT の論文を引いて、低遅延構成では約 0.01 フレーム/秒だとしています。KHC は 1 フレームを 26.7 ms で符号化します。閉ループで実際に使う低レート域では、両者は LPIPS と動作の偏差でほぼ同等で、PSNR では VTM-23 がリードを保っています。
閉ループ:成功率の「崖」と事前に決めた予算
閉ループでは公式の OpenVLA-OFT チェックポイントを変更せずに使います。方策の問い合わせのたびに、上りリンクが 2 系統のカメラ画像を復号画像に置き換え、8 次元の固有受容は可逆で渡します。各構成で 4 スイート × 10 タスク × 40 初期状態 = 1,600 エピソードを同じシードで実行し、(スイート、タスク、初期状態)で対応をとります。圧縮しない場合の成功率は 96.9% です。
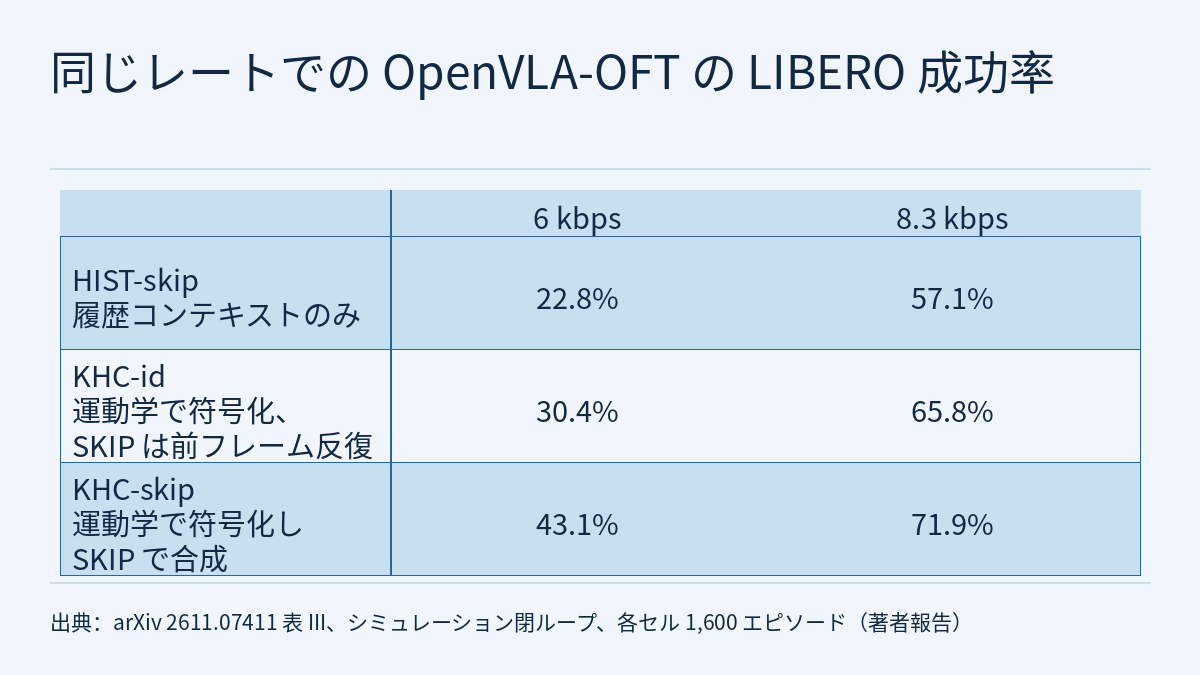
予算の決め方は参考になります。予備実験では、HIST は自身の最も低いネイティブのレート点 9.5 kbps でも成功率 88.5% を保ちました。方策がコーデックの通常の範囲全体で飽和しており、差が表れません。論文の命題 4 は、符号化の効果がタスクの効果に変わる割合は成功率曲線の傾きに比例すると述べています。そこで著者はまず HIST-skip の成功率曲線を描き、事前に書いた規則に従って、曲線が下限から非圧縮の水準まで 30%、60%、85% 上がった位置に予算を置きました。これが 6.0、8.3、10.7 kbps で、主実験とは重ならない初期状態で計算しています。下の表は論文の表 III から取りました(原表は小数第 2 位まで。ここでは第 1 位に四捨五入)。
| 上りリンク | 6 kbps | 8.3 kbps | 10.7 kbps |
|---|---|---|---|
| HIST-skip(履歴コンテキストのみ) | 22.8% | 57.1% | 85.2% |
| KHC-id(運動学で符号化、SKIP は前フレームの反復のみ) | 30.4% | 65.8% | 88.1% |
| KHC-skip(運動学で符号化し、SKIP で合成) | 43.1% | 71.9% | 88.5% |
| x265 CBR(実測レートが予算を超過) | 32.4%(9.85 kbps) | 63.8%(12.35 kbps) | 79.5%(15.74 kbps) |
KHC-skip と HIST-skip の実測レートは同じです(6 kbps の予算で 6.07 対 5.98 kbps。KHC が追加で送る関節角を含む)。3 つの予算での差は 20.4、14.8、3.3 ポイントで、いずれも Holm 補正後に有意と報告されています(正確 McNemar 検定。成功率には Wilson の 95% 区間)。中段の行は効果を 2 つに分けています。符号化コンテキストを替えるだけで 7.6、8.7、2.9 ポイント増え、SKIP で運動学の参照画像を表示できるようにすると、6 kbps と 8.3 kbps でさらに 12.8 ポイントと 6.1 ポイント増えます。スキップの少ない 10.7 kbps では、この部分の寄与はありません。6 kbps ではフレームのほぼ半分がスキップされます(スキップ率 0.46)。このとき HIST の受信側は最大で数回前の問い合わせ時点のアームを表示し、KHC の受信側は今のアームの位置を表示します。x265 のレート制御はこれらの予算まで下げられず、47〜64% 多くのビットを使っても KHC より成功率が低くなります。
対応のある比較はフィジカルAIラボ 1.8で、Wilson 区間はフィジカルAIラボ 2.8で練習しました。この論文はさらに、多重比較を Holm 補正で扱っています。これらの手法をシステム論文で使った例です。まず曲線のうち差が出る区間を見つけ、規則に従ってそこに予算を置き、すべての構成を同じ初期状態で対応づけています。
より強い比較:見出しの数字の外側
アブストラクトの「ほぼ 2 倍」は、同容量の HIST との比較です。論文の拡張実験(初期状態 0〜19、構成ごとに 800 件の対応エピソード、13 件の検定を 1 つの Holm ファミリーとして扱う)は、より広い比較を示しています。
- DCVC-RT を同じ SKIP・レート制御器に入れると、8.3 kbps では KHC-skip が 72.4% 対 66.6%(著者はタスクによって差が変わるとしています)、10.7 kbps では 88.9% 対 69.4% です。6 kbps では DCVC-RT が 49.0% で、KHC-skip の 43.6% を上回ります(有意差なし)。著者は、DCVC-RT が学習したレート範囲のほうが低く、フレームのスキップが 6% で済むのに対し、KHC は 45% をスキップするためだと説明しています。
- 6 kbps で、HIST で 128 × 128 の画像を符号化してバイキュービックで拡大すると 53.1% で、これも KHC-skip の 43.6% を上回ります。送信頻度を半分にすると 47.9%(有意差なし)です。
- x265 にフレームのスキップで予算を守らせると、成功率は 0.0%、0.3%、4.0% にとどまります。
- 8.3 kbps で 10% のパケットをランダムに落とすと、KHC-skip は 46.4%、HIST-skip は 22.9% です。
- KHC と HIST を同じ手順で低レート向けに追加学習すると(KHC-LR、HIST-LR)、KHC-LR-skip は 6 kbps で 72.6% に達し、HIST-LR と同じ制御器での DCVC-RT(どちらも 49.0%)を 23.6 ポイント上回ります。ただし 8.3 kbps と 10.7 kbps では、HIST-LR に対するリードは 5.8 ポイントと 3.3 ポイントに縮みます。低レート学習そのものが履歴コーデックも大きく引き上げています。
- 2 つ目の方策 π0.5(5 制御ステップごと、4 Hz で問い合わせ)は、同じ規則で自身の予算 10.0、13.4、16.9 kbps を得ています。中間の予算で、KHC-skip は成功率を 55.5% から 77.4% に上げました(+21.9 ポイント、区間 12.0〜32.6)。実測レートは 12.79 対 12.76 kbps です。
これらの数字は比較の相手ごとに読む必要があります。同容量の HIST に対しては、どの予算でも効果があります。同じ制御器での DCVC-RT と 128 × 128 の方式に対しては、元の KHC は最も低い予算で常に勝つわけではなく、低レート向けに再学習した KHC-LR は 3 つの予算すべてで上回ります。論文は KHC-LR を半分の頻度での画像送信とは比較していません。著者は、解像度や送信頻度を下げる方法は KHC の上に重ねられるとも述べています。
運用の条件:同期、キャリブレーション、計時
- 状態と画像の同期が必要です。状態と画像が 1 フレームずれると参照画像がかえって誤りを招き、レートは HIST より 43.8% 増えます。フィルタをかけない姿勢のジッタは効果を消します(+3.7%)。著者は、ハードウェアトリガのカメラと標準的な状態推定器でこの同期を確保できると見ています。
- キャリブレーション誤差の影響は 2 次です。両端で同じ誤ったハンドアイ較正を使う場合、1°/5 mm、2°/10 mm、5°/20 mm の誤差でも、ビット削減の 99%、97%、91% が残ります。
- 実データはオフラインの符号化だけです。DROID の学習に使っていない(ホールドアウトの)研究室から取った 30 件のテストエピソードで、自己較正した手首カメラは 11.2%、3 系統のカメラ全体では 4.7% 削減します。外部パラメータのない 2 台の外部カメラは、設計どおり HIST に戻ります。論文は実機での閉ループを行っていません。
- 計時は RTX 4090 で測定しています。P フレームの符号化は 26.7 ms、復号は 17.0 ms(HIST は 23.4 ms と 13.2 ms)、ロボットだけのレンダリングは両端でカメラ 1 台あたり 1.95 ms、ピークメモリは 277 MB です。著者は、55〜227 kbps より遅いリンクでは、ビットが減ることで短縮される伝送時間が追加の計算時間を上回り、6〜11 kbps では同じ PSNR で各観測が 90〜400 ms 早く届くと見積もっています。本サイトが読んだ本文には、ロボット側の組み込みハードウェアでの符号化時間は書かれていません。
- 平面の数は少なくて済みます。アブレーション(すべて 100k ステップ学習)では、D = 4 が HIST に対して 12.6% 削減し、D = 32 に劣りません。著者は運用時には 4 枚の平面を推奨しています。ロボット層を外すとレートが 26.4% 増え、これが最も大きな寄与です。
- 通信のセキュリティは別途対応が必要です。論文が説明するパケットには、ステップカウンタ、可逆符号化した関節状態、各カメラのサブストリームが入り、セッションの識別情報は接続時に 1 回交換されます。本サイトが読んだ本文は、リンクの暗号化や認証には触れていません。関節状態とカメラ画像がこのリンクを通るため、実際の運用ではトランスポート層の暗号化と相互認証を別に加えるべきです。
制約と注意点
- 単著の arXiv プレプリントです。数字はすべて著者の報告 [R] で、本サイトでは再現していません。「事前登録したプロトコル」は著者の説明で、本サイトが読んだ本文には登録記録へのリンクがありません。
- 閉ループ実験はすべて LIBERO のシミュレーション(robosuite 経由で MuJoCo により再レンダリング)で、方策は 2 つだけです。実データは DROID でのオフライン圧縮だけで、実機での閉ループはありません。アブストラクトの「実ロボットのデータへの移行」はこのことを指します。
- 6 kbps では、元の KHC-skip は同じ制御器での DCVC-RT と 128 × 128 の方式を下回ります(前者は有意差なし)。「ほぼ 2 倍」は同容量の HIST との比較です。
- 著者が挙げる制約:状態と画像の同期に依存すること。外部パラメータのない外部カメラは現状 HIST に戻ること。変形する物体、液体、作業空間内の人はどの参照画像でも説明できないこと(平面スイープの代わりにレンダリングしたシーン深度を使う上限では、さらに 18.3% 削減できる)。PSNR では中〜高レート域で VTM-23 にまだ及ばないこと。
- 「数 kbps の上り」は論文が想定する用途で、特定の種類のリンクを測ったものではありません。本サイトが読んだ本文は結論の節で終わっており、補足資料は読んでいません。
- 結果はすべて符号化とシミュレーションのタスク指標で、ハードウェアの安全性検証ではありません。スキップ中に方策が見るのは合成画像なので、実機では独立した安全層が別に必要です。
リンク
- Kinematic Hypothesis Context: Embodiment-Conditioned Learned Video Coding for Bandwidth-Limited Robot Policy Uplinks(arXiv 2611.07411)
- 論文の HTML 全文
- フィジカルAIラボ 2.6:エッジへ――遅延のログから制御周波数の上限を求め、量子化で減るのが容量か時間かを見分け、動作チャンクの長さを決める
- フィジカルAIラボ 1.1:座標系と運動学――2 リンクのアームがコップに届く計算を手で追う
- フィジカルAIラボ 1.8:評価――「差し引き +2」を対応表に分解し、失敗ラベルと乱数シードを計算で確かめる
- フィジカルAIラボ 2.8:再現できる評価――Wald 区間と Wilson 区間を手で計算し、1/√n から評価回数を決め、失敗ゼロのあとの失敗率の上限を求める
- フロンティア・レーダー特集|エッジとリアルタイム性:VLA と世界行動モデルのレイテンシ予算はどこに使われているか


