用大模型自动生成任务规划的微调数据,一个常见问题是生成的题目本身无解:场景图里漏了关键物体或属性,任务目标与环境对不上,PDDL 规划器求不出解,这条样本通常就被丢掉。中国科学院自动化研究所与中国科学院大学人工智能学院的作者在预印本 SCOPE(arXiv 2610.31518,2026-10-22)中换了一种处理:把规划器的失败当作诊断信号,反推出缺失的前提,补进场景图后重新规划,直到得到可执行的计划。作者报告,用 SCOPE 生成的 1 万条数据对 Qwen2.5-7B-Instruct 做 LoRA 微调,在 AI2-THOR 场景图上的总体成功率为 63.00%,用 DELTA 生成的同量数据微调为 50.67%,相差 12.33 个百分点。本文重点读这个“失败即修补”的环节是怎么做的,以及两组实验各自能说明什么、不能说明什么。以下数字均为作者报告 [R],本站未复现。
问题:自动生成的规划数据为什么会“无解”
论文把一条任务与运动规划(TAMP)微调样本拆成三部分:描述环境状态的场景图、定义任务目标的指令、作为解的计划。人工标注质量高但成本高,难以扩到微调需要的规模;用大模型直接合成成本低,作者认为质量问题主要有两个。一是同质化:受模型偏好影响,生成的场景图高度重复,数据集信息熵不足,限制了泛化。二是无解:受幻觉影响,场景图常有逻辑缺陷,例如缺少关键的可交互物体或属性错误,使任务在物理上无解,给训练数据带来大量噪声。作者指出,已有基于 PDDL 规划器的数据管线逻辑一致性更好,但场景图结构简单、缺乏多样性,而且也不能保证可解。
生成流程:场景、指令、计划三步
场景图。为了对抗模型偏爱高频房间类型的倾向,SCOPE 统计历史生成中每种房间类型的累计使用频率,算出经验分布 p̂_t(r_i),再按 P_t(r_i) ∝ exp(−α · p̂_t(r_i)) 调整下一次的选取概率,α 经验取 3.0:某类房间生成得越多,下次被选中的概率越低。同一房间类型内,每次从资产库中随机抽 5–10 件家具和 20–30 个物体放进提示词,避免模型总用同一批常见物品。场景图不让模型一步输出,而是写成一种轻量 DSL 指令流,由粗到细:AddRoom 与 SetAgent 定房间和智能体初始状态,AddFurn 放大件家具,PlaceObj 把物体放到家具内部或外部。作者说一步输出完整场景图常出现物体没有支撑家具、包含关系不一致等结构错误。
指令。模型按“目标采样 → 动作链构建 → 指令语言化”的思维链顺序,从线性化的场景图中挑出可交互的物体,构造一条到达目标状态的因果动作链,再写成自然语言指令;按用户意图表达得多明确,分为 simple、complex、vague 三档。后处理用集合匹配检查指令里的目标物体和位置是否都在场景实体中,不在的任务直接丢弃。
计划。SCOPE 把机器人的底层操作能力封装为 9 个高层原子动作:place_on、place_in、open、close、power_on、power_off、fill、pour、slice。场景图被解析为初始 PDDL 状态,指令由大模型逐步分解为动作序列并映射为子目标,再与 DELTA 的自回归方式类似,逐个子目标交给经典启发式搜索规划器求解。所读正文没有写明场景图和指令由哪个大模型生成。
关键一步:把规划失败变成修补信号
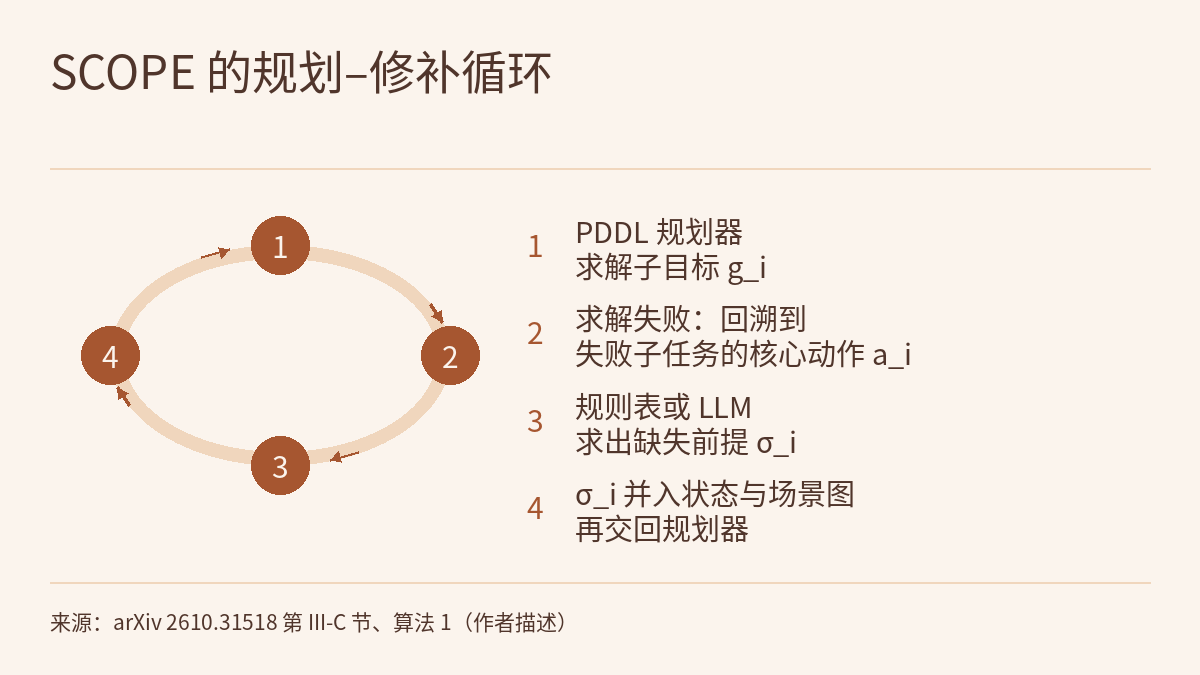
子目标求解失败时,SCOPE 不丢弃样本,而是回溯到失败子任务的核心动作 a_i,求出导致失败的状态缺口 σ_i = f(a_i | s_i),即在当前状态下执行该动作所需、但场景图里缺失的静态属性或初始状态;再把 σ_i 同时并入当前状态和场景图(s_new = s_old ∪ σ_i,SG_new = SG_old ∪ σ_i),交回规划器重新求解。求 σ_i 的函数 f 分两层:第一层是预先定义的“动作–前提”映射表,作者举的例子是 power_on 规划失败时给物体补上 “powerable” 属性;映射表里没有的长尾动作,则把受限的物体状态和失败动作一起交给大模型推断需要补的属性和初始状态。所有子目标都得到合法子计划后,拼接成完整计划 Π,与修补后的场景图和指令组成一条训练样本 ⟨SG_final, I, Π⟩。
这里有一个读法上的要点:修补改的是场景,不是计划。对于数据生成,这是合理的,因为场景本来就是合成的,让场景与任务一致正是目的。但它意味着 SCOPE 最终保留的是“被改到可解的题目”,而不是原来那道题的解。论文算法 1 中的修补循环为 while π_i = Failure(π_i 失败时持续修补),所读正文没有给出迭代上限、修补触发的比例、修补失败时如何处理,也没有检查补上的属性在常识上是否合理。
两组实验各测什么
作者自建了两个评测集,各含 100 张场景图和 300 条指令,分 simple、complex、vague 三档难度。评测先用 PDDLGym 与 VAL 工具链检查动作序列能否执行,再由 LLM-as-a-Judge 按 0–4 分打分。三个指标:可执行率 EX 只看环境动作执行成功的比例,不管与任务是否相关;平均质量分 AQS 是 0–4 分的均值;成功率 SR 只把满分 4 分的任务算作成功。所读正文没有写明担任评委的模型。
| 实验 | 场景图来源 | 比较的是什么 | 总体结果(SR / EX / AQS) |
|---|---|---|---|
| 表 I:带噪场景图上的规划 | 大模型生成,含逻辑幻觉与属性缺失(LLM-Synthetic Noisy Dataset) | 各方法直接对同一批带噪场景图和指令做规划,不涉及微调 | SCOPE 70.67% / 92.67% / 3.28;DELTA 46.33% / 67.00% / 2.25;LLM+P 41.67% / 48.00% / 1.76;LLM-As-Planner 27.00% / 29.67% / 1.84;LLMGenPlan 23.00% / 61.33% / 1.24 |
| 表 II:用不同数据微调后的模型 | 直接从 AI2-THOR 模拟器状态提取,无逻辑缺陷(AI2-THOR Grounded Dataset) | 同一基座 Qwen2.5-7B-Instruct,用各方法生成的 10,000 条三元组、相同 LoRA 设置微调,再评测微调后的模型 | SCOPE(多样性+纠错)63.00% / 85.33% / 3.08;DELTA 数据 50.67% / 77.67% / 2.67;LLM-As-Planner 数据 25.00% / 26.00% / 1.57 |
表 I 中,DELTA 和 LLM+P 把规划交给 PDDL 求解器,作者认为它们的弱点是完全依赖初始状态:场景图缺前提时求解器直接无解或超时。SCOPE 在 complex 档成功率 55.00%,DELTA 为 31.00%;vague 档 71.00% 对 39.00%。LLMGenPlan 加入重试后可执行率升到 61.33%,成功率只有 23.00%,作者的解释是文本层面的反馈只滤掉无效动作表达,修不了场景图里的逻辑错误。
读数时的几处细节
- 表 I 比的不完全是同一道题。SCOPE 在规划过程中会修改输入的场景图,其他方法则必须接受原图。所读正文没有说明表 I 的可执行性检查是对原始带噪场景图还是修补后的场景图进行的。在数据生成中“改场景使其可解”是目的;但若把这组结果读成“部署时对感知错误更鲁棒”,就需要另外的证据:真实场景里缺一个属性,可能是感知漏了,也可能是物体真的不具备这种能力,补上属性只能让计划在符号层面可执行。
- 12.33 是百分点,约合 37 条指令。63.00% 与 50.67% 都以 300 条指令为分母,对应 189 条与 152 条成功(本站换算)。所读正文没有报告置信区间、重复次数或随机种子。
- 两个组件的消融。只用常规场景、只加纠错时,总体成功率 58.00%,complex 档 41.00%(DELTA 数据为 28.00%);只加多样性、不纠错时为 59.67%,complex 档 40.00%;两者都用为 63.00%,complex 档 50.00%。但完整配置并非每列最高:其可执行率 85.33% 低于只加多样性时的 87.00%,vague 档成功率 51.00% 也略低于 52.00%。simple 档各 SCOPE 配置在 86.00%–88.00% 之间,差别很小。
- 表 II 的一处标注不一致。正文写“DELTA 的成功率从 50.67% 提高到 59.67%”,而表中 59.67% 那一行标为“SCOPE,多样性 ✓、纠错 ✗”。按正文的说法,这一行似乎是在多样化场景上用 DELTA 式规划生成的数据,但所读文本没有明说,读者无法确定这一行的数据是怎样生成的。
- 失败分析。作者把微调模型的 111 个失败案例分为两类:认知类约占六成,包括漏掉指令要求 33 例、逻辑与语义错误 34 例;落地类包括物理限制 23 例(例如违反环境物理)和感知幻觉 21 例(例如与不存在的物体交互)。四类合计 111,正好是 300 条中 63.00% 成功后剩下的条数(本站核算)。也就是说,即使测试场景图无逻辑缺陷,微调后的模型仍有 21 例感知幻觉失败,论文为这一类举的例子是与不存在的物体交互。
和本站其他内容的关系
SCOPE 处在 物理AI实验室 0.3:看-想-动 所说“想”里较慢的那一层,输出的是高层动作序列,不是关节指令。最近两篇雷达也在处理动作前提,但用在不同环节:前沿雷达|SLoSa 用形式化验证器的分级结果作奖励,直接训练规划器;前沿雷达|CausGround 从交互轨迹归纳前提与效果,交给参数冻结的规划器。SCOPE 不在推理时帮规划器,而是用规划器的失败去修数据,再用数据微调模型,三者的任务、环境和指标各不相同,数字不能互比。关于合成数据作为机器人数据来源之一,可对照 物理AI实验室 1.5:数据从哪来;EX 与 SR 的差距、在 300 条指令上、未报告重复次数的评测的波动,以及“一个失败标签盖住几种失败”的问题,可对照 物理AI实验室 1.8:评测 的方法。
局限 / 注意
- 这是 arXiv 预印本,全部数字为作者报告 [R],本站没有复现。所读文本没有置信区间、重复次数或随机种子。
- 两个评测集都是作者自建的,各 300 条指令;SR 与 AQS 依赖 LLM 评委打分,所读正文没有写明评委模型,也没有报告评委与人工判断的一致性。
- 全部实验在符号规划与 AI2-THOR 模拟中完成;图 3 是模拟器中执行的定性截图。没有真机实验,这不是硬件安全验证。
- 修补循环的迭代上限、触发频率、修补失败的处理方式,以及补上属性的合理性检查,所读正文均未给出;生成场景图和指令所用的大模型也未写明。
- 表 II 中 59.67% 一行的标注与正文描述不一致,见上文。
- 论文给出的项目页地址是 scope-page.github.io,称有更多演示和信息;所读文本没有说明代码或数据集是否发布。本站撰写时未打开该页核实其内容。
- “约 37 条”“189 条与 152 条”“四类合计 111”是本站按 300 条分母做的换算与核对。
链接
- SCOPE: Scene-graph Construction Optimized by Plan Error-correction for Robot Long-term Planning Datasets(arXiv 2610.31518)
- 论文 HTML 全文
- 物理AI实验室 0.3:看-想-动,把三个频率放回各自的系统
- 物理AI实验室 1.5:数据从哪来,从 SO-101 元数据算出示范时长,再分清三条来路的单位与动作空间
- 物理AI实验室 1.8:评测,把“净增 2”拆成配对表,再给失败标签和随机种子算一笔账
- 前沿雷达|SLoSa:形式化验证器按固定顺序给计划分五类并定奖励区间,4B–14B 任务规划器在 Jetson Orin 上以 INT4 本地运行
- 前沿雷达|CausGround:从交互轨迹归纳每个动作的前置条件与效果,不改参数,帮冻结的多模态规划器补上“先开门再放入”这一步
- 物理AI实验室:一套每个数字都能核对的物理 AI 课程(课程大纲)