動作条件付きの動画世界モデルを実機の代わりに使って方策を評価・事後学習するには、モデルが予測する結果が信頼できなければなりません。中国科学院自動化研究所、Anyverse Robotics、Open-Phoenix Team、シンガポール国立大学、西安交通大学、北京理工大学の著者らはプレプリント PhysCanvas(arXiv 2610.28613、2026-10-20)で、もっともらしい画面が正しい接触を意味するわけではないと指摘しています。物体がすでに滑り落ちているのに、モデルが安定した触覚接触または最終的な成功を予測すれば、そのロールアウトは方策の評価も最適化も誤らせます。PhysCanvas は多視点 RGB、触覚画像、触覚マーカーの変位、タスク状態を 1 枚の画像「キャンバス」に並べ、共有の動画 VAE と事前学習済み生成バックボーンで予測し、さらに凍結した 3 つの報酬モデルでシーンの保持、視覚と触覚の整合性、タスクの成否を制約します。著者らの報告では、実機の双腕タスク 4 つで、タスク状態の監督を加えると、世界モデル内での方策の成功率と実機での成功率のタスク別 Pearson 相関の平均が 0.602 から 0.885 に上がり、報酬で制約した世界モデル内で GRPO による事後学習を行うと、π0.5 の実機平均成功率が SFT の 59.1% から 70.8% に上がりました。以下の数値はすべて著者報告 [R] で、本サイトでは再現していません。
問題:見た目はもっともらしくても、接触と成否が正しいとは限らない
論文は既存手法に 2 つの欠落があるとみています。第一に、既存の視触覚世界モデルは通常、専用の触覚エンコーダと、触覚特徴を汎用バックボーンに注入する独自のインターフェースを必要とし、新しい触覚データやセンサー構成に対応するには再学習が必要になりかねません。第二に、トークン単位の再構成による監督は局所的な忠実度を重視し、タスクが成功したかどうかといった高次の意味を見落とすことがあります。そこで著者らは 2 つの問いを立てます。異種のモダリティを単純で汎用的な仕組みで 1 つの空間に符号化できるか。追加のネットワークなしに高次の意味を世界モデルに組み込めるか、です。
触覚を別にモデル化する必要がある理由は、フィジカルAIラボ 1.3:センサーで扱いました。柔らかいゲルパッドの裏に小さなカメラを仕込んだ光学式触覚センサーは、物体が滑っているか、表面がどれだけ粗いかを読み取れます。フィジカルAIラボ 1.4:シミュレータの地図では、物理シミュレータで最も計算が難しいのは接触の瞬間だと説明しました。PhysCanvas は別の道をとります。接触モデルを書く代わりに、動画生成モデルに触覚画像を直接予測させ、それが RGB やタスクの結果と矛盾しないかを確かめます。
1 枚のキャンバス:4 種類の観測が 1 つの動画 VAE を共有し、動作も画像として描く
著者らはまず 1 つの前提を検証します。大規模な画像・動画で事前学習した視覚 VAE は、光学式触覚画像をそのまま符号化できるのか、です。UniT とともに公開された USB 3D-pose 触覚データセットで、触覚向けの微調整をしていない Wan VAE は PSNR 35.51、LPIPS 0.0139 で、触覚専用の UniT VAE は 31.72 と 0.0210 でした。SSIM では UniT のほうが高くなっています(0.9613 対 0.9539)。著者らはこれを視覚表現が光学式触覚に転用できる根拠とみなし、Wan の画像から動画を生成するモデルを採用しました。
キャンバスの並べ方は付録に書かれています。
- RGB:固定のベース視点 1 つと手首視点 2 つを、それぞれ 224 × 224 に切り出して縮小し、横に並べて 224 × 672 の帯にします。記録は 10 Hz です。
- 触覚画像:Xense 内部カメラが記録した、センサー基準に対する差分画像(400 × 700 × 3)をそのままキャンバスに入れます。
- マーカー変位:触覚パッド 1 枚につき 35 × 20、計 700 個のマーカーについて、エピソードの最初のフレームを基準とする 3 次元のずれを求めます。各成分を [−s, s](s = 0.06、キャッシュ固有の単位で、物理的な上限ではなく符号化のスケール)に切り詰めて正規化し、x・y・z をそれぞれ R・G・B に割り当てます。定量的な統計は符号化前の変位から計算します。
- タスク状態:色でタスクを、模様(縦または横の低周波の縞)で「成功条件を満たしていない/満たしている」を区別します。これは世界モデルにタスクの意味を教えるための補助目標にすぎず、下流の方策は予測された状態を使いません。
カメラ視点は横に、モダリティは縦に積み重ね、キャンバス全体を 1 つの VAE と Wan 2.2 の拡散 Transformer に通すので、すべてのモダリティが時空間の自己注意を共有します。動作条件は双腕の目標関節構成(グリッパー状態を含む)です。著者らは iMaC にならい、関節構成をロボットの URDF に当てはめて順運動学を計算し、カメラの内部・外部パラメータで各視点に投影して、観測と空間的に揃った「動作画像」を作ります。これを同じ VAE で符号化し、ノイズを加えたキャンバスのトークンに位置ごとに足し込みます。ただしタスク状態の領域には足さず、状態の予測が自己注意を通じて他のモダリティを参照するようにしています。生成時には、エピソード冒頭の RGB フレームが固定のアンカーとしてクロスアテンションで入り、現在の参照トークンは直前のチャンクの最後のフレームで更新されます。
学習の詳細:Wan2.2-TI2V-5B(50 億パラメータ)から初期化し、VAE を凍結して Transformer をフローマッチングの目的関数で微調整します。各学習サンプルは 8 フレームずつ 4 チャンクを再帰的に生成し、損失を 4 チャンクで平均するので、モデルは自分が生成した文脈の上で学習します。学習には 64 基の PPU-ZW810E アクセラレータで 300 エポック、約 3 日かかりました。推論では各チャンクをノイズから 5 ステップでデノイズして 8 フレームを生成し、エピソードの終わりまで続けて生成できます。
凍結した 3 つの報酬モデルが、それぞれ 1 種類の整合性を受け持つ
3 つの報酬モデルはいずれも ResNet-18 エンコーダに MLP または Transformer のデコーダを組み合わせたもので、あらかじめ学習し、世界モデルを事後学習する間は凍結しておきます。
- Scene Reward Model:エピソード冒頭の RGB と将来の RGB フレーム 1 枚を入力とし、シーンの同一性と物体が保たれているかを判定します。正例は実際の観測とシーンが整合した生成結果、負例はシーンが整合しない生成結果で、クラスを均衡させています。
- State Reward Model:将来の RGB フレーム 1 枚を入力とし、タスクの成功条件が成り立っているかを判定します。学習には実機の軌道だけを使い、完了前のフレームを 0、完了以降のフレームを 1 とします。
- Modality Reward Model:対になった RGB、触覚画像、マーカー変位の領域を入力とし、接触の手がかりが互いに矛盾しないかを判定します。負例は RGB を固定したまま触覚を別の触覚状態に差し替えて作るので、監督しているのは接触の有無ではなく、モダリティ間の整合性です。
状態の監督は、すべての予測を成功に寄せるものではありません。目標ラベルは同じ State RM が対応する実フレームに付けたスコアを閾値で 2 値化したもので、生成フレームの成功ロジットをこれに対して 2 値交差エントロピーで学習します。したがって実際の軌道が失敗なら、生成も失敗になるべきです。シーンとモダリティについては、報酬モデルが付けるスコアを直接最大化します。勾配は凍結した報酬モデルと VAE デコーダを通って世界モデルに戻り、第 1 段階のフローマッチング損失も残します。
アブレーションの結果は、すべてが同じ方向に改善したわけではありません。シーン整合性を加えると RGB の LPIPS が 14.2%、FVD が 10.4% 下がりました。続いて状態の監督を加えると FID が 26.4%、FVD が 12.5% 下がりましたが、PSNR は 20.975 から 20.699 に下がり、LPIPS は 0.097 から 0.132 に上がっています。さらにモダリティ整合性を加えると接触 MAE が 0.02491 から 0.02278 に下がり、マーカー変位の 3 つの誤差もすべて下がりましたが、触覚イベントの F1 は 0.4550 から 0.4455 にわずかに下がりました。図 6・図 7 の「グリッパーを強制的に開くとブロックが落ち、触覚の反応が消える」といった例について、著者らは定性的な例示であり、接触精度の測定ではないと述べています。
EVAC、Open-Sora、WoVR との RGB の比較では、PhysCanvas が PSNR、SSIM、LPIPS、FID、FVD のすべてで最良で、エンドエフェクタの追跡誤差は 0.685 ピクセルと、次点のベースラインより 51.9% 低くなっています。VBench の Subject と Smooth ではわずかな差の優位にとどまり、背景の一貫性では WoVR のほうが高くなっています(91.082 対 90.565)。
評価器として:世界モデル内と実機の成功率の相関
プラットフォームは ARX AC One 双腕ロボットで、各アームに 6 関節とグリッパー、カメラ 3 台、指先に Xense 光学式触覚センサー 4 個を備えます。4 つのタスクはいずれも両腕の協調を必要とします。試験管を受け渡し、机との接触を使って手の中で向きを変えてからラックに差し込む。つながった 2 つのブロックを分け、それぞれ同じ色の袋に入れる。一方のグリッパーでボトルを支え、もう一方でキャップを外す。1 面だけ回して崩したルービックキューブを元に戻す。世界モデルの学習データは実機での方策ロールアウト 3,805 本(4 タスクでそれぞれ 1,000、1,000、926、879 本)で、タスク方策を確率的に実行して集めたため、つかみ損ね、早すぎる解放、不正確な受け渡し、位置ずれ、挿入や配置の未完了といった自然な失敗を含みます。各タスクにはさらに 80 本のテスト用ロールアウトを別に確保しています。
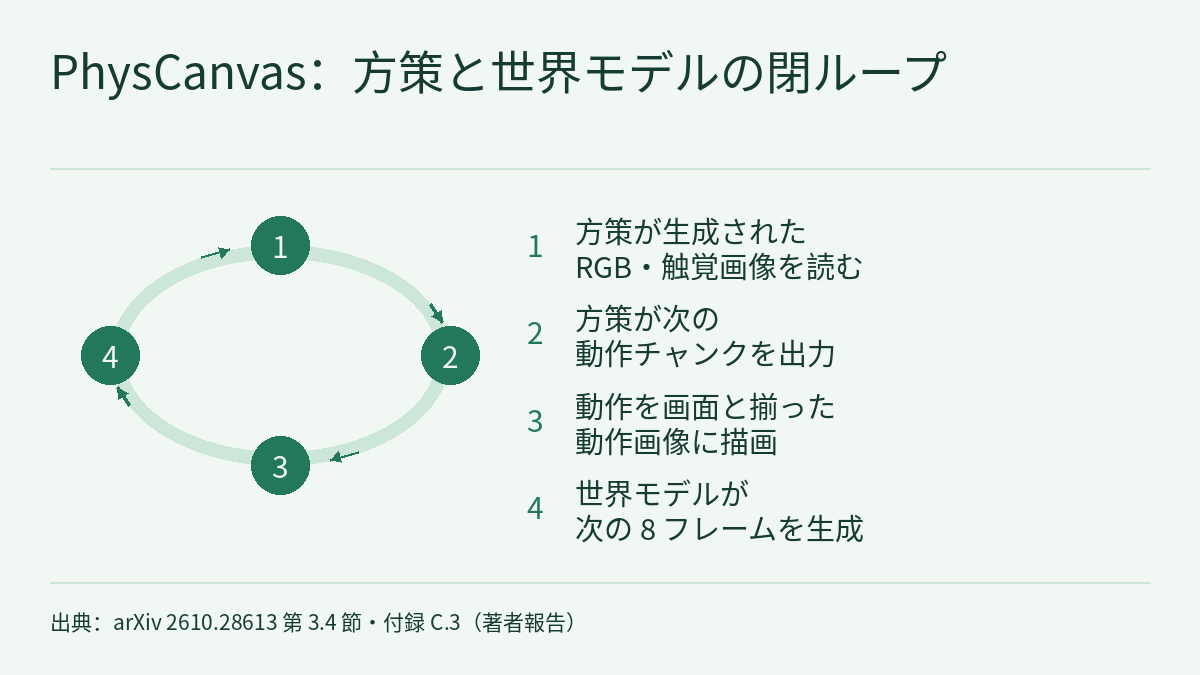
評価では、実際の初期観測から始めて、方策が世界モデルの生成した観測を読んで次の動作チャンクを出し、世界モデルが予測した視覚・触覚・タスク状態の結果を返す、という閉ループを回します。評価対象は ACT、フローマッチング方策(FM)、π0.5 で、いずれも RGB、ロボットの状態、触覚マーカーの変位を入力とします。各「タスク×方策」の組み合わせには 20 シーンずつのバッチが 3 つあり、3 つのバッチは異なる時期に収集されています。実機の各シーンが成功したかどうかは複数の人間の専門家が共同で判定します。したがって各タスクには 9 個のバッチ点(方策 3 種 × 3 バッチ)があり、各点で世界モデル内の成功率と実機の成功率を比べ、タスクごとに Pearson 相関を計算してから、4 タスクを等しい重みで平均します。
シーン整合性だけの ℳ2 から状態の監督を加えた ℳ3 にすると、相関の平均は 0.602 から 0.885 に、R² の平均は 0.413 から 0.791 に上がりました。向上が最も大きかったのは試験管とブロックで、ボトルは中程度、ルービックキューブはほとんど変わらず、著者らによればルービックキューブでは ℳ2 がすでに上限近くにありました。同じ変更で低レベルの再構成指標は上下さまざまに動いたため、著者らは評価の一致度の向上を、ピクセル再構成の改善ではなく、タスクの意味をよりよくモデル化できたことによるものとみています。
本サイトで以前取り上げた Token-World も、シミュレーション上の成功率と参照の成功率の相関係数で、世界モデルが評価器として使えるかを測っています。2 本の論文はタスク、方策、バッチの分け方、相関係数の計算方法がいずれも異なるため、0.885 をその論文の数値と直接比べることはできません。フロンティア・レーダー特集|シミュレーションと評価では「方策の観点から見たシミュレーションの忠実度」といった問題を整理しました。PhysCanvas は、実機と照らし合わせて確かめられる 1 つのやり方を示しています。また、各タスクの相関係数は 9 個の点だけに基づいている点にも注意が必要です(論文は各タスクに 9 つの評価バッチがあると述べています)。
学習の場として:GRPO 後の実機成功率
事後学習では、方策が実際の初期観測から出発して世界モデルの中で想像上の閉ループのやり取りを行い、凍結した State RM がタスクの結果を採点し、GRPO(グループ相対方策最適化)がそれらの結果の差を学習信号に変えます。世界モデルも報酬モデルも更新せず、更新するのは方策だけで、新しいロボット軌道は収集しません。事後学習の対象は FM と π0.5 です。ACT は、著者らの GRPO 実装が前提とする拡散やフローマッチングの定式化を使わないため除外されています。
ここでの比較が前節と異なる点に注意してください。「RL in WM」は空間的に揃えた動作の注入だけで整合性の監督を一切持たない ℳ1 をシミュレータとし、「RL in WM+RM」は 3 つの整合性の目的をすべて備えた ℳ4 を使います。どちらも採点には凍結した State RM を使います。実機の成功率は 3 回の実行の平均 ± 母標準偏差です。
| π0.5 | 試験管 | ボトル | ブロック | ルービックキューブ | 4 タスク平均 |
|---|---|---|---|---|---|
| SFT | 50.0 ± 7.0 | 88.3 ± 4.7 | 46.6 ± 2.3 | 51.6 ± 6.2 | 59.1 |
| RL in WM(ℳ1) | 60.0 ± 4.0 | 90.0 ± 0.0 | 56.6 ± 4.7 | 63.3 ± 4.7 | 67.5 |
| RL in WM+RM(ℳ4) | 60.0 ± 8.1 | 86.6 ± 2.3 | 63.3 ± 4.7 | 73.3 ± 4.7 | 70.8 |
FM の 4 タスク平均は 11.2% から 16.6%(ℳ1)、19.1%(ℳ4)に上がりましたが、向上はボトルとブロックだけで、試験管とルービックキューブは 0 のままでした。π0.5 では、ℳ4 が ℳ1 に上乗せした改善は主にブロックとルービックキューブ(6.6 ポイントと 10.0 ポイント。ブロックの 6.6 は著者らの数値で、表の数値の差は 6.7 です)で、ボトルは 90.0% から 86.6% に下がり、表の数値では SFT の 88.3% も下回っています(本サイトによる比較)。著者らの結論は、実機の平均成功率は上がったものの、効果はタスクによって異なる、というものです。
学習した報酬に対して生成された環境の中で方策を最適化する場合、フィジカルAIラボ 1.7:強化学習で扱った「報酬の抜け道」が注意すべきリスクになります。この論文では、最後に実機で評価することでそれを確かめています。フィジカルAIラボ 1.8:評価では、数ポイントの差が本当に意味を持つかを判断する練習をしました。表の差のいくつかは標準偏差と同程度の大きさで(たとえば試験管の 50.0 ± 7.0 対 60.0 ± 8.1)、読んだ本文には有意性の検定が報告されていません。
制約と注意点
- これは arXiv のプレプリントで、数値はすべて著者報告 [R] です。本サイトでは再現していません。本サイトが読んだ本文は付録 D.3(方策の構成)で終わっており、それ以降の付録は読んでいません。本文にはプロジェクトページのアドレスがありますが、コード、データ、重みが公開されているかは書かれておらず、本サイトはプロジェクトページを開いていません。
- 評価器としての結果(0.602→0.885)は ℳ2 と ℳ3 の比較で、事後学習の結果(59.1%→67.5%→70.8%)は ℳ1 と ℳ4 の比較です。2 組の数値は異なるモデルの変種から得られたもので、「整合性の監督がどれだけ効くか」という 1 つの結論にまとめることはできません。
- プラットフォームは双腕 1 機種、タスクは 4 つ、方策は 3 種類で、各タスクの相関係数は 9 個のバッチ点に基づいています。ボトルのタスクでは π0.5 の事後学習の結果が SFT を下回り、FM は 2 つのタスクで 0 のままです。
- State RM は世界モデルに状態の監督を与えるとともに、GRPO で方策の採点も行います。これは実機の軌道の RGB だけで学習した 2 値分類器で、読んだ本文にはその判定精度が単独では報告されていません。
- Wan VAE と UniT VAE の触覚再構成の比較は公開触覚データセット 1 つだけで行われ、SSIM では UniT のほうが高くなっています。図 6・図 7 の例は、著者ら自身の説明によれば定性的な例示で、接触精度の測定ではありません。
- 世界モデルの予測も実機の成功率も、ハードウェアの安全性の検証ではありません。論文もこの手法を安全性評価として示してはいません。
リンク
- Physical Canvas: A Vision Tactile World Model for Robot Policy Evaluation and Learning(arXiv 2610.28613)
- 論文の HTML 全文
- フロンティア・レーダー|Token-World:VLM の token 空間で世界モデルを展開し、RGB 再構成なしで VLA 方策をシミュレーションする
- フロンティア・レーダー特集|シミュレーションと評価:VLA の評価に初期状態成功率以外で欠けているもの
- フィジカルAIラボ 1.3:センサー――1 つのコップで画素数、深度の測定範囲、握る力を手計算する
- フィジカルAIラボ 1.4:シミュレータの地図――刻み幅のコストを数え、接触で軌道が分かれる点を読み、3 つの高速化の比較対象を確かめる
- フィジカルAIラボ 1.7:強化学習――1 回分の収益を手で計算して報酬の抜け道を見つけ、論文の地形カリキュラムとタイムアウト時のリセットを読む
- フィジカルAIラボ 1.8:評価――「差し引き +2」を対応表に分解し、失敗ラベルと乱数シードを計算で確かめる
- フィジカルAIラボ:すべての数字を確認できるフィジカルAI講座(講座の概要)