
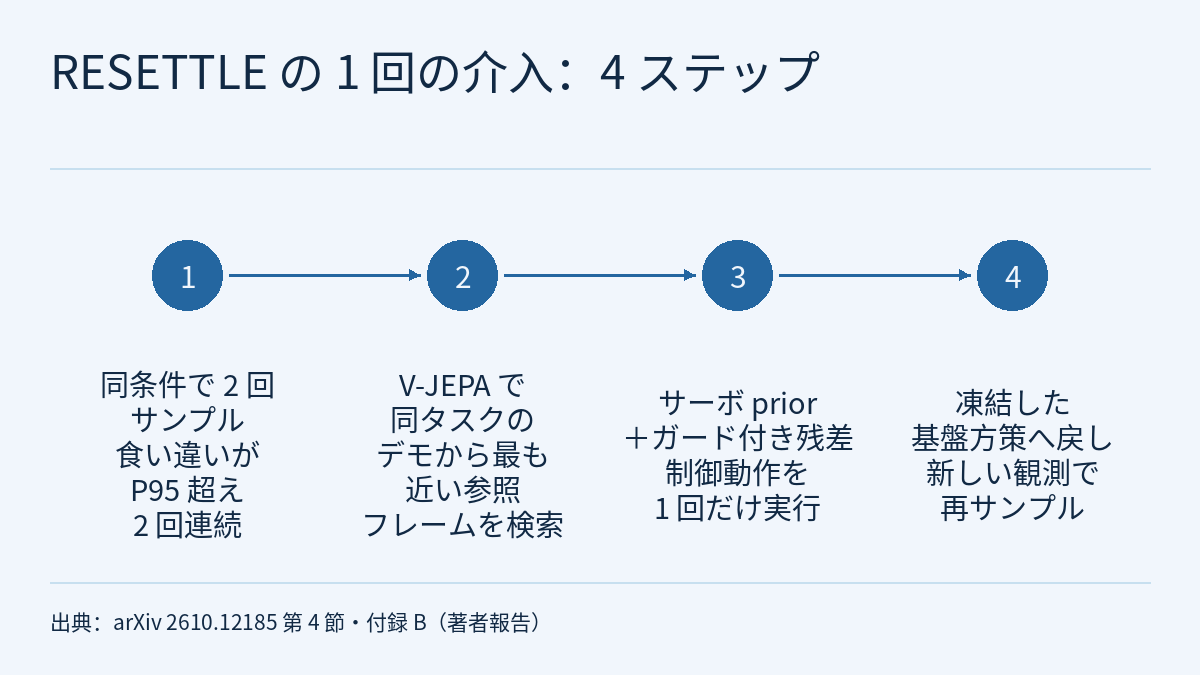
ロボットの方策が実行中にずれたとき、VLM による判断の繰り返しやオンライン最適化で補正しようとすると、大きなレイテンシが生じることがあります。香港科技大学などによるプレプリント RESETTLE(arXiv 2610.12185、2026-10-08)は、凍結した方策の動作実行インターフェースで回復を行います。同じ観測から 2 つの動作チャンクを独立にサンプリングし、その食い違いが 2 回連続でしきい値を超えたときだけ介入します。続いて、改良した V-JEPA 2 エンコーダーで同じタスクの成功デモから最も近いフレームを検索し、「状態サーボ prior +ガード付き視覚残差」で制御動作を 1 回だけ実行してから、制御を基盤方策に戻します。著者報告では、6 つの基盤方策で LIBERO-Plus、Meta-World、RoboCasa Tabletop の絶対成功率がそれぞれ最大 8.70、6.28、6.83 ポイント向上し、実機 4 タスクでも向上しました。QwenPI で計測した監視と回復の計算時間は 83.6 ms です。以下の数値はすべて著者報告 [R] で、本サイトでは再現していません。
論文は既存の回復手法を 3 つに分類しています。1 つ目は追加の教師信号で補正行動を学習させるもので、DAgger は学習者が到達した状態で専門家ラベルを集め、IntervenGen は人の介入から回復軌道を生成します。どちらも追加データと方策の更新が必要です。2 つ目は VLM が回復を監督するもので、Agentic Robot は視覚的な検証で補正と再試行を起動し、VoLoAgent は方策の実行と回復ツールを切り替えます。検証と回復計算の繰り返しがレイテンシを生みます。3 つ目は重みを変えずに推論時に動作を補正するもので、LPB や VLA-Corrector がこれにあたりますが、勾配による誘導に頼るため計算が増えます。著者はさらに、汎用的な VLA/WAM では LPB が用いる専門家特徴の距離が、成功した実行と失敗した実行のあいだでより大きく重なると報告しています。RESETTLE は 3 つ目に属しますが、勾配誘導もオンライン軌道最適化も使わず、VLM の追加呼び出しも行わず、基盤方策の内部表現にもアクセスしません。
いつ介入するか:同じ条件で 2 回サンプリングし、食い違いが続いたときだけ
多くの生成型方策は拡散や flow matching でノイズから動作チャンクをサンプリングするため、同じ観測と指示でもノイズサンプルが変われば別のチャンクが出ることがあります。RESETTLE は各ノミナル決定時点で 2 つの独立したノイズサンプルから 2 つの動作チャンクを生成し、ロボットごとに定めた動作距離で時間重み付きの食い違いを計算します。後の動作ほど重みを小さくできます。GR1 では γ = 0.8 とし、早い動作ほど重みが大きくなります。デカルト空間の動作を出す方策では、回転とグリッパー指令を除いた並進成分のユークリッド距離だけを使います。RoboCasa の GR1 では、29 個すべての正規化座標(両腕各 7、両手各 6、腰 3)の差の二乗から計算した距離を使います。
しきい値は、その基盤方策の学習データに対するオフライン推論で得た食い違いスコアの 95 パーセンタイル(P95)で、評価結果は使いません。基盤方策ごとに個別に較正します。LIBERO-Plus では 1 つのしきい値をすべての摂動の種類とタスクに使い、それ以外のベンチマークではタスク共通のしきい値を使います。2 つの決定時点で続けてしきい値を超えたときだけ起動し、単発のサンプリングのばらつきには反応しません。起動しない場合は 1 つ目のサンプルを実行し、介入のたびにカウントはリセットされます。
著者が示す根拠は次のとおりです。QwenPI では、学習データでの推論と成功した実行の食い違いは低い領域に集中し、失敗した実行は裾が重くなっています。「P95 を 2 回連続で超える」という規則では、LIBERO-Plus の 7 種類の摂動で、失敗軌道の 77.89%–100.00% で起動した一方、成功軌道でも 9.22%–42.81% で起動しました。著者自身、持続する食い違いは情報を持つものの失敗の確定ラベルではないと述べており、そのため短い補正のあとに観測し直す設計にしています。論文はさらに、学習軌道 5 本だけで較正しても、100 本や学習セット全体を使った場合と似た食い違い分布になること、また 1 シードと 2 シードの推論の実測レイテンシが報告精度では同じで、FastWAM で約 297 ms、QwenPI で約 109 ms であることを報告しています。このため、これらの実装では監視によるレイテンシの増加はほぼないとしています。
どう補正するか:デモのフレームを検索し、サーボ prior にガード付き残差を加える
起動すると、改良したエンコーダーが現在の画像をプーリング・正規化した表現に変換し、同じタスクの成功した学習デモの中からコサイン距離で最も近いフレームを探します。このフレームが参照画像と、それに対応するロボット状態の両方を与えます。同じタスクの参照がない場合、制御は基盤方策に残ります。エンコーダーは約 1B パラメータの ViT-g/16 で、DROID で行動条件付き事前学習を行った V-JEPA 2-AC のチェックポイントから初期化し、専門家デモ上で残差動作の教師信号やダイナミクス予測などの目的で同時に学習します。デプロイ時にダイナミクス予測器は動きません。回復モジュールは LIBERO-Plus、Meta-World、RoboCasa、実機の設定ごとに 1 つずつ学習し、同じ設定の複数の基盤方策で共有します。
補正動作は 2 つの部分からなります。現在の状態から参照状態への変位が、ネイティブな制御座標で上限付きの state-servo prior(状態サーボ prior)を与えます。視覚残差ヘッドは、現在と参照の画像表現、ロボット状態、直前の動作、この prior を条件として、prior を調整します。ガード(guard)は、残差と prior のコサイン類似度が下限以上であること、残差と prior のノルム比が上限以下であることを求め、LIBERO では並進と回転を別々に確認します。通過した残差は prior に足してからネイティブの指令範囲にクリップし、通過しなければ上限付きのサーボ動作だけを実行します。各介入では基盤方策の未実行の動作を破棄し、ネイティブの制御ステップを 1 回だけ実行してから、新しい観測とともに制御を基盤方策に戻します。
付録には、デモの参照は成功した行動の経験的なアンカーであり、物理的に到達可能であることを保証するものではなく、基盤方策の実行可能範囲全体を定義するものでもないと書かれています。
成功率:3 つのシミュレーションベンチマーク、階層型プランニング、実機
各比較では、同じ凍結重み、同じ評価条件と実行予算を使い、差は 2 つの百分率の絶対差(ポイント)です。LIBERO-Plus は 7 種類の摂動にわたる 10,030 ケースで、3 つの基盤方策はいずれも標準の LIBERO で学習し、追加のファインチューニングはしていません。平均は種類ごとのケース数で重み付けしています。Meta-World は全 50 タスク、各 10 エピソードの計 500 エピソードで、平均は 4 つの難易度グループの成功率の単純平均です。RoboCasa は 24 タスクの GR1 Tabletop スイートです。LIBERO-Pro Swap は 10 タスク × 10 シードの同じ 100 試行です。
| ベンチマーク | 基盤方策 | ベースライン(%) | +RESETTLE(%) | 差(ポイント) |
|---|---|---|---|---|
| LIBERO-Plus | FastWAM | 49.3 | 58.0 | +8.7 |
| LIBERO-Plus | π0.5 | 70.0 | 73.7 | +3.7 |
| LIBERO-Plus | QwenPI | 80.2 | 84.6 | +4.4 |
| Meta-World | QwenPI | 60.66 | 65.99 | +5.33 |
| Meta-World | SmolVLA | 59.20 | 65.48 | +6.28 |
| RoboCasa Tabletop | LDA | 50.33 | 52.42 | +2.09 |
| RoboCasa Tabletop | QwenGR00T | 53.67 | 60.50 | +6.83 |
| LIBERO-Pro Swap | π0.5 | 15.00 | 24.00 | +9.00 |
| LIBERO-Pro Swap | GPT-5.5 + π0.5(Harness VLA) | 42.00 | 50.00 | +8.00 |
LIBERO-Plus で向上が最も大きいのはロボット初期姿勢の摂動で、FastWAM、π0.5、QwenPI がそれぞれ +16.7、+17.8、+21.4 ポイントです。π0.5 と QwenPI は照明の摂動でそれぞれ 0.2 ポイント下がりました。残差を加えずサーボ prior だけを使った場合の全体成功率は 55.9%、72.9%、83.1% で、ガード付き残差を加えると 58.0%、73.7%、84.6% になります。論文の表 1 上半分にある OpenVLA などのベースラインの数値はそれぞれの論文からの引用で、本論文の対応のある評価ではありません。
LIBERO-Pro Swap の下の 2 行は Harness VLA によるものです。GPT-5.5 のプランナーが指示、観測、メモリをもとに実行を調整し、π0.5 が局所的な操作を担い、RESETTLE は下位方策の動作実行インターフェースに追加されます。著者はこれを、局所的な補正と上位のプランニングが補い合うことの根拠としています。
実機:Franka Research 3 での 4 タスク
実機実験では、外部カメラと手首カメラを備えた Franka Research 3 を使います。基盤方策は QwenPI と VLAct(いずれも Qwen3-VL バックボーン)で、両者は実機用の回復モジュールを 1 つ共有し、しきい値はそれぞれ個別に較正します。各構成でタスクごとに 20 試行を行い、初期のアーム姿勢と物体の配置はランダムで、合計 320 試行です。
| タスク(指標) | QwenPI ベースライン | QwenPI +RESETTLE | VLAct ベースライン | VLAct +RESETTLE |
|---|---|---|---|---|
| Press-button(成功率) | 90 | 100 | 90 | 100 |
| Cube-up(成功率) | 55 | 70 | 85 | 90 |
| Carrot-in-pot(成功率) | 85 | 95 | 90 | 95 |
| Use Spoon(段階完了度) | 36.7 | 50 | 80 | 86.7 |
| 4 タスク平均 | 66.67 | 78.75 | 86.25 | 92.92 |
最初の 3 タスクは二値の成功率、Use Spoon は長期タスクの正規化された段階完了度で、「4 タスク平均」は 2 種類の指標をそのまま平均しています。タスクごとに 20 試行なので、1 試行は 5 ポイントに相当します(本サイトの換算)。VLAct の Cube-up と Carrot-in-pot での 5 ポイントの向上は、それぞれ 20 回中の成功が 1 回増えたことにあたります。本サイトが読んだ本文には、実機結果の信頼区間は示されていません。
レイテンシ:83.6 ms が測るのは計算であって、応答時間ではない
論文の表 6 は、複数の手法を QwenPI ベースで実装して計測したものです。論文には、ローカルの方策推論と回復の推論は NVIDIA RTX 4090D で実行したと書かれています。「監視」はノミナルな方策推論を超える追加の時間、「合計」は監視と回復の和で、ノミナルな推論、ポーリングの遅れ、物理的な実行は含みません。2 つのエージェント型手法はいずれも Qwen3-VL-4B-Instruct で監視し、LPB は著者が自身の QwenPI+V-JEPA フレームワークに移植した版です。
| 手法 | 監視(ms) | 回復(ms) | 合計(ms) | RESETTLE 比 |
|---|---|---|---|---|
| RESETTLE | ≈ 0.0 | 83.6 | ≈ 83.6 | 1.0× |
| Agentic Robot | 107.0 | 109.0 | 216.0 | 2.6× |
| VoLoAgent | 107.0 | 215.0–1193.0 | 322.0–1300.0 | 3.9–15.6× |
| LPB(著者による移植) | 56.2 | 423.5 | 479.7 | 5.7× |
合計時間は Agentic Robot より 61.30%、移植版 LPB より 82.57%、VoLoAgent の配置・把持の分岐より 74.04%–93.57% 短くなっています。VoLoAgent の範囲の下限は配置の分岐、上限は把持の分岐です。手法ごとに出力は異なり、RESETTLE は 1 回に 1 つの動作を、VoLoAgent は軌道を用意します。著者も、RESETTLE はノミナルな決定時点でしか確認しないため、応答は決定の周期と「2 回連続でしきい値超え」の規則に制約されると述べています。表の合計が測るのは計算であり、エンドツーエンドの応答時間ではありません。
本サイトの既存ページとの関係
講座のフィジカルAIラボ 1.6:模倣学習では、行動クローニングの誤差が積み重なり、ロボットがお手本のカバー範囲からはみ出していくことを扱いました。RESETTLE が狙うのはまさにこうした状態ですが、方策を学習し直すことはしません。実行時に「食い違いが高いまま続く」ことを不慣れな状態に入りつつある兆候とみなし、最も近いデモの状態へロボットを 1 ステップ押し戻します。フロンティア・レーダー特集|シミュレーションと評価で紹介した回復ベンチマークは、方策自体がずれから回復できるかを測るものです。RESETTLE は方策の外側に回復モジュールを加えるもので、一方は評価、もう一方は手法です。
評価を読む際には 2 点を照らし合わせると役立ちます。RESETTLE が使う LIBERO-Plus は、フロンティア・レーダー|Is Success All You Need?と同じ摂動ベンチマークです。この記事では、成功率が同程度でも成功軌道が同じとは限らないことを指摘しましたが、RESETTLE が報告するのは成功率だけで、本サイトが読んだ本文には補正後の軌道の所要時間や滑らかさは報告されていません。フィジカルAIラボ 1.8:評価では、合計値が改善と悪化を打ち消し合いうることを扱いました。RESETTLE の起動統計からは成功軌道にも介入していることがわかりますが、本サイトが読んだ本文には、対応ごとの改善・悪化の件数は示されていません。
制約と注意点
- arXiv のプレプリントで、数値はすべて著者報告 [R] です。著者の所属は香港科技大学、香港中文大学、SmartMore、ハルビン工業大学(深圳)、Shenzhen Loop Area Institute です。本サイトはいずれの結果も再現していません。論文はコードを公開したとしていますが、本サイトでは確認していません。
- 食い違いが測るのは動作選択の不安定さで、物理的な実行可能性やタスクの正しさを直接検査するものではありません。論文には、方策が一貫した動作を出す場合、空間的な誤りや指示の取り違えでは介入が起動しないことがあり、起動しても物理的な状況が解消できない場合や目標が合わない場合は回復に失敗しうると書かれています。
- ガードが制限するのは、prior に対する残差の向きと大きさだけです。著者は、結果は視覚的な補正を支持するものの衝突回避を示すものではないとしています。シミュレーション結果も 320 回の実機試行も、ハードウェアの安全性検証ではありません。
- 回復には同じタスクの成功デモとタスク識別子が必要で、参照がなければ介入しません。回復モジュールは設定ごとに学習するため、新しいタスクやロボットには対応するデモデータが必要です。
- 摂動の種類によって、成功軌道の 9.22%–42.81% で介入が起動します。本サイトが読んだ論文の HTML 本文は付録 B で途切れており、付録 C–E にある学習の詳細、起動統計、アブレーション、レイテンシの詳細、失敗例は含まれていません。
- 実機はタスクごとに 20 試行で、本文に信頼区間はなく、「4 タスク平均」は 2 種類の指標を混ぜています。レイテンシは QwenPI ベースの実装でのみ計測され(論文によるとローカル推論は RTX 4090D)、比較手法は著者による実装または移植です。
リンク
- RESETTLE: Robotic Recovery through Disagreement-Triggered Retrieval and Efficient Corrective Control(arXiv 2610.12185)
- 論文 HTML 全文
- フィジカルAIラボ 1.6:模倣学習――誤差がお手本のカバー範囲からはみ出すまでを手で計算し、ACT・拡散方策・データのスケーリング則の数字をそれぞれの条件に照らして読む
- フィジカルAIラボ 1.8:評価――「差し引き +2」を対応表に分解し、失敗ラベルと乱数シードを計算で確かめる
- フロンティア・レーダー特集|シミュレーションと評価:VLA の評価に初期状態成功率以外で欠けているもの
- フロンティア・レーダー|Is Success All You Need?:成功率が同程度の 2 つの VLA でも、成功軌道は大きく違いうる
- フィジカルAIラボ:すべての数字を確認できるフィジカルAI講座(講座の概要)


