
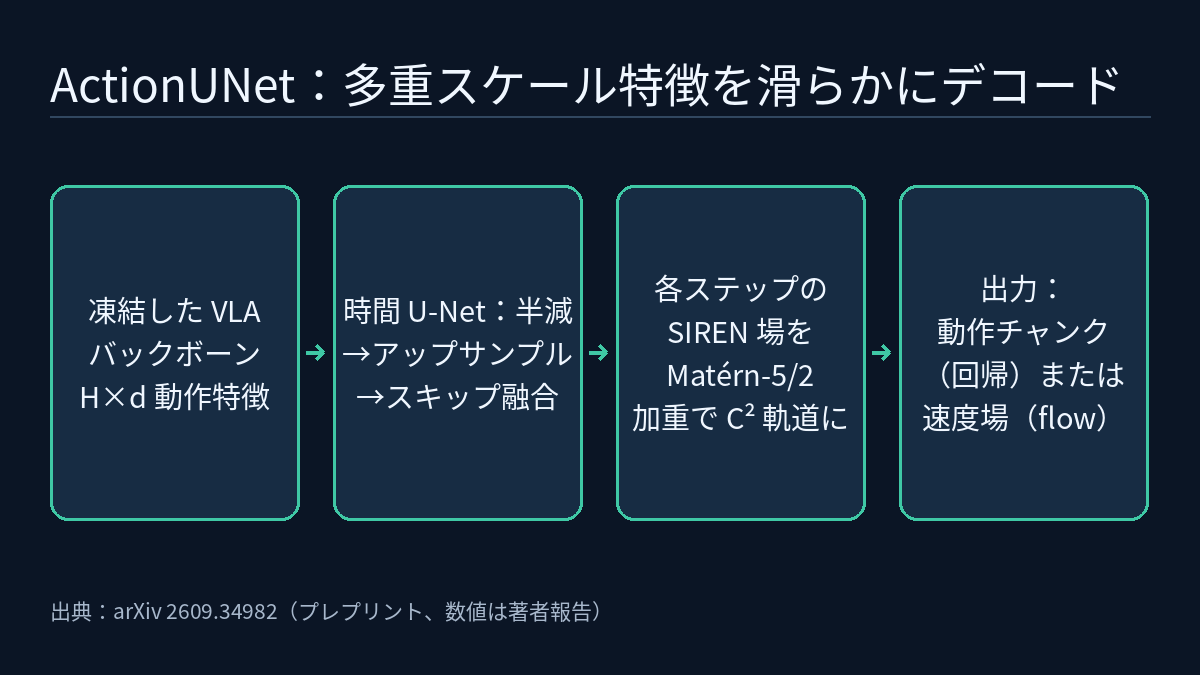
VLA の動作エキスパートは、視覚言語モデルが出す高レベルの意味情報をステップごとに動作へ写像するのが一般的です。しかし同じタスクの中でも、腕を大きく動かす段階もあれば、1 ステップあたりの変位が小さい細かいスケールの動作だけを行う段階もあります。中国科学院大学のチームによるプレプリント ActionUNet(arXiv 2609.34982、2026-09-28、証拠レベル [R])は、この違いを「時間スケールの不整合」と呼び、凍結した VLA バックボーンの後ろに 2 つの軽量モジュールを追加します。動作特徴を多重スケールで符号化する時間 U-Net と、各動作チャンクの内部で 2 階連続微分可能性を保証する条件付き SIREN デコーダーです。著者らの報告では、π0.5 の成功率が RoboTwin 2.0 のハード設定、LIBERO-Plus、実機のハード設定でそれぞれ 9.8、6.1、11.4 ポイント向上し、1 回の方策呼び出しは約 6.5% 遅くなります。この論文で読むべきはアブレーションです。2 つのモジュールは単独で使うと、一方の設定を改善し、もう一方を悪化させます。
問題:1 つの動作チャンクに異なるスケールの動作が混在する
著者らは「動作スケール」を、連続する 2 つの記録ステップ間での左右エンドエフェクタの変位の和で表します。変位が大きければ粗いスケールの動作、小さければ細かいスケールの動作です。論文の図 1 は、この量がタスク間だけでなく、同じタスク(例:Stack Blocks Two)の段階間でも大きく異なることを示しています。単位は m/step で、著者らはこれがデータセット単位のスケールの代理指標であり、物理的な実行速度ではないと明記しています。
著者らの主張はこうです。標準的なファインチューニングでは、動作ヘッドが高レベルのマルチモーダル特徴から各タイムステップを個別にデコードする単一スケールの写像になっており、モデルは抽象的な意味情報に頼りすぎて、局所的な摂動に耐えるのに必要な細かい時間的手がかりを捉えられません。一方、多重スケール表現をそのまま導入すると別の代償があります。粒度の異なる特徴を組み合わせると、スケールの境界で補間誤差が生じて軌道が滑らかでなくなり、機械的な振動を招きます。2 つのモジュールはそれぞれこの 2 つの問題に対応します。
手法:時間 U-Net と条件付き SIREN デコーダー
- 時間 U-Net:VLA は動作のタイムステップに揃った H×d の特徴を出力します(H は動作チャンクの長さ)。エンコーダーの各段では 1 次元畳み込みで時間解像度を半分にし(ダウンサンプリング率 r = 2)、GeLU と LayerNorm を通します。最下層は全結合層を 1 つ通します。デコーダーの各段では最近傍補間で 2 倍にアップサンプリングし、対応するエンコーダー特徴と連結して線形層 1 つで融合し、最終的に H×d に戻します。
- 局所 SIREN 場:動作チャンクを、正規化時間 τ ∈ [−1, 1] 上の連続軌道からのサンプルとみなします。各タイムステップの特徴を条件入力として局所 SIREN 場を 1 つずつ構成し(SIREN は正弦関数を活性化に使う小さなネットワーク)、通常の固定バイアスを τ のアフィン関数に置き換えて、すべての層が時間を明示的に扱えるようにします。
- Matérn-5/2 重み付き融合:長さスケール ρ = 0.2 の正規化 Matérn-5/2 カーネルで、クエリ時刻からの距離に応じてこれらの局所場を重み付けして足し合わせます。付録では、融合後の関数が [−1, 1] 上で 2 階連続微分可能(C²)であることを導出しています。
- 出力:回帰型方策(OpenVLA-OFT)では出力がそのまま動作チャンクで、ℓ1 損失で学習します。フローマッチング方策(π0.5)では出力は速度場で、元の方策と同じ損失を使いますが、白色雑音の代わりに Matérn-5/2 共分散からサンプリングした時間相関のある雑音を使い、ノイズ除去の目標も滑らかにします。
学習時は事前学習済みのバックボーンを凍結し、動作エキスパートと新しいモジュールだけを元の方策の学習目標のままファインチューニングします。RoboTwin 2.0 での π0.5 のファインチューニングには RTX 4090 を 2 枚使って 8K ステップ、LIBERO では A800 を 8 枚使って 40K ステップです。論文によれば、コードと実装の詳細は著者らの GitHub リポジトリで公開されていますが、本記事ではリポジトリの内容を確認していません。
著者らが報告した結果
RoboTwin 2.0 では 50 の双腕タスクから 12 タスクを選び、各タスクをクリーンなデモ 50 本で学習して、イージー設定とハード設定(妨害物、背景、照明、テーブルの高さ、言語が変化)でそれぞれ 100 回評価します。LIBERO-Plus では LIBERO で学習したモデルを 7 種類の摂動下でそのまま評価します。実機は Realman Gen72 双腕プラットフォームで 3 タスク、各タスク・各設定 50 回試行し、ハード設定では妨害物をランダムに追加します。
| 評価(平均成功率) | ベースライン | +ActionUNet | 変化(ポイント) |
|---|---|---|---|
| π0.5、RoboTwin 2.0 イージー(12 タスク) | 59.6% | 68.4% | +8.8 |
| π0.5、RoboTwin 2.0 ハード(12 タスク) | 29.8% | 39.6% | +9.8 |
| π0.5、LIBERO(4 スイート) | 95.6% | 97.7% | +2.1 |
| π0.5、LIBERO-Plus(7 種類の摂動) | 65.8% | 71.9% | +6.1 |
| π0.5、実機イージー(3 タスク) | 76.0% | 88.7% | +12.7 |
| π0.5、実機ハード(3 タスク) | 57.3% | 68.7% | +11.4 |
| OpenVLA-OFT、LIBERO | 97.9% | 98.6% | +0.7 |
| OpenVLA-OFT、LIBERO-Plus | 60.9% | 64.6% | +3.7 |
LIBERO-Plus では、π0.5 は 7 種類の摂動すべてで向上しています。向上幅が大きいのはカメラ(48.2% → 56.9%)、ロボット状態(45.9% → 54.4%)、センサー雑音(52.0% → 61.1%)で、照明(93.0% → 94.6%)と背景(87.4% → 89.8%)は小さめです。RoboTwin 2.0 の 12 タスクには向上しなかったものもあり、Press Stapler のイージー設定は 74% から 73% に、Handover Mic のイージー設定はどちらも 100% です。表中の RDT、π0、ACT など他手法の数値は既存論文からの引用で、著者らが自ら再現したのは π0.5 と OpenVLA-OFT だけです。
アブレーション:モジュール単独ではそれぞれ偏りがある
アブレーションは RoboTwin 2.0 の 4 タスクで、π0.5 をベースに行っています(そのため完全版の数値は 12 タスク平均とは異なります)。
| バリアント | イージー | ハード |
|---|---|---|
| π0.5 | 69.0% | 34.5% |
| + 時間 U-Net のみ | 67.5% | 37.3% |
| + SIREN デコーダーのみ | 75.5% | 33.3% |
| ActionUNet(Matérn カーネルなし) | 75.0% | 45.3% |
| ActionUNet(完全版) | 77.8% | 46.5% |
U-Net だけを加えるとハード設定は改善しイージー設定は悪化し、SIREN だけでは逆になります。著者らの解釈では、多重スケール構造は妨害物への頑健性をもたらす一方で動作の連続性を損ない、連続デコーダーは揺れを抑えるものの多重スケール表現は提供できません。両者を組み合わせると(Matérn カーネルを加える前の段階で)ハード設定は 10.8 ポイント向上し、Matérn カーネルがさらに 1.2 ポイント上乗せします。著者らは Grad-CAM を使い、U-Net の細・中・粗の各層が対応するスケールの正解動作に最も強く反応することも示しています。これは表現がスケールと関係していることを示すものの、それ自体は因果の証拠ではありません。
追加コスト
RTX 4090 1 枚、動作チャンク長 50、フローマッチング 10 ステップ、torch.compile 有効の条件で、1 回の方策呼び出しは 60.947 ± 0.251 ms から 64.886 ± 0.376 ms になり、3.939 ms(+6.46%)増えます。成功ロールアウトの平均ステップ数で換算すると、RoboTwin 2.0 の 1 ロールアウトあたりの累積方策計算時間はイージー設定で 0.934 s 増えます。ハード設定では平均ステップ数が 276.43 から 264.29 に減って一部が相殺され、増加は 0.301 s にとどまります。著者らは、これは方策の計算時間だけであり、ロボットのエンドツーエンドの実行レイテンシではないと注意しています。
本サイトの既存記事との関係
VLA という考え方は「フィジカルAIラボ 0.2:なぜ今なのか、データ・モデル・計算資源の 3 本の曲線」で紹介しています。「Fast Plans, Faithful Actions」も π0.5 をベースにしており、階層型 VLA で計画の生成が遅いこと、実行器が計画どおりに動かないことを扱っています。ActionUNet は計画には関与せず、動作特徴から動作チャンクへのデコードを変えるものです。
「フロンティア・レーダー特集|シミュレーションと評価」では、標準的な初期状態からの成功率では見えないものを論じました。ActionUNet の数値も、標準条件と摂動条件を分けて読む必要があることを示していますが、「摂動下のほうが向上幅が大きい」と単純にはまとめられません。LIBERO はベースラインがすでに 95.6% で、向上の余地は最大 4.4 ポイントしかないため、LIBERO-Plus の +6.1 のほうが情報量があります。RoboTwin 2.0 ではハード設定の向上幅(+9.8)がイージー設定(+8.8)をわずかに上回りますが、実機ではイージー設定の向上幅(+12.7)のほうがハード設定(+11.4)より大きくなっています。レイテンシについては、1 回あたり 6.46% の増加を「フロンティア・レーダー特集|エッジとリアルタイム性」のレイテンシ予算の枠組みで読むことができます。ただし、その記事が扱うのはエッジデバイスで、本記事の数値は RTX 4090 での計測です。
制約と注意点
- これは arXiv のプレプリントで、数値はすべて著者報告です。本記事が依拠した資料には独立した再現はありません。
- 実機は各条件 50 回、RoboTwin 2.0 は各条件 100 回です。本記事で読んだ本文と付録 A〜C には、成功率の信頼区間や有意性検定はありません。それ以降の付録は本記事では確認しておらず、統計的な比較が含まれている可能性があります(たとえば §I.2 では逐次的な方策比較手法が引用されています)。いずれにしても、この程度のサンプル数では、タスク単位の小さな差(74% 対 73% など)を単独で解釈すべきではありません。試行回数が限られるときに 2 つの方策を統計的に比較する方法は、「Beyond Binary Success」の記事で紹介しており、参考になります。
- C² 連続性の証明は 1 つの動作チャンク内部についてのものです。著者らが挙げる制約には、動作チャンクを独立にモデル化していること、時間スケールが固定であること、スケールを考慮したモデル化を下流の動作段階でしか導入していないことが含まれており、チャンクとチャンクのつなぎ目はこの保証の範囲外です。
- RoboTwin 2.0 は 50 タスク中 12 タスクのみで、著者らが時間スケールの構成に基づいて選んでいます。実機評価は 1 つのプラットフォーム、3 タスクです。
- RoboTwin 2.0 と LIBERO では使った GPU と学習ステップ数が異なり、LIBERO での OpenVLA-OFT+ActionUNet は学習率を下げています。ベンチマーク間で向上幅を比べるときは、これらの違いを考慮する必要があります。
リンク
- arXiv 2609.34982:ActionUNet: Improving Robustness of VLA Models with Efficient Multi-scale Fine-tuning(著者:Di Zhu、Ziheng Yan、Fang Wan)
- 論文の HTML 全文


