
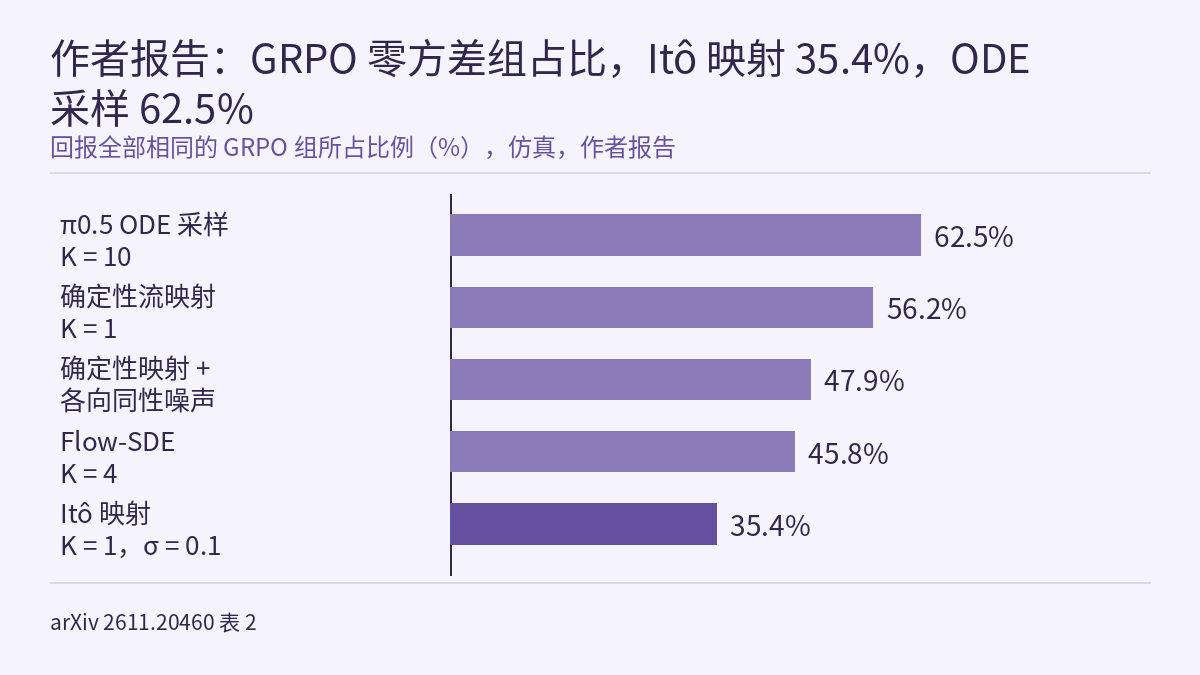
流匹配 VLA 用 GRPO 做在线强化学习微调时有两笔开销:rollout 中每出一个动作块,都要做一次多步 ODE 积分;采样的随机性只来自初始噪声,同一组 rollout 常常回报全部相同,这样的组不产生梯度。arXiv 2611.20460(2026-11-16,Imperial College London)提出 VLA-SSD,把 π0.5 的流匹配动作头自蒸馏成一步出动作的随机策略,随机性来自一条输入网络的布朗路径,并推导出一个可近似计算的条件动作密度,供 GRPO 的似然比使用。作者报告:GRPO 后 LIBERO 成功率 93.0%,比 SFT 检查点高 15.9 个百分点,动作头每块前向 7.6 ms,πRL 的四步 GRPO 为 91.5%、24.5 ms;回报全部相同的组从 62.5% 降到 35.4%。下文数字均为作者报告 [R],全部来自仿真,本站没有运行代码,也没有独立复现。
两个瓶颈:多步积分和零方差组
GRPO 不训练价值网络。它从同一任务、同一初始状态采 N 条轨迹,用组内归一化的回报作为每一步的优势:A_i = (R_i − R̄) / (std(R) + κ)。论文的 LIBERO 和 MetaWorld 任务用二值奖励,一局成功回报为 1,否则为 0。一组轨迹如果全部成功或全部失败,所有优势都是 0,论文把这种组称为退化组:它们消耗了 rollout 计算,却不贡献梯度。
流匹配策略在给定初始噪声 a0 和状态后是确定的,组内动作的差异只能来自 a0 的不同抽样。作者列出的已有办法有两类:加一个外部噪声网络,或者回到每个积分步都注入噪声的多步采样器,例如 πRL 的 Flow-SDE。后者把每块动作的前向次数留在 K 次。论文表 1 给出动作头单块前向时间(一块 A100):π0.5 SFT 检查点的 ODE 采样 K = 10 为 58.4 ms,πRL 的 SDE 采样 K = 4 为 24.5 ms,VLA-SSD 一步为 7.6 ms。
做法:以布朗路径为输入的一步映射
- 底座:π0.5,共 3.3B 参数,其中 300M 参数的动作专家就是流匹配头;视觉-语言骨干(SigLIP 与 Gemma-2B)全程冻结。动作专家上加了两条两层 MLP 支路,分别接收时间区间 t − r 和布朗路径增量,输出层零初始化,所以初始时与原模型的速度场一致。
- 随机性:每个动作坐标配一条标准布朗运动,用前 L = 5 个 Karhunen–Loève 模态表示,系数 ξ 服从标准正态;噪声尺度 σ = 0.1,扩散曲线 β(t) = 2(1 − t)。一步动作写成 a1 = a0 + G(a0; W | s) + m,m 是布朗路径带来的鞅增量。σ = 0 时它退化为确定性流映射。这一构造沿用 Pan 等人的 Itô 映射。
- 自蒸馏:不用外部教师,从预训练的速度场出发,以对角损失加拉格朗日自蒸馏(LSD)训练。作者没有选欧拉式(ESD),因为它不能识别 Itô 映射;也没有选渐进式(PSD),因为它需要两次串行前向。蒸馏在 4 块 A100 上跑 1,000 步,取第 600 步的检查点。
- 似然:把布朗系数拆成决定 m 的分量和与之正交的余量,余量和 a0 合成辅助变量 h,rollout 时存下,重新打分时复用,布朗路径不再重采。在雅可比谱范数小于 1 的假设下,给定 h 的条件密度有闭式(命题 1)。实际计算用一次不动点迭代近似逆映射,把 log det 截到一阶迹,用一个 Hutchinson 探针估计,只多一次雅可比-向量积。密度只在实际执行的 5 步 × 7 维 = 35 个坐标上计算。作者对比的 πRL、ReinFlow 等做法,是在 K 个中间去噪步上算似然比。
作者检查了这个近似:在 GRPO 早、中、晚三个检查点,各重放 8 个 LIBERO 动作块,FP32 下的近似对数似然比与用收敛逆映射和显式雅可比算出的参考值相比,平均绝对误差都低于 0.0002。
主结果:一步 GRPO 与四步基线
所有运行都从 πRL 发布的 SFT 检查点开始;LIBERO 上的 RL 从 few-shot 检查点(77.1%)开始,与 πRL 相同。GRPO 每组 N = 8 条 rollout,在 RLinf 中用 4 块 A100 训练。论文表 1(成功率 %,确定性评测):
| 策略 | 采样 | 每块前向次数 | 前向 (ms) | LIBERO | MetaWorld |
|---|---|---|---|---|---|
| π0.5 SFT | ODE,K = 10 | 10 | 58.4 | 77.1 | 51.8 |
| πRL,GRPO | SDE,K = 4 | 4 | 24.5 | 91.5 | — |
| πRL,PPO | SDE,K = 4 | 4 | 24.5 | 98.3 | 70.7 |
| Itô 学生(VLA-SSD) | Itô,K = 1 | 1 | 7.6 | 68.6 | 49.0 |
| Itô + GRPO(VLA-SSD) | Itô,K = 1 | 1 | 7.6 | 93.0 | 72.0 |
读这张表要注意几点:
- πRL 两行是 πRL 论文在相同检查点和协议下公布的数字,本文作者没有重跑。
- LIBERO 四个套件各评 500 回合,平均值覆盖 2,000 回合,作者给出的标准误是 0.5–0.7 个百分点。93.0% 对 91.5% 相差 1.5 个百分点。引言(含贡献列表)和结论把这一结果写成与四步 GRPO 持平(matching),第 4.2 节写成超过(outperforming)。MetaWorld MT50 按 50 个任务 × 10 个固定重置状态评测,论文没有给出它的不确定度。
- πRL 的四步 PPO 在 LIBERO 上更高(98.3%),作者指出它需要额外训练一个视觉-语言 critic。MetaWorld 上 VLA-SSD 的 72.0% 高于四步 PPO 的 70.7%;πRL 的 GRPO 没有 MetaWorld 数字。
- 训练 rollout 中“每块快 3.2 倍”对应 24.5 ms 与 7.6 ms 之比。一步学生在 RL 之前低于 SFT 检查点:LIBERO 68.6% 对 77.1%,MetaWorld 49.0% 对 51.8%。
摘要里的几个相对数分属不同的教师和检查点。“相对提升 20.6%”是 15.9 个百分点除以 SFT 检查点的 77.1%(本站核算);如果从一步学生的 68.6% 算起,GRPO 带来的是 24.4 个百分点。“动作头前向快 7.7 倍”是 58.4 ms 与 7.6 ms 之比。“LIBERO 成功率相对下降 5.5%”对应表 4 中 π0 教师的 94.15% 降到 Itô 学生的 88.95%(本站核算)。引言里“只降 0.3 个百分点”是另一组:从全示范 π0.5 检查点蒸馏,96.85% 降到 96.55%。这几个数不能合并成一句话。
零方差组:样本多样性有没有变成学习信号
论文表 2 比较了五种采样方式。多步采样用 SFT 检查点,一步采样用蒸馏出的学生;五者的成功率接近(83.1%–84.6%),回报全部相同的组所占比例差别较大:
- π0.5 ODE 采样(K = 10):62.5%;
- 确定性流映射(K = 1):56.2%;
- 确定性映射加各向同性输出噪声 N(0, 0.1²I):47.9%;
- Flow-SDE(K = 4):45.8%;
- Itô 映射(K = 1,σ = 0.1):35.4%。
作者还用有效秩衡量动作多样性。固定 a0 后,ODE 采样和确定性映射的有效秩降为 0.0;Itô 映射在固定和不固定 a0 时分别为 18.5 和 18.2,说明多样性可以只来自布朗路径。各向同性输出噪声的有效秩同样是 18.5,零方差组却多出 12.5 个百分点(本站按表相减)。作者据此推测(原文用词为 suggests),Itô 映射的多样性更能转化为组内回报的差异。表 2 没有给出组数或区间。
训练中的对照在表 3。所有运行从同一蒸馏检查点出发,经过 100 次 GRPO 优化更新后关掉探索噪声评测:
- 噪声尺度:σ = 0.05、0.10、0.20 时,LIBERO 为 69.10%、73.50%、65.15%,MT50 为 58.80%、59.40%、55.20%。默认的 0.10 在所测三个值中最高。
- 噪声来源:同样的 GRPO 设置下,关掉布朗路径输入、改为在输出上加各向同性高斯噪声,LIBERO 为 71.50%,MT50 为 59.00%,Itô 策略分别领先 2.0 和 0.4 个百分点。MT50 上 0.4 个百分点的差距,论文没有给出不确定度。
探索噪声还要让带噪策略足够常成功,组里才会同时出现成功和失败。MetaWorld 上,Itô 学生在训练噪声 σ = 0.1 下成功率 36.8%,确定性评测 49.0%,保留 75%;GRPO 后为 55.4% 和 72.0%,保留 77%。作者引用 πRL 的报告作对照:Flow-SDE 在 K = 1 时只保留确定性成功率的 14.7%,K = 4 时为 86%,这是 πRL 用四步训练的原因。实现上,平均回报落在 [0.1, 0.9] 之外的组在更新前会被丢弃。
RL 后训练的整体流程,以及怎样用多个训练种子的配对区间判断提升是否成立,见 物理AI实验室 3.3。本文所读文本没有给出 GRPO 的多种子结果;标准误与评测回合数的关系,可以对照 物理AI实验室 2.8 的 1/√n 计算。
蒸馏的代价在哪里
表 4 在 LIBERO 上从 π0 教师(πRL 的全数据 SFT 检查点,K = 10)蒸馏,所有学生按 K = 1 评测,每个套件 500 回合,均值的标准误约 0.7 个百分点:
- 教师均值 94.15%,长程套件 85.2%。
- 确定性流映射:LSD 91.30%,PSD 90.80%,ESD 67.50%。
- Itô 映射(σ = 0.1):LSD 88.95%,PSD 87.95%,ESD 65.50%;LSD 的长程套件为 77.0%。
同用 LSD 时,随机形式比确定性映射低 2.35 个百分点,作者把它称为随机化的性能代价。教师越弱,蒸馏损失越大:从 few-shot LIBERO 检查点蒸馏损失 8.5 个百分点(77.1% → 68.6%),MetaWorld 损失 2.8 个百分点(51.8% → 49.0%)。作者还报告:在采样步数都固定为一步时,自蒸馏把 RL 前的成功率从 40.55% 提到 68.60%;在相同训练预算下,从收敛的 SFT 检查点蒸馏、而不是从 π0.5 基座联合训练,K = 1 学生从 12.2% 提到 42.7%。同一检查点按 K = 1 和 K = 5 评测,差异在 ±2 个百分点以内。
局限 / 注意
- 这是 arXiv 预印本,全部数字为作者报告 [R],没有独立复现。实验只在 LIBERO 和 MetaWorld MT50 仿真中完成,没有真机实验。作者认为 3.2 倍的 rollout 提速对真机部署尤其有用,并把真机微调列为下一步;这是作者的预期,不是测量结果。
- 条件密度是近似:作者自述依赖 log det 的一阶截断。论文的密度诊断显示,蒸馏结束时布朗支路的输出投影约为 3 × 10⁻⁴,第一批次的似然比在浮点精度内等于 1;这些值只在训练开始时测量,RL 过程中没有记录该支路的范数。对数似然比误差的检查每个检查点只用了 8 个动作块。
- πRL 的 GRPO 和 PPO 数字取自 πRL 论文。LIBERO 平均值有作者给出的标准误;表 2、表 3 和 MetaWorld 结果没有区间、标准差或多种子结果。
- 在 LIBERO 上,GRPO 版本仍低于需要 critic 的四步 PPO(93.0% 对 98.3%),作者在局限中写明了这一点。
- 本站读到的论文文本止于附录 D 中段,附录 E(一步采样对照)和附录 F(ReinFlow 式 PPO 基线)没有读到。
- 论文给出了 GitHub 代码地址,本站没有打开,没有核实代码内容和许可证。


