
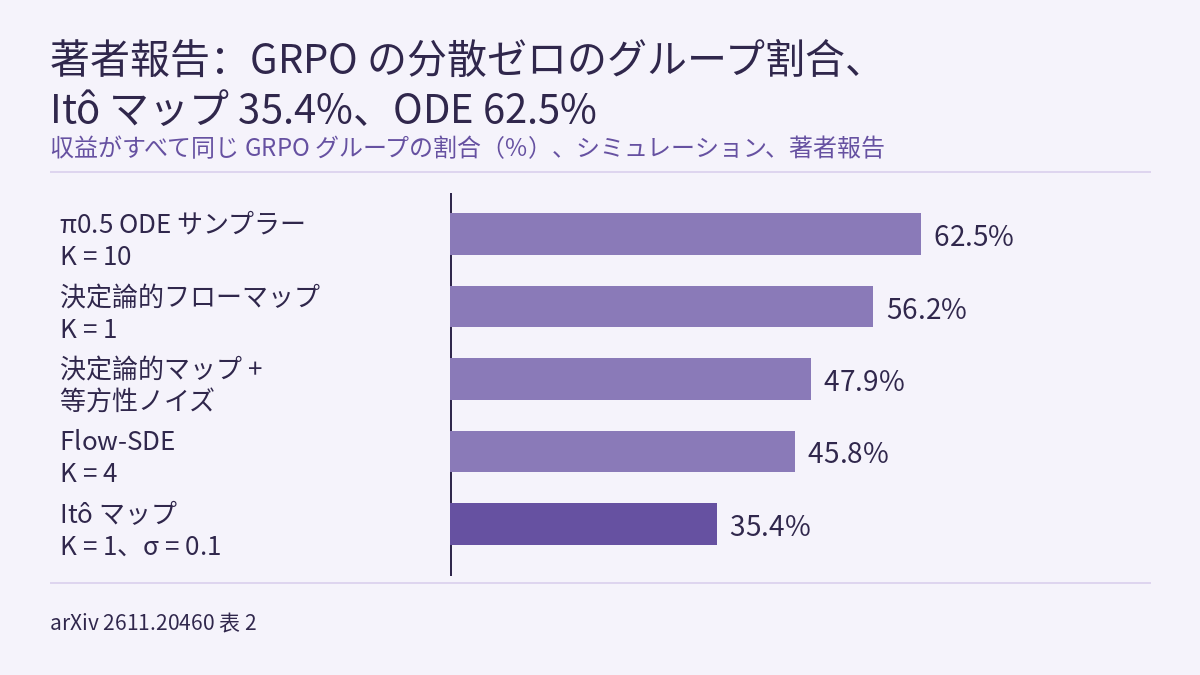
フローマッチング型の VLA を GRPO でオンライン強化学習によりファインチューニングするとき、コストが 2 つあります。ロールアウトで動作チャンクを 1 つ出すたびに多段の ODE 積分が必要になること、そしてサンプリングのランダム性が初期ノイズだけから来るため、同じグループのロールアウトの収益がすべて同じになりやすく、そのグループから勾配が得られないことです。arXiv 2611.20460(2026-11-16、Imperial College London)の VLA-SSD は、π0.5 のフローマッチング動作ヘッドを 1 ステップで動作を出す確率的方策に自己蒸留します。ランダム性はネットワークに入力するブラウン経路から得て、GRPO の尤度比に使える近似計算可能な条件付き動作密度を導きます。著者報告では、GRPO 後の LIBERO 成功率は 93.0% で SFT チェックポイントより 15.9 ポイント高く、動作ヘッドの順伝播はチャンクあたり 7.6 ms です。πRL の 4 ステップ GRPO は 91.5%、24.5 ms でした。収益がすべて同じグループの割合は 62.5% から 35.4% に下がりました。以下の数値はすべて著者報告 [R] で、すべてシミュレーションの結果です。本サイトはコードを実行しておらず、独立した再現もしていません。
2 つのボトルネック:多段積分と分散ゼロのグループ
GRPO は価値ネットワークを学習しません。同じタスク・同じ初期状態から N 本の軌道をサンプリングし、グループ内で正規化した収益を各ステップのアドバンテージとして使います:A_i = (R_i − R̄) / (std(R) + κ)。論文の LIBERO と MetaWorld のタスクは 2 値報酬で、エピソードが成功すれば収益は 1、そうでなければ 0 です。グループの軌道がすべて成功するか、すべて失敗すると、アドバンテージはすべて 0 になります。論文はこうしたグループを退化グループと呼び、ロールアウトの計算を消費するのに勾配に寄与しないとしています。
フローマッチング方策は初期ノイズ a0 と状態が決まれば決定論的なので、グループ内の動作の違いは a0 のサンプルの違いからしか生まれません。著者が挙げる既存の対処は 2 種類です。外部のノイズネットワークを加えるか、πRL の Flow-SDE のように積分の各ステップでノイズを注入する多段サンプラーに戻るかです。後者ではチャンクあたりの順伝播回数が K 回のまま残ります。論文の表 1 は動作ヘッドのチャンクあたり順伝播時間(A100 1 基)を示しています:π0.5 SFT チェックポイントの ODE サンプリング K = 10 が 58.4 ms、πRL の SDE サンプリング K = 4 が 24.5 ms、1 ステップの VLA-SSD が 7.6 ms です。
手法:ブラウン経路を入力とする 1 ステップ写像
- ベースモデル:π0.5 で、全体 3.3B パラメータのうち 300M パラメータの動作エキスパートがフローマッチングのヘッドです。視覚言語バックボーン(SigLIP と Gemma-2B)は学習中ずっと凍結します。動作エキスパートには 2 層 MLP の経路を 2 本加え、一方は時間区間 t − r、もう一方はブラウン経路の増分を受け取ります。出力層はゼロ初期化なので、初期状態では事前学習済みの速度場をそのまま再現します。
- ランダム性:各動作座標に標準ブラウン運動を 1 本ずつ割り当て、最初の L = 5 個の Karhunen–Loève モードで表します。係数 ξ は標準正規分布に従います。ノイズスケールは σ = 0.1、拡散プロファイルは β(t) = 2(1 − t) です。1 ステップの動作は a1 = a0 + G(a0; W | s) + m と書け、m はブラウン経路によるマルチンゲール増分です。σ = 0 では決定論的なフローマップに戻ります。この構成は Pan らの Itô マップに基づいています。
- 自己蒸留:外部の教師は使いません。事前学習済みの速度場から始め、対角損失とラグランジュ型自己蒸留(LSD)で学習します。著者はオイラー型(ESD)を Itô マップを同定できないという理由で、漸進型(PSD)を 2 回の逐次的な順伝播が必要になるという理由で採用していません。蒸留は A100 4 基で 1,000 ステップ行い、ステップ 600 のチェックポイントを使います。
- 尤度:ブラウン係数を m を決める成分と、それに直交する残りに分けます。残りと a0 をまとめて補助変数 h とし、ロールアウト時に保存して再スコアリングで再利用します。ブラウン経路は再サンプリングしません。ヤコビアンのスペクトルノルムが 1 未満という仮定の下で、h を条件とする密度は閉形式になります(命題 1)。実際の計算では、逆写像を不動点反復 1 回で近似し、log det を 1 次のトレースで打ち切り、そのトレースを Hutchinson プローブ 1 本で推定します。追加コストはヤコビアン・ベクトル積 1 回です。密度は実際に実行する 5 ステップ × 7 次元 = 35 座標だけで計算します。著者が比較対象とする πRL や ReinFlow などは、K 個の中間デノイズステップで尤度比を計算します。
著者はこの近似を確認しています。GRPO の初期・中期・後期の 3 つのチェックポイントでそれぞれ LIBERO の動作チャンクを 8 個再生し、FP32 の近似対数尤度比を、収束した逆写像と明示的なヤコビアンで求めた参照値と比べました。平均絶対誤差は 3 つとも 0.0002 未満でした。
主な結果:1 ステップの GRPO と 4 ステップのベースライン
すべての実行は πRL が公開した SFT チェックポイントから始まります。LIBERO の RL は πRL と同じく few-shot チェックポイント(77.1%)から始めます。GRPO はグループあたり N = 8 本のロールアウトを使い、RLinf 上で A100 4 基で学習します。論文の表 1(成功率 %、決定論的評価):
| 方策 | サンプラー | チャンクあたり順伝播回数 | 順伝播 (ms) | LIBERO | MetaWorld |
|---|---|---|---|---|---|
| π0.5 SFT | ODE、K = 10 | 10 | 58.4 | 77.1 | 51.8 |
| πRL、GRPO | SDE、K = 4 | 4 | 24.5 | 91.5 | — |
| πRL、PPO | SDE、K = 4 | 4 | 24.5 | 98.3 | 70.7 |
| Itô 生徒(VLA-SSD) | Itô、K = 1 | 1 | 7.6 | 68.6 | 49.0 |
| Itô + GRPO(VLA-SSD) | Itô、K = 1 | 1 | 7.6 | 93.0 | 72.0 |
この表を読むときの注意点です。
- πRL の 2 行は、πRL の論文が同じチェックポイントとプロトコルで公表した数値で、本論文の著者は再実行していません。
- LIBERO の 4 スイートはそれぞれ 500 エピソードで評価し、平均は 2,000 エピソード分です。著者はその標準誤差を 0.5〜0.7 ポイントとしています。93.0% と 91.5% の差は 1.5 ポイントです。序論(貢献の一覧を含む)と結論はこの結果を 4 ステップ GRPO と同等(matching)と書き、4.2 節は上回る(outperforming)と書いています。MetaWorld MT50 は 50 タスク × 10 個の固定リセット状態で評価し、論文はその不確かさを示していません。
- πRL の 4 ステップ PPO は LIBERO でより高く(98.3%)、著者はこれが視覚言語 critic の追加学習を必要とすると指摘しています。MetaWorld では VLA-SSD の 72.0% が 4 ステップ PPO の 70.7% を上回ります。πRL の GRPO には MetaWorld の数値がありません。
- 学習ロールアウトでの「チャンクあたり 3.2 倍高速」は 24.5 ms と 7.6 ms の比です。RL 前の 1 ステップ生徒は SFT チェックポイントより低く、LIBERO で 68.6% 対 77.1%、MetaWorld で 49.0% 対 51.8% です。
要旨の相対値は、それぞれ別の教師とチェックポイントに由来します。「相対 20.6% の改善」は 15.9 ポイントを SFT チェックポイントの 77.1% で割った値です(本サイトで検算)。1 ステップ生徒の 68.6% から数えると、GRPO による上昇は 24.4 ポイントです。「動作ヘッドの順伝播が 7.7 倍高速」は 58.4 ms と 7.6 ms の比です。「LIBERO 成功率の相対 5.5% 低下」は表 4 で π0 教師の 94.15% が Itô 生徒で 88.95% に下がったことに対応します(本サイトで検算)。序論の「0.3 ポイントの低下」は別の組で、全デモの π0.5 チェックポイントからの蒸留で 96.85% が 96.55% になったものです。これらの数値を 1 つの文にまとめることはできません。
分散ゼロのグループ:サンプルの多様性は学習信号になったか
論文の表 2 は 5 種類のサンプラーを比べています。多段サンプラーは SFT チェックポイントを、1 ステップのサンプラーは蒸留した生徒を使います。成功率は近い値(83.1%〜84.6%)ですが、収益がすべて同じグループの割合には差があります。
- π0.5 ODE サンプラー(K = 10):62.5%
- 決定論的フローマップ(K = 1):56.2%
- 決定論的マップに等方性の出力ノイズ N(0, 0.1²I) を加えたもの:47.9%
- Flow-SDE(K = 4):45.8%
- Itô マップ(K = 1、σ = 0.1):35.4%
著者は動作の多様性を実効ランクでも測っています。a0 を固定すると、ODE サンプラーと決定論的マップの実効ランクは 0.0 に下がります。Itô マップは a0 を固定したときに 18.5、固定しないときに 18.2 で、多様性がブラウン経路だけからも生まれることを示しています。等方性の出力ノイズも実効ランクは 18.5 ですが、分散ゼロのグループは 12.5 ポイント多くなっています(本サイトが表から引き算)。著者はここから、Itô マップの多様性のほうがグループ内の収益の違いに結びつきやすいと推測しています(原文の語は suggests)。表 2 にはグループ数も区間もありません。
学習時の比較は表 3 にあります。すべての実行は同じ蒸留チェックポイントから始め、GRPO の最適化更新 100 回の後に探索ノイズを切って評価しました。
- ノイズスケール:σ = 0.05、0.10、0.20 で、LIBERO は 69.10%、73.50%、65.15%、MT50 は 58.80%、59.40%、55.20% です。既定値 0.10 は試した 3 つの値の中で最も高い結果でした。
- ノイズの出所:同じ GRPO 設定で、ブラウン経路の入力を外し出力に等方性ガウスノイズを加えると、LIBERO は 71.50%、MT50 は 59.00% で、Itô 方策はそれぞれ 2.0 ポイントと 0.4 ポイント上回りました。MT50 の 0.4 ポイントの差について、論文は不確かさを示していません。
探索ノイズは、ノイズ付きの方策がグループに成功と失敗の両方が入る程度には成功し続けることも必要とします。MetaWorld では、Itô 生徒は学習時のノイズ σ = 0.1 の下で成功率 36.8%、決定論的評価で 49.0% で、保持率は 75% です。GRPO 後はそれぞれ 55.4% と 72.0% で、保持率は 77% です。比較として著者は πRL の報告を引いています:Flow-SDE は K = 1 で決定論的成功率の 14.7% しか保持せず、K = 4 で 86% を保持するため、πRL は 4 ステップで学習しています。実装上、平均収益が [0.1, 0.9] の外にあるグループは更新前に捨てられます。
RL 事後学習の全体の流れと、複数の学習シードにわたる対応のある区間で改善を判断する方法は フィジカルAIラボ 3.3 を参照してください。本サイトが読んだ論文本文には GRPO の複数シードの結果がありません。標準誤差と評価エピソード数の関係は、フィジカルAIラボ 2.8 の 1/√n の計算と照らし合わせられます。
蒸留でどこが失われるか
表 4 は LIBERO で π0 教師(πRL の全データ SFT チェックポイント、K = 10)から蒸留した結果です。生徒はすべて K = 1 で、スイートあたり 500 エピソードで評価し、各平均の標準誤差は約 0.7 ポイントです。
- 教師の平均は 94.15%、長期スイートは 85.2%。
- 決定論的フローマップ:LSD 91.30%、PSD 90.80%、ESD 67.50%。
- Itô マップ(σ = 0.1):LSD 88.95%、PSD 87.95%、ESD 65.50%。LSD の長期スイートは 77.0%。
LSD 同士で比べると、確率的な形式は決定論的マップより 2.35 ポイント低く、著者はこれを確率的な定式化に伴う性能のトレードオフとしています。教師が弱いほど蒸留による低下は大きく、few-shot の LIBERO チェックポイントからでは 8.5 ポイント(77.1% → 68.6%)、MetaWorld では 2.8 ポイント(51.8% → 49.0%)です。著者はさらに、サンプリングを 1 ステップに固定した条件で、自己蒸留が RL 前の成功率を 40.55% から 68.60% に上げたこと、同じ学習予算で π0.5 ベースから同時に学習する代わりに収束した SFT チェックポイントから蒸留すると、K = 1 の生徒が 12.2% から 42.7% に上がったことを報告しています。同じチェックポイントを K = 1 と K = 5 で評価した差は ±2 ポイント未満です。
制約と注意点
- arXiv のプレプリントで、数値はすべて著者報告 [R] であり、独立した再現はありません。実験は LIBERO と MetaWorld MT50 のシミュレーションだけで、実機実験はありません。著者は 3.2 倍のロールアウト高速化が実環境への展開で特に役立つと考え、実機でのファインチューニングを次の課題に挙げていますが、これは著者の見込みで、測定結果ではありません。
- 条件付き密度は近似です。著者自身が、log det の 1 次の打ち切りに依存することを制約として挙げています。論文の密度診断では、蒸留終了時のブラウン経路の出力射影は 3 × 10⁻⁴ 程度で、最初のミニバッチの尤度比は浮動小数点精度で 1 に等しくなっています。これらの値は学習開始時にだけ測ったもので、RL 中はこの経路のノルムを記録していません。対数尤度比の誤差の確認は、チェックポイントあたり 8 個の動作チャンクだけで行っています。
- πRL の GRPO と PPO の数値は πRL の論文から取ったものです。LIBERO の平均には著者が示した標準誤差がありますが、表 2、表 3 と MetaWorld の結果には区間、標準偏差、複数シードの結果がありません。
- LIBERO では、GRPO 版は critic を使う 4 ステップ PPO より低いままで(93.0% 対 98.3%)、著者もこれを制約として明記しています。
- 本サイトが読んだ論文本文は付録 D の途中で終わっており、付録 E(1 ステップのサンプリング比較)と付録 F(ReinFlow 型 PPO ベースライン)は読めていません。
- 論文には GitHub のコードのアドレスが記載されていますが、本サイトは開いておらず、コードの内容とライセンスを確認していません。
リンク
- Stochastic Self-Distillation for Flow-Based Vision-Language-Action Models(arXiv 2611.20460)
- 論文 HTML 全文
- フィジカルAIラボ 3.3:RL事後学習――HIL-SERL の「2 倍」と RECAP の「処理量 2 倍以上」をそれぞれの条件に戻し、三つのシードの対応のある区間を計算し直す
- フィジカルAIラボ 2.8:再現できる評価――Wald 区間と Wilson 区間を手で計算し、1/√n から評価回数を決め、失敗ゼロのあとの失敗率の上限を求める
- フィジカルAIラボ:すべての数字を確認できるフィジカルAI講座


