この回の動画
ナレーションは AI 合成音声です。 動画の章・文字起こし・出典
文字起こし
文字起こし
知行の問い
論文が、きれいな成功率を報告してる。でも、その数字が信用できるって、どうしたら分かるの?今回は、最前線の読み方を学びます。結論を暗記するのではなく、鍵になる数字を確かめられるようになる。研究者の基本の技です。
数字はなぜだますのか
先にはっきりさせておきます。たいていは、でっち上げではありません。定義がそろっていないか、うっかりです。でも、誤解を招く結果は同じです。まず、二つのことを分けましょう。一つ目は、数字の計算が正しいか。二つ目は、その数字が本当は何を言っているか。数字が文脈から切り取られるのも、よくあることです。ピークの値が、ふだんの値のように書かれる。一見、驚かされます。数字を読んだら、すぐに感心しないこと。どんな条件で測ったのか、と問いましょう。条件が違えば、数字も違います。実際の例です。ある人が π0 を微調整しました。初期の報告では、改善は九十六パーセント。のちに評価用と学習用のデータを厳密に分けると、八十九パーセントに下がりました。これは特別な例ではありません。評価データがこっそり学習に混ざるのは、いちばんよくある落とし穴の一つです。防ぐのは大変です。なぜ数字が高く出るのか。評価のとき、モデルは学習で同じ問題を見ているからです。持ち込み可の試験と同じです。悪くなったんじゃなくて、前の数字がもともと高すぎたんだ!同じような落とし穴は、ほかにもあります。デモは量産ではありません。ピークはふだんの値ではありません。もう一つ、シミュレーションは実機ではありません。画面の中でできても、机の上でできるとは限りません。物理は、そんなに言うことを聞きません。いちばん良かった一回だけを報告する人もいます。十回走らせて一回を選べば、とても良く見せられます。これをいいとこ取りと言います。平均の取り方にも、からくりがあります。平均の定義を変えると、数字が少し良く見えることも。よく見て、初めて気づきます。
確認リスト
落とし穴を減らすには、どうするか。自分用の確認リストを一枚持つことです。どの論文を読むときも、一通り当てはめます。一つ目の問いは、誰が言っているか。ここでは最前線レーダーの力を借ります。一つ一つの結論に、証拠レベルが付いています。公式か、論文か、メディアか。誰が言うかで、同じ結論でも重みがまったく違います。一緒くたにしないこと。まず、誰が言っているかを見ます。レベルは三つ。公式の一次情報が O、論文やプレプリントが R、メディアの二次情報が M です。自己申告と査読済みを混ぜないこと。証拠レベルは点数ではありません。その一文をどこまで信じてよいかを、思い出させてくれるだけです。まず心の中で見当をつけます。二つ目の問いは、定義は何か。成功率は、どの段階を数えているのか。一つのステップか、作業全体か。定義がはっきり書かれていなければ、二つの論文の成功率は、そもそも比べられません。先に定義をそろえてから、高い低いを比べます。でないと、比べても無駄です。同じ言葉でも、定義は大きく違いえます。つかみ成功は、触れたら成功か、しっかり持ち上げたら成功か。ここは大違いです。三つ目の問いは、どう分けたか。評価用のデータが、学習用に混ざっていないか。ここがいちばんつまずきやすいところです。どう調べるか。学習に何を使い、評価に何を使ったかが、はっきり書いてあるかを見ます。書いていなければ、要注意です。分け方をまちがえると、モデルは答えを先に見たのと同じです。そんな高得点は、新しい場面ですぐ崩れます。見かけ倒しです。四つ目の問いは、数字が合っているか。あるデータセットは、ベンチマークの説明からは五百エピソードあるように見えるかもしれません。でも実際に数えると、三百七十九しかありません。これを甘く見てはいけません。五百のつもりで動かすと、プログラムが途中でエラーになります。だから数字は、元のファイルで確かめます。もう一つの問いは、ピークか、ふだんの値か。メーカーは最高値を出したがります。ふだんはどれくらいで動くのかを聞きましょう。両者は、ひと回り違うことがよくあります。ピークを報告するのは、もちろんかまいません。ただ、ふだんの値と思われないよう、はっきり書くこと。明記するのは当然の務めです。さらに一つ、サンプルは足りているか。またあの π0 の報告です。その数字は、最初の五つの取り置きエピソードだけで平均したものです。サンプルが少ないと、順位はすぐ揺れます。細かい差はノイズにすぎないかもしれないので、こだわりすぎないこと。何度も走らせるほうが確かです。この問いを、全部書き留めておきましょう。誰が言ったか、どんな定義か、どう分けたか、ピークか、サンプルは足りているか。一つ欠けても、足をすくわれるかもしれません。
実践:レーダーで確かめる
レーダーの一覧を開いて、一緒に一度やってみましょう。気になる最前線の結論を一つ選びます。ここでは、評価の方法を扱う論文を選びました。なぜレーダーから始めるのか。レベルと数字を、もう代わりに抜き出してくれているからです。手間が半分になります。最初にやるのは、日付を見ること。arXiv は第一版の投稿日で見ます。古い数字を、新しい成果と取り違えないように。レーダーは毎日、最前線の話題をいくつか並べます。どれにも証拠レベルと、抜き出した数字が付いています。まず O、R、M のどれかを見て、心の中で格付けします。原文を開きます。タイトルと要旨で止まらず、手法と結果の部分までめくります。数字はそこに隠れています。論文を全部読めなくても大丈夫です。その鍵になる数字一つだけを、見つめていればいい。流れさえつかめば十分です。論文によると、途中で打ち切れる逐次型の評価は、標準的な一括評価より評価の負担を最大七十パーセント、成功か失敗かだけを扱う最新の逐次評価より最大五十パーセント減らせました。その隣にある原文の一文を書き写します。それが、あなたの証拠です。書き写すには、こつがあります。その一文が、数字を直接支えていなければなりません。あいまいな文は、数に入りません。メモするときは、条件も一緒に。その七十パーセントは上限で、標準的な一括評価との比較です。数字は条件から離れると意味がなく、条件こそが鍵です。あの π0 の報告で練習しましょう。報告によると、厳密に分けてから、動作の誤差は二つのデータセットで、それぞれ約九十パーセント下がりました。でも、ここで止まらないこと。指標を確かめると、これは開ループの動作誤差で、実機の成功率ではありません。この二つは別物です。ここまで確かめれば、タイトルしか見ない人より、ずっと多くが分かります。その九割に、どれほどの意味があるか分かる。自分の物差しができます。確かめ終えたら、書き残します。さっきの論文のように、レベルとリンクも付けて、ほかの人も確かめられるように。次からは、そのまま引用できます。次に同じ数字を見かけたとき、もう迷いません。この記録は、ためるほど価値が増します。これが複利です。まだ解決していないのは、確かめる作業が人頼みで、時間がかかること。それに原文があいまいなこともあります。道具で、もっと手助けできるはずです。ふりかえりです。ポイントは三つ。一つ、数字が高く出るのは、たいてい定義のせいで、ねつ造ではない。二つ、最前線を読む前に、確認リストを一通り当てる。三つ、原文に戻って確かめ、数字を支える一文を書き写す。確かめられれば、にぎわいを追う側から、自分で判断できる側になれる!それが、この講座が渡したいものなんだ。モデルを判断できたら、次はロボットの体とコストをどう見る?産業のお金の計算だよ。また次回!
根拠と出典
練習とセルフチェック
小テストは公開で、回答するとすぐ解説が出ます。読み物の練習問題の答えはログイン会員向けです。
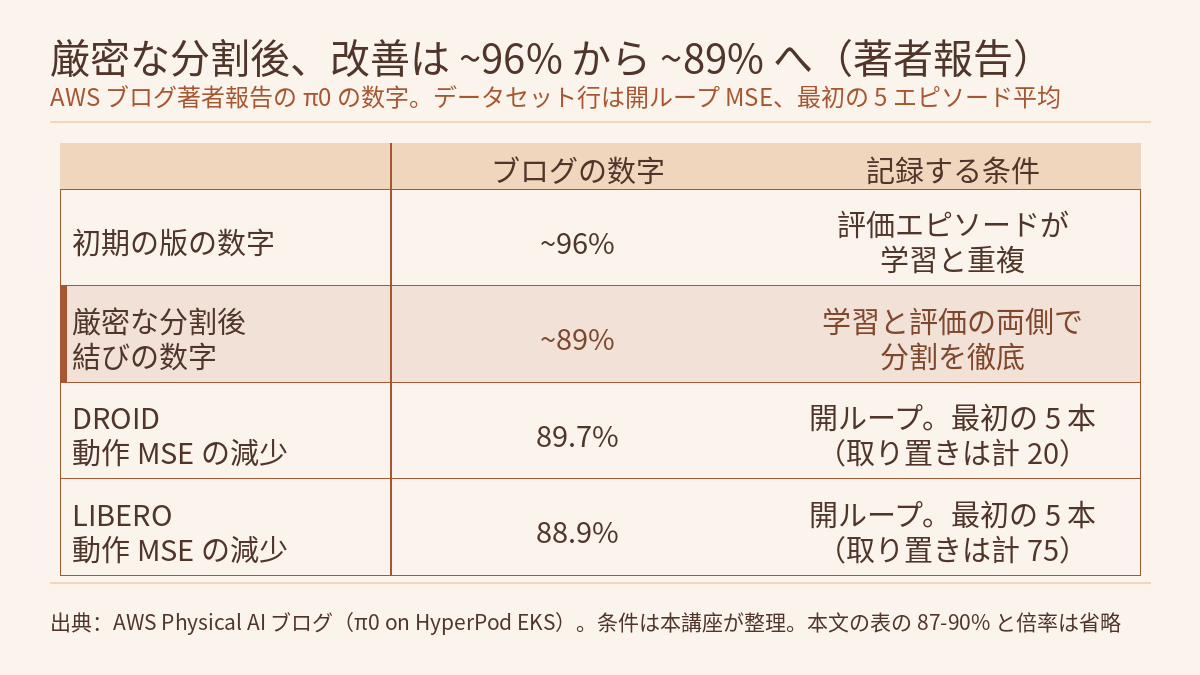
第 3.6 回の動画は、最前線の読み方を扱います。数字が高く出るのは、たいていねつ造ではなく、定義がそろっていないためです。評価データが学習データに混ざる、ピークをふだんの値として書く、シミュレーションを実機と取り違える、といった例です。どの論文も、まず確認リストを一通り当てます。誰が言っているか、どんな定義か、どう分けたか、数字は合っているか、ピークかふだんか、サンプルは足りているか。最後に原文に戻り、その数字を直接支える一文を書き写します。動画の例は二つの公開資料から取っています。AWS が SageMaker HyperPod EKS で π0 をファインチューニングしたエンジニアリングブログと、arXiv のプレプリント Beyond Binary Success(2603.13616)です。このページはこの回の解説と練習です。文字起こしは繰り返さず、動画が結論だけを示して展開しなかった三つのことを行います。同じブログに出てくるいくつかの「約九割」を一つずつ指標と基準に対応づけ、減少率と倍率を換算して、どの文がどの数字を支えられるかを確かめます。ブログの分割表から学習エピソードと取り置きエピソードを数え、N=5 が取り置き全体のどれだけを覆うかを計算し、原文が書いていない層を見つけます。そして論文の要旨にある 70% と 50% をそれぞれの基準に戻し、二つの「最大」をつなげて計算できない理由を確かめます。全体を通す約束は、数字はその指標、基準、データの分け方、サンプル数と一緒に記録すること、どれか一つでも欠けたらその数字だけを言い換えて伝えないことです。
この回の動画、文字起こし、出典はこのページの上部にあります。シーズン全体の構成は講座の概要をご覧ください。前回のフィジカルAIラボ 3.5:GR00T ファインチューニング実践――ファインチューニングのコマンドと modality の配線図を一項目ずつ確かめ、CPU の代役実験でオープンループ誤差とクローズドループ成功率を分けるは、こうした成功率や改善が本物か誇張か、どう見分けるのか、という問いで終わりました。この回はその続きです。開ループ誤差と閉ループ成功率がどれだけ離れているかは、3.5 で代役実験を使って計算しました。同じ AWS ブログの「200 ms 未満、約 5 Hz で再計画」はフィジカルAIラボ 3.4:長期タスク――ステップごとの成功率とチェーン全体の成功率を手で計算し、進み具合の記憶が変える量を確かめ、上位層だけを入れ替えたルーティングのアブレーションを審査するで使いました。O/R/M の三つのレベル、「最大」は「ふだん」ではないこと、70% が減らすのは評価の手間で成功率ではないことは、フィジカルAIラボ 0.6:ロボットのニュースをどう見分けるか――それぞれの問いを原文の一文まで戻すで解説し、練習しました。対応のある比較と区間は、フィジカルAIラボ 1.8:評価――「差し引き +2」を対応表に分解し、失敗ラベルと乱数シードを計算で確かめるとフィジカルAIラボ 2.8:再現できる評価――Wald 区間と Wilson 区間を手で計算し、1/√n から評価回数を決め、失敗ゼロのあとの失敗率の上限を求めるで計算しました。この論文の手法そのものは、本サイトのレーダー記事フロンティア・レーダー|Beyond Binary Success:実機試行が限られるなか、逐次検定で方策の優劣を早く見分けるで紹介しています。この回はそれらを繰り返さず、L3 の読者が一つの資料を確かめるときの三つの手順だけを扱います。指標を対応づける、分け方を数える、基準を切り分ける、の三つです。次回 4.1 は、体とサプライチェーン、つまりアクチュエータ、部品表、コスト曲線です。
公開小テストの 5 問には詳しい解説が付いています。ログインすると、三つの練習に取り組めます。AWS ブログの六組の数字を一枚の確認記録にまとめ、減少率と倍率を換算し、架空の言い換え四つを審査する。ブログの分割表と N=5 のカバー率を確かめ、エピソード数が合わない架空のデータセットの分け方を書き直す。架空の論文紹介文を審査し、70% と 50% をそれぞれの基準に戻して書き直す。いずれにも段階的な解答例、よくある誤り、20 点満点の採点基準が付いています。
1. 三つの資料のレベルと、確認記録に書く欄
AWS ブログ(Fine-Tuning π0 (Pi-Zero) for robotic manipulation on Amazon SageMaker HyperPod EKS)は、AWS が自社で行った一回のファインチューニング実験の報告です。π0 は Physical Intelligence の 30 億パラメータのフローマッチング VLA で、ブログはこれを二つのデータセットでファインチューニングしています。実機の Franka アームで集めた lerobot/droid_100 と、シミュレーションの Franka Panda アームの lerobot/libero_10 です。本講座の分類では O レベルで、以下の数字はすべて著者の報告です。本サイトはこの手順を実行していません。
Beyond Binary Success(arXiv 2603.13616)の著者は University of Pennsylvania、Toyota Research Institute、Princeton University の所属です。論文は N-SCORE を提案しています。safe, anytime-valid inference(SAVI)にもとづく逐次比較の手法で、証拠が十分にたまれば評価を途中で打ち切れます。指標は成功か失敗かの二値でも、部分点、報酬、軌道の滑らかさのような上下限のある連続量でもかまいません。プレプリントで、本講座の分類では R レベルです。以下も著者の報告で、本サイトは再現していません。この回で読んだのは arXiv の HTML 版の要旨から第 4 節の冒頭までで、実験結果の各節と補足資料は含みません。
Physical AI レーダーの README は、三つのレベルの意味をこう書いています。原文は中国語です。
[O] 一手官方 · [R] 论文预印本 · [M] 媒体二手。厂商自报与同行评议不混为一谈。
意味は、[O] 公式の一次情報、[R] 論文・プレプリント、[M] メディアの二次情報、メーカーの自己申告と査読を同列に扱わない、です。同じ README の「読み方」の節には、R の数字は著者の自己申告であり、O でも「プラットフォームで使える」と「顧客が導入済み」を区別すべきだ、とも書かれています。AWS ブログが O だというのは「AWS 自身が言った」という意味で、「独立に検証済み」という意味ではありません。
動画は、確かめた成果を「数字 + それを直接支える原文の一文 + 証拠レベル + リンク」としています。L3 の読者はもう少し欄を増やします。この後の三つの節で見つかる問題は、どれもその欄に出てくるからです。次の表は本講座がすすめる記録の形で、どの資料の決まりでもありません。例にはブログの DROID の数字を使います。
| 欄 | 書くこと | 例:ブログの DROID の数字 |
|---|---|---|
| 数字 | 原文の値。「約」「最大」などの限定語も含める | 89.7% |
| 原文 | 一文を一字一句写す。一件に一文、つなぎ合わせない | 第 2 節の最初の引用 |
| 指標と単位 | 何を測ったか、減少率か倍率か | 動作予測 MSE の減少率 |
| 基準 | 何と比べたか | ベースのチェックポイント(lerobot/pi0_base) |
| データと分け方 | どのデータセットか、学習と評価にどのエピソードを使ったか | lerobot/droid_100、学習 0–79、取り置き 80–99 |
| サンプル数 | 実際に何エピソード、何シードを平均したか | 最初の 5 つの取り置きエピソード。読んだ本文にシード数の記載なし |
| 評価の方法 | 開ループか閉ループか、シミュレーションか実機か | 開ループ。録画した軌道と比較 |
| レベル、リンク、確認日 | O / R / M、原文のリンク、原文を開いた日 | O、AWS ブログのリンク、自分の確認日 |
| 原文が書いていないこと | 言い換えるときにいちばん補われやすい部分 | 閉ループ成功率、区間、シード数 |
最後の欄がいちばん省かれやすい欄です。言い換える人は、原文が書いていない部分を自分で補いがちです。たとえば開ループ MSE の減少率を成功率として書いてしまいます。この欄を別に立てておけば、次に引用するとき、何を言ってはいけないかが分かります。
ログインすると、このレッスンの続きと確認問題、解答を読めます。
制約と注意点
- AWS ブログは O レベルで、AWS が自社で行った一回のファインチューニング実験の報告です。~96%、~89%、89.7%、88.9%、87-90%、3.7×–5.6×、roughly 9×、分割表、N=5 はすべて著者の報告です。本サイトはこの手順を実行しておらず、リポジトリも確かめていません。読んだのはブログ本文の抜粋で、シード数や信頼区間は見当たりませんでした。
- Beyond Binary Success はプレプリントで R レベルです。70%、50%、10–60 回、4500 回超と 2000 回のロールアウト、第一種の誤りについての証明は著者の報告で、本サイトは再現していません。この回で読んだのは要旨から第 4 節の冒頭までで、実験結果の各節と補足資料は含まないため、上限がどのデータセットと指標で出たかは分かりません。「50% の基準は STEP かその種の手法」は本講座の推測です。
- レーダーの O/R/M は資料の分類で、その一文の重みを思い出させるためのものです。結論の正しさの判定ではありません。
- 次は本講座の計算、整理、提案です。減少率と倍率の換算、カバー率、「最初の 5 つ」を 80–84 と 304–308 とした字義どおりの推測、第 1 節の記録の形、第 2 節と第 4 節の対照表、40% を導けないという議論。
- R1〜R4、toy_shelf、同僚 K の要約、60 回と 50 回の計画、プレプリント P と手法 X は架空です。開ループ誤差も紙の上の計算もタスク成功率ではなく、ハードウェアの安全性の検証でもありません。
リンク
- フィジカルAIラボ:すべての数字を確認できるフィジカルAI講座(講座の概要)
- フィジカルAIラボ 3.5:GR00T ファインチューニング実践――ファインチューニングのコマンドと modality の配線図を一項目ずつ確かめ、CPU の代役実験でオープンループ誤差とクローズドループ成功率を分ける
- フィジカルAIラボ 3.4:長期タスク――ステップごとの成功率とチェーン全体の成功率を手で計算し、進み具合の記憶が変える量を確かめ、上位層だけを入れ替えたルーティングのアブレーションを審査する
- フィジカルAIラボ 0.6:ロボットのニュースをどう見分けるか――それぞれの問いを原文の一文まで戻す
- フィジカルAIラボ 1.8:評価――「差し引き +2」を対応表に分解し、失敗ラベルと乱数シードを計算で確かめる
- フィジカルAIラボ 2.8:再現できる評価――Wald 区間と Wilson 区間を手で計算し、1/√n から評価回数を決め、失敗ゼロのあとの失敗率の上限を求める
- フロンティア・レーダー|Beyond Binary Success:実機試行が限られるなか、逐次検定で方策の優劣を早く見分ける
- Physical AI レーダー:全項目に証拠レベルを付けた身体性AIの朝刊
- AWS:Fine-Tuning π0 (Pi-Zero) for robotic manipulation on Amazon SageMaker HyperPod EKS
- Beyond Binary Success: Sample-Efficient and Statistically Rigorous Robot Policy Comparison(arXiv 2603.13616)
- Physical AI レーダー(GitHub、O/R/M の証拠レベルの説明)