
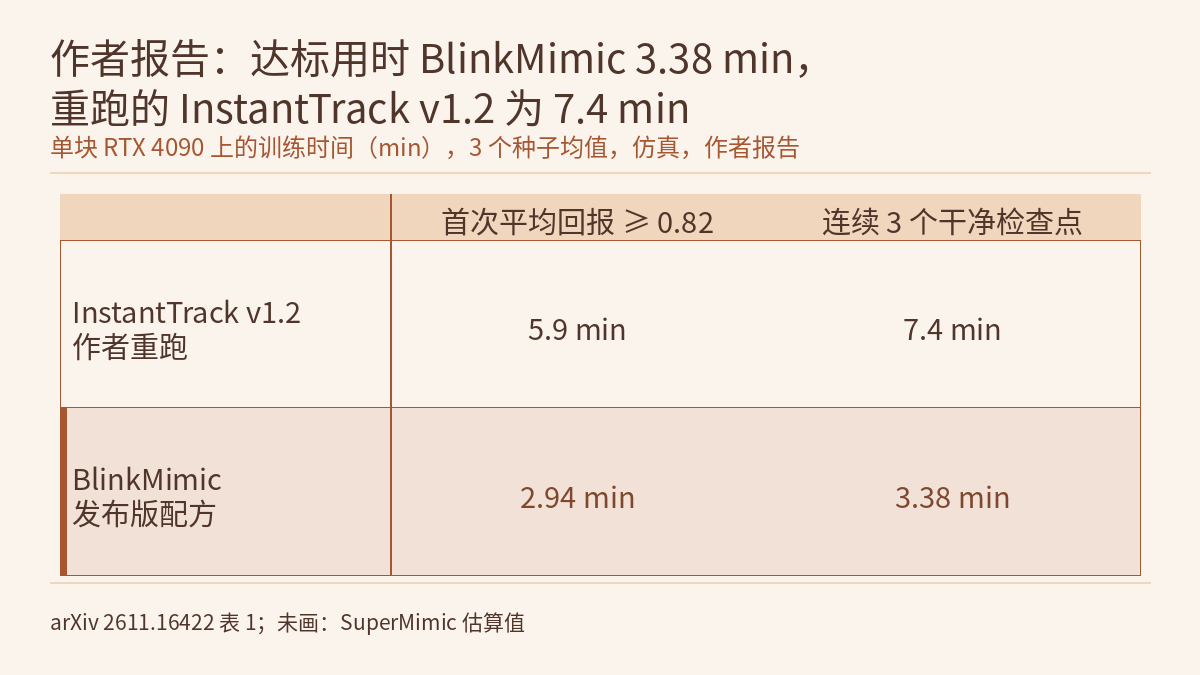
预印本 BlinkMimic(arXiv 2611.16422,2026-11-12,作者 Fuyi Chen)在 SuperMimic 和 InstantTrack 的基础上继续压缩人形机器人全身动作跟踪策略的训练时间。作者报告:在仿真的 Unitree G1 上,用一块 RTX 4090 为全部 40 段 LAFAN1 动作训练一个策略,到达论文的严格目标平均用时 3.38 分钟(3 个种子),在同一块 GPU、同一评测器上重跑的 InstantTrack v1.2 为 7.4 分钟。对做训练工程的读者,更有用的是论文的记账方法:把训练时间拆成每轮成本、拟合所需迭代和收尾所需迭代三项,再用逐项消融检查每个组件落在哪一项上。下文数字均为作者报告 [R],全部在仿真中测得,本站没有运行代码,也没有独立复现。
任务和“达标”怎样定义
机器人是有 29 个驱动关节的 Unitree G1,在 MuJoCo-Warp 中以 50 Hz 控制。动作库是重定向到 G1 的 40 段 LAFAN1 片段,共 441,140 帧、2.45 小时,平均每段 3.7 分钟。策略输出归一化动作,缩放后作为 PD 控制器的关节位置目标;奖励是若干高斯跟踪核之和加动作变化率惩罚,锚定部位的高度或倾斜误差超过阈值即判失败,这些设定沿用 SuperMimic。
评测时,部署策略以确定性方式运行,不加域随机化和噪声,从每段的第一帧跑到结尾。归一化回报在 [0, 1] 之间,累计到第一次失败为止。仿真器不能逐位复现,临界的片段可能在两次评测之间翻转,所以每段跑 4 个副本,共 160 次 rollout。一个检查点“干净”的条件是平均回报不低于 0.82,且 160 次全部未失败;目标是连续 3 个干净检查点,用时记在其中第一个上,这一规则与 InstantTrack 相同。检查点每 100 次迭代一个(约 13 秒)。训练时间包含编译、图捕获、检查点和探测,不含离线评测。
物理AI实验室 1.7 读 Learning to Walk in Minutes 时用过一条规则:一个训练耗时只对它自己的硬件、任务和设置成立。BlinkMimic 把目标、评测条件和计时范围都写在了时间旁边,是按这条规则读数字的一个现成例子。
训练循环:在学到的世界模型里反向传播
每次迭代分两部分。采集阶段,4096 个仿真机器人在域随机化下运行带噪声的训练策略,把转移存入回放缓冲区;回合结束后,从动作库里按 1 秒分箱的重置分布抽一帧重新开始。想象阶段,从缓冲区取 B 个起始状态,在学到的世界模型里展开 H = 32 步,策略沿时间反向传播(BPTT)得到的梯度更新;critic 拟合想象轨迹的 λ 回报,部署的是训练策略的指数滑动平均(EMA,β = 0.995)。
用 BPTT 穿过学到的世界模型、以路径梯度代替高方差的策略梯度,来自 SuperMimic。EMA 部署策略、Muon 更新和“输出相对参考动作的修正量”的残差策略,来自 InstantTrack 的开源实现。BlinkMimic 新加的是三样:按训练进度回落的步长、按部署条件下的失败来分配重置、把整轮迭代捕获为 CUDA graph;此外把想象批量减半到 2048。
时间账:每轮成本乘以拟合与收尾两段迭代
论文把训练时间写成 T = c̄ (N_fit + N_tail):每轮平均成本 c̄ 乘以迭代数,迭代数又分成拟合阶段 N_fit(到平均评测回报首次达到 0.82)和收尾阶段 N_tail(直到最后几段不再失败)。三项受不同因素限制,作者分别设计。单块 RTX 4090 上的主结果(论文表 1,种子 0 / 1 / 2,括号内为均值,时间单位为分钟):
| 配置 | ms/迭代 | 到 0.82 的迭代数 | 首次 ≥ 0.82 | 连续 3 个干净检查点 | 收尾失败数 | 最终回报 |
|---|---|---|---|---|---|---|
| InstantTrack v1.2(重跑) | 147 | 2408 / 2741 / 2492 | 5.6 / 6.3 / 5.8(5.9) | 7.3 / 8.5 / 6.3(7.4) | 80 / 126 / 113 | 0.856 |
| BlinkMimic(发布版) | 135 | 1292 / 1456 / 1169 | 2.89 / 3.28 / 2.64(2.94) | 3.32 / 3.28 / 3.53(3.38) | 2 / 6 / 0 | 0.861 |
收尾失败数是第 2000 到 3500 次迭代各检查点上失败 rollout 的总和。两种配置的各种子用时没有重叠。按 3 个种子的均值,3.38 分钟中约 9 秒是启动与编译,167 秒用于到达首个回报 0.82 的检查点,26 秒是收尾;拟合阶段占 80% 以上。达标时 14 个跟踪部位的位置 RMS 误差为 4.1 cm,平均关节角误差 4.0°;由于没有全局位置反馈,根部位置漂移为 93 cm。论文图 1 里 SuperMimic 的柱是估算值(InstantTrack 跑 SuperMimic 时的迭代数乘以 SuperMimic 在作者 GPU 上的每轮耗时),不是实测。比较提速数字时先看基线是怎么得到的,物理AI实验室 1.4 练过这一步;这里的 InstantTrack 是实测重跑,SuperMimic 是推算。
每个组件落在哪一项
作者在最终配方上逐个去掉组件,每行 3 个种子(论文表 2)。消融在另一种 GPU 上运行、比较迭代数,完整配方在那里到 0.82 需要 1422 次迭代,在 RTX 4090 上是 1306 次,所以只在同一张表内比较。
| 去掉的组件 | 作用项 | 作者报告的变化 |
|---|---|---|
| 策略上的 Muon(改用 Adam) | N_fit | 到第 6000 次迭代仍未达标,回报停在 0.81;该行沿用 ×4 步长和 2048 批量,不代表 Adam 调优后的最好水平 |
| 世界模型上的 Muon | N_fit | 到 0.82 的迭代 +24% |
| 按进度回落的步长(改为恒定 ×1) | N_fit | +14% |
| 参考残差 | N_fit | +23% |
| 半隐式世界模型与镜像增强 | 回报水平 | 拟合迭代不变(1428 对 1422),第 2000–3500 次迭代的平均回报降为 0.854(完整配方 0.860) |
| 部署条件下的重置分配 | N_tail | 3 个种子合计收尾失败 9 → 18,但种子间重叠,三检查点规则也没有变慢 |
| 想象批量恢复为 4096 | c̄ | 迭代数 −20%,但在早期配置的 RTX 4090 测量中每轮多 41%(172 对 122 ms),总时间变长 |
步长从基础学习率的 4 倍开始,训练回报首次超过 0.75 时(最迟第 1400 次迭代)在 300 次迭代内线性降到 1 倍。InstantTrack 已经把两个更新阶段捕获为 CUDA graph;BlinkMimic 从第一次迭代起就捕获,并把采集步(策略推理、物理步、奖励,以及用固定形状操作实现的回合重置)放进同一个 CUDA graph。作者报告,在同一 GPU 上交替运行、不含检查点和探测的两组配对实验中,稳态每轮从 127.5 ms 降到 118.5 ms(−7%),前 700 次迭代缩短 18 秒。作者检查过,掩码重置后的仿真状态与原重置逐位一致,只有关节速度最多相差 2.4 × 10⁻⁷。
拟合阶段卡在更新规则,收尾阶段卡在练习分配
为判断梯度信号还有多少改进空间,作者用同一网络和优化器,以 DAgger 式采集回归一个已收敛策略的动作,当作“完美老师”参照。Muon 让老师所需的更新从 3494 次降到 1478 次(2.3 倍);发布配方在批量 2048 下只需 1306 次迭代,少于老师的 1478–1499 次。作者据此认为,更好的信号剩余空间不大,更好的更新规则还有空间。作者也说明这个比值只是参照,不是下界。世界模型给出的动作梯度在 1 步和 8 步上与仿真器的相关系数为 0.95–0.98 和 0.80–0.89,到 32 步时很低;去掉 critic 则迭代数多 50%。
收尾阶段的分析以 jumps1_subject2 为例,加入分配之前,后期失败大多来自这段里先在地面翻滚、再站起来的动作。这段单独训练时,第 1000 次迭代前 16 次 rollout 全部失败,从第 1250 次迭代起 128 次无一失败;混在 40 段里训练时,难点之前的 10 秒只得到 0.6%–1.5% 的重置;强制把 10% 的重置放到这段窗口上,第 1750 到 3000 次迭代的 6 个检查点上 256 次全部成功(每项各一个种子)。作者的结论是,这些状态学得会,只是练得太少,而训练中统计的失败(策略带噪声、有随机化、未经平均)会指向错误的位置。回放缓冲区还有滞后:一个新出现的失败窗口分到 18.2% 的重置,但在缓冲区换完一轮(约 400 次迭代)之前,只占想象起点的 2.5%。
因此 BlinkMimic 从第 1000 次迭代起每 125 次迭代用 EMA 策略在部署条件下扫一遍整个动作库,按 1 秒分箱记下首次失败,计数每次扫描衰减 0.7,并摊到失败分箱及其前 10 个分箱上,最后这张图分到全部重置的 15%。在较早的配方 B 上,作者预先登记了判定标准,收尾失败从 23 / 22 / 10 降到 2 / 10 / 2,三检查点用时从 6.1 降到 4.9 分钟;在发布配方上,剩余失败太少,3 个种子已分不开两组。
本站介绍过的 SONIC-K1 也是人形动作跟踪器,但它关心的是移植到 Booster K1 和延迟下的成功率,机器人、训练硬件和指标都不同,两篇的数字不能直接比较。
局限 / 注意
- 这是单作者的 arXiv 预印本,全部数字为作者报告 [R],没有独立复现。论文给出了代码和逐种子结果的仓库地址,本站没有打开,也没有运行。
- 作者写明的证据范围:一种机器人、一个动作库、一种 GPU 计时,没有真机部署结果。“几分钟训练完”只指仿真训练,不是硬件安全验证。
- 3 个种子分辨不出严格规则下约 15% 以内的差异;消融沿用为完整配方调好的超参数,去掉的组件换用自己的设置可能更好;结构和镜像是一起去掉的,几项诊断只有一个种子,且在较早配置上测得。
- 达标不保证之后一直干净:种子 1 在第 3100 次迭代时,fallAndGetUp2_subject2 的 4 个副本全部失败。作者把这类后期翻转列为最值得解决的问题。
- 异步探测假设 GPU 没有其他负载;有其他进程共用 GPU 时训练可能崩溃,同步探测可以避免,但更慢。
- 图 1 中 SuperMimic 的用时是估算,不是同条件实测;InstantTrack 是作者重跑的 v1.2。
链接
- BlinkMimic: Training a Humanoid Motion Tracker in Minutes on a Single GPU(arXiv 2611.16422)
- 论文 HTML 全文
- 物理AI实验室 1.7:强化学习,手算一局回报看奖励怎样被钻空子,再读论文里的地形课程与超时重置
- 物理AI实验室 1.4:仿真器地图,手算步长代价、找出接触分叉点,再给三个提速数字标清基线
- 前沿雷达|SONIC-K1:把通用人形动作跟踪器移植到更小的 Booster K1,一块共享 H100 上训练,仿真里跟住 97.4% 的留出片段,延迟到 40 ms 却掉到 56.0%
- 物理AI实验室:一套每个数字都能核对的物理 AI 课程


