
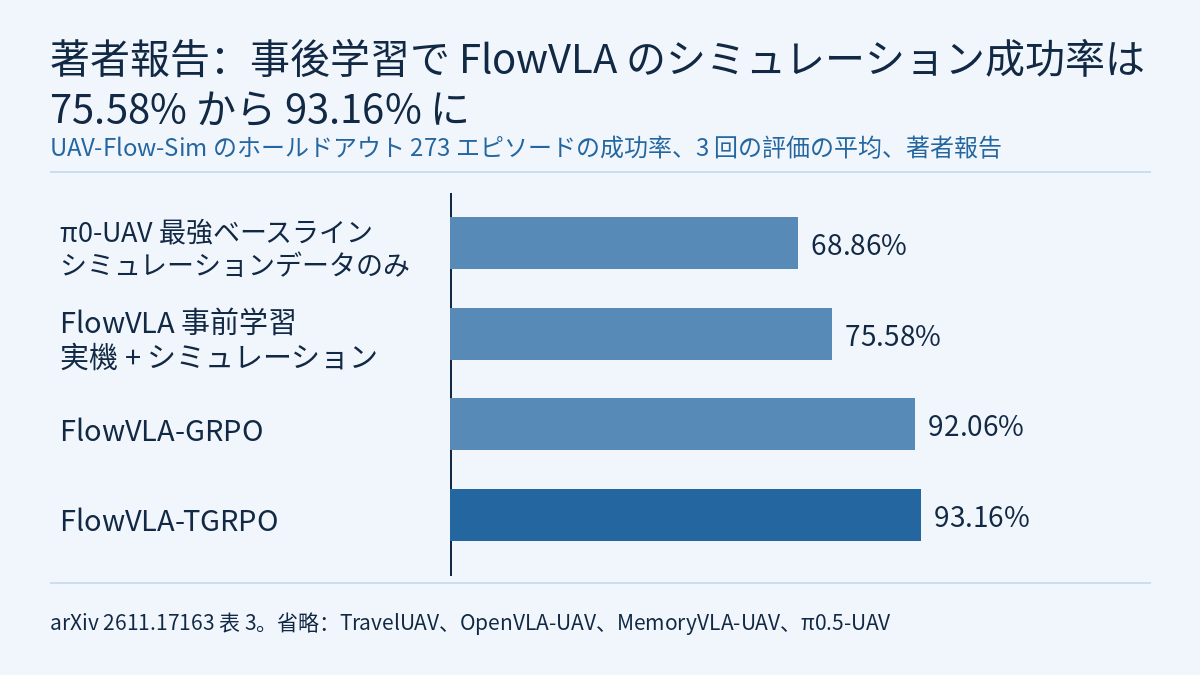
UAV-Flow++(arXiv 2611.17163、2026-11-12)は、北京航空航天大学が主導し、シンガポール国立大学と香港中文大学 MMLab の著者が加わったプレプリントです。扱うのは次のようなドローンの問題です。「あの木の左側を通過して」のような短い指示を受けたら、方策が機体のカメラ画像と現在の状態から連続的な飛行動作を直接出力し、短距離の機動をこなします。著者は、言語で誘導する UAV の研究は長距離の経路計画が中心で、物体を基準にした短距離の機動はあまり研究されていないと述べています。論文は、プロのパイロットが飛ばした実機のお手本 30,692 件、自動採点つきの閉ループ評価用シミュレーション環境 UAV-Flow-Sim、そして模倣で学習したあとシミュレーション内の強化学習で事後学習する方策 FlowVLA を公開しています。著者の報告では、学習に使わず取り分けておいた(ホールドアウト)273 のシミュレーション・エピソードで、FlowVLA の成功率は事前学習後に 75.58%、TGRPO による事後学習後に 93.16% でした。以下の数値はすべて著者報告 [R] で、本サイトは著者のコードを実行しておらず、データもダウンロードしていません。
タスク:1 つの指示で 1 回の短距離機動
著者はこのタスクを Flying-on-a-Word(Flow)と呼んでいます。方策は各時間ステップで 3 つの入力を受け取ります。自然言語の指示、エピソードの開始点を原点とする局所座標系での機体の 6 自由度状態、機体の一人称画像です。出力はその局所座標系での目標姿勢か「位置 + ヨー角」の指令で、機種ごとのフライトコントローラに変換できます。タスクが問う能力は 2 つあります。1 つは動作の意図の理解で、ある方向への平行移動、一定角度の回転、上昇、ホバリング、着陸などです。もう 1 つは指示の中の空間関係を画像に結びつけることで、車に近づく、物体の指定された側を通過する、ランドマークの横で止まる、といったものです。そのため指示は、基本動作の指示と物体とのインタラクションを伴う指示の 2 種類に分かれます。
論文の表 1 は、これまでの言語誘導 UAV ベンチマークを並べています。AVDN、AerialVLN、CityNav、OpenUAV、OpenFly、IndoorUAV、HUGE-Bench はいずれもデータがシミュレーション由来で、多くは長距離ナビゲーションか目標指向ナビゲーションです。UAV-Flow はシミュレーションと実機を組み合わせ、連続 6 自由度の動作、約 40K 件の軌跡を持ち、タスクの粒度は短距離の実行です。著者によれば、UAV-Flow の軌跡の大半は 20 メートル未満です。本論文は著者の学会版 UAVFlow の拡張版で、タスク単位の自動採点、混合データでの事前学習とオンライン RL による事後学習、より充実した比較とアブレーションが加わっています。
データ:実機のお手本とシミュレーションの軌跡
実機データは 3 つの大学キャンパス、計 5.02 km² で収集され、歩行者、車両、植生、建物、道路、空き地、ランドマークを含みます。飛行経験 800 時間超の資格を持つパイロットが、4K カメラと RTK GPS モジュールを備えた DJI Mavic 3T RTK などの商用機を操縦し、軌跡の精度はセンチメートル級です。パイロットは機体からの映像だけを見て指示を実行したので、記録された画像は配備した方策が見る入力と一致します。同じ指示を複数の開始位置と向きから飛ばしているため、同じ意図に対して異なる軌跡が複数あります。映像とフライトログはタイムスタンプで同期し、フレームごとに 6 自由度状態を補間したうえで、開始点を原点、向きを初期方位からの相対値とする局所座標系に変換し、5 Hz でサンプリングしています。アノテータはまず、挙動があいまいなもの、安全でない実行、空間関係が不明確なもの、意味が一貫しないものを除き、固定のコマンド集合から正規ラベルを付けます。そのラベルを大規模言語モデルで言い換え、語彙を限定しない指示も作っています。結果は 8 つの主要動作カテゴリにわたる 30,692 件の軌跡です。
UAV-Flow-Sim はキャンパスのシーンに構築され、UnrealCV で描画と制御を行い、制御インタフェースは「位置 + ヨー角」です。シーンには静的なランドマークと、人、車両、四足ロボットなどのインタラクティブな物体があります。10,109 件のシミュレーション軌跡の一部は人が操縦し、決まった機動はシミュレータの特権情報(機体の状態と物体の位置)を使うルールベースのスクリプトで生成しています。両者の動作の分布は異なります(論文の表 2)。実機データでは「接近」と「通過」が最も多く、それぞれ 28.1% と 28.4% です。シミュレーションでは「平行移動」と「接近」が多く、29.4% と 25.6% です。実機データにはホバリングの軌跡が 3.2k 件ありますが、シミュレーションのデータにはありません。
事前学習には実機データの全部は使われていません。著者はタスクのバランスと軌跡の品質で 9,766 件の実機軌跡を選び、10,109 件のシミュレーション軌跡と合わせて 19,875 件、946,607 フレームとしました。本サイトの計算では、実機データの約 3 分の 1(9,766 ÷ 30,692 ≈ 0.32)にあたります。
シミュレータによる採点の仕組み
閉ループ評価では、シミュレータが各ステップで現在の画像と状態を方策に渡し、返ってきた動作を実行して次のフレームを返します。エピソードはタスク完了、衝突、安全制約違反、ステップ数の上限到達のいずれかで終わり、シミュレータは軌跡全体、終端状態、物体との関係、衝突イベントを記録します。各エピソードには、タスク種別 k に応じた完了スコア C_k = C_proc + C_goal が 0〜1 の範囲で付きます。前の項は機動の過程を見るもので、たとえば「通過」タスクで指定された物体や領域を本当に通り過ぎたかを調べます。後の項は終端状態を見るもので、たとえば目標位置で止まったかを調べます。距離や角度の項にはクリップ付き区間スコア Φ(d, Δ, w) = max(0, w − 0.1⌈d/Δ⌉) を使います。d は誤差、Δ は 0.1 点減るごとの誤差の区間、w はその項の満点です。
本サイトが読んだ本文には、タスクごとの w と Δ は書かれていません。仮の値で一度計算してみます。w = 0.5、Δ = 0.5 m、終点の誤差 d = 1.2 m なら、⌈1.2/0.5⌉ = ⌈2.4⌉ = 3 で、得点は 0.5 − 0.3 = 0.2 です。誤差が 2.0 m を超えるとこの項は 0 になり、誤差が 0 より大きければ最低でも 0.1 点減ります。これらの数字は式を説明するためのもので、論文の設定ではありません。
論文は 3 つの指標を報告しています。成功率(SR。該当するすべての完了条件を満たしたときだけ成功と数えます)、完了スコア(CS)、正規化動的時間伸縮(NDTW。実行した軌跡と参照軌跡の類似度で、各点は位置とロール・ヨー・ピッチの余弦を並べたものです)です。テストセットは人手で注釈した 273 エピソードで、それぞれ初期状態、指示、参照軌跡、完了条件が決まっています。注意したいのは、これらのテスト・エピソードがシミュレーションのお手本を集めたのと同じキャンパスのシーンで行われ、RL による事後学習もこのシミュレータで行われている点です。「ホールドアウト」はエピソード単位の話で、シーンは変わっていません。
FlowVLA と TGRPO:まず模倣し、次にグループ内の報酬分布で重み付けする
FlowVLA は事前学習済みの Qwen3-VL バックボーンと軽量な離散動作ヘッドからなります。入力はエピソードの最初の画像、現在の画像、そしてテキストとして指示の後ろにつなげた状態 (x, y, z, ヨー角) です。モデルは「位置 + ヨー角」の動作を一度に 10 ステップ予測し、4 つの次元をそれぞれ 256 の区間に分けます。データは 5 Hz でサンプリングされているので、1 つの動作チャンクは 2 秒分です。事前学習では VLM を LoRA でファインチューニングし、動作ヘッドを交差エントロピーで学習します。NVIDIA L40 GPU 8 基で 80,000 ステップ学習しています。
著者が挙げる事後学習の理由は、模倣はエキスパートの軌跡付近の状態しかカバーせず、閉ループ実行中のずれが方策をお手本の分布の外へ運び、誤差が積み重なるというものです。こうした誤差がお手本のカバー範囲からはみ出す過程は フィジカルAIラボ 1.6 で手計算しています。RL は SimpleVLA-RL フレームワークで行い、学習するのは「通過」「回転」「着陸」「接近」の 4 種類のタスクだけです。タスクごとに学習用軌跡が 204 件あり、方策の更新は計 90 回です。各イテレーションでは 16 の並列タスク設定それぞれで閉ループのロールアウトを 8 本ずつ(計 128 本)温度 1.6 でサンプリングし、1 本あたりのシミュレータとのやり取りは最大 100 回です。報酬はエピソード終了時の完了スコアで、評価には貪欲デコーディングを使います。
標準の GRPO は、グループ内の報酬から平均を引き、標準偏差で割った値をアドバンテージにします。TGRPO は TailRL のしきい値に基づく重み付けを使います。グループ内の報酬を r(1) ≤ … ≤ r(G) と並べ、r(0) = 0 として、重み ω(r(i)) = Σ_{ℓ=1..i} (r(ℓ) − r(ℓ−1)) / (G − ℓ + 1) を計算し、グループ内の平均を引いてグループサイズ G を掛けたものをタスク・アドバンテージとします。分母は「その区間を超える報酬を得た軌跡の数」なので、到達した軌跡が少ない報酬区間ほど重みが大きくなります。そのあと、グループ内で中心化した参照方策に対する KL ペナルティを差し引き、GRPO のクリップ付き目的関数をそのまま使います。
仮のグループで違いを見てみます(G = 4、報酬は等間隔、KL 項は省略)。
| 軌跡 | 報酬(完了スコア) | GRPO のアドバンテージ(母標準偏差 0.224) | TGRPO のタスク・アドバンテージ |
|---|---|---|---|
| a | 0.4 | −1.34 | −0.60 |
| b | 0.6 | −0.45 | −0.33 |
| c | 0.8 | +0.45 | +0.07 |
| d | 1.0 | +1.34 | +0.87 |
TGRPO の列の計算は次のとおりです。ω は順に 0.4/4 = 0.10、0.10 + 0.2/3 ≈ 0.17、0.17 + 0.2/2 ≈ 0.27、0.27 + 0.2/1 ≈ 0.47 で、平均は 0.25 です。それぞれから平均を引いて 4 を掛けると表の値になります。GRPO のアドバンテージは平均について対称で、母標準偏差でも標本標準偏差でもこれは変わりません。TGRPO では、報酬の差が同じ 0.2 でも、c と d のアドバンテージの差は 0.80、a と b の差は約 0.27 しかありません。報酬がグループ平均(0.7)を上回る c も、わずかな正のアドバンテージしか得ません。これが、少数の高報酬の軌跡をより強く強化するという著者の説明の中身です。表の数字は本サイトが論文の式で計算した練習で、論文のデータではありません。RL による事後学習の証拠一般の読み方は フィジカルAIラボ 3.3 を参照してください。
結果:表 3 のどの比較が同じ条件か
論文の表 3 の全体の結果は次のとおりです(テスト 273 エピソード、3 回の評価の平均。標準偏差があるのは FlowVLA の 3 行だけです)。
| 手法 | 学習データ | 全体 SR(%) | 全体 NDTW |
|---|---|---|---|
| TravelUAV | シミュレーションのお手本 | 56.78 | 0.237 |
| OpenVLA-UAV | シミュレーションのお手本 | 53.85 | 0.345 |
| π0-UAV | シミュレーションのお手本 | 68.86 | 0.431 |
| MemoryVLA-UAV | シミュレーションのお手本 | 62.64 | 0.342 |
| π0.5-UAV | シミュレーションのお手本 | 66.67 | 0.398 |
| FlowVLA(事前学習) | 実機 + シミュレーションのお手本 | 75.58 ± 1.12 | 0.402 ± 0.006 |
| FlowVLA-GRPO | 同上、さらに RL で事後学習 | 92.06 ± 0.56 | 0.434 ± 0.005 |
| FlowVLA-TGRPO | 同上、さらに RL で事後学習 | 93.16 ± 0.42 | 0.424 ± 0.008 |
本記事の図はこのうち 4 行の全体成功率を示しています。π0-UAV 68.86%、事前学習の FlowVLA 75.58%、FlowVLA-GRPO 92.06%、FlowVLA-TGRPO 93.16% です。この表では、次の点を分けて読む必要があります。
- 事前学習の FlowVLA とベースラインは学習データが異なります。5 つのベースラインはすべて同じシミュレーションのお手本だけで模倣学習しており(VLM 部分は LoRA でファインチューニング)、出力は局所座標の「位置 + ヨー角」指令に変換して、同じシミュレータ側のコントローラで実行しています。FlowVLA はこれに加えて実機のお手本も使っています。著者が報告する 6.72 ポイントの差には、データの違いが含まれます。アブレーションの表 5 で、シミュレーションのデータだけで学習した FlowVLA は 73.14 ± 0.56% で、本サイトの計算では π0-UAV より 4.28 ポイント高いままですが、この差にはモデル構造の違いも含まれます。実機のお手本を加えた効果は 2.44 ポイント(73.14% → 75.58%)で、評価自体はすべてシミュレーションの中です。
- 成功率が高くても、軌跡の類似度が高いとは限りません。事前学習の FlowVLA の NDTW は 0.402 で、π0-UAV の 0.431 を下回ります。タスク別では「回転」が 24.44% にとどまり、π0.5-UAV は 66.67% です。「通過」は 55.00% で、MemoryVLA-UAV の 62.50% より低くなっています。
- 事後学習による向上は同じ初期化からの比較で、報告されたばらつきよりはるかに大きいものです。75.58% から GRPO の 92.06%、TGRPO の 93.16% へ、それぞれ 16.48(本サイトの計算)と 17.58 ポイント上がり、「回転」はどちらも 100% に達しています。大きく伸びたのは RL で学習した 4 種類のタスクで、テストも同じシミュレーションのシーンで行われています。
- TGRPO は GRPO より 1.10 ポイント高いだけです。TGRPO と GRPO の標準偏差はそれぞれ 0.42 と 0.56 で、3 回の評価から求めたものです。本サイトが読んだ本文には、貪欲デコーディングのもとで 3 回の評価の間に何を変えたのかが書かれておらず、複数の学習シードでの結果もありません。NDTW はむしろ GRPO のほうが高くなっています(0.434 対 0.424)。著者は図 6 から、TGRPO は約 40 回の更新で全体 SR が 90% を超え、GRPO は約 80 回かかったとも報告しています。「サンプル効率が高い」という主張は、この 1 組の学習曲線に基づいています。
- RL に含めなかったタスクは少し下がります。著者の報告では、GRPO は残りのタスクでいったん下がったあと事前学習時に近い水準まで戻り、TGRPO は学習後半に残りのタスクの平均 SR がわずかに下がりました。その下がり幅は GDPO や DAPO より小さいとされています。同じ初期化から比較したほかのアルゴリズムの全体 SR は、DAPO 82.91%、GSPO 89.13%、GDPO 89.87% です。著者は、DAPO と GSPO の後半の劣化は参照方策に対する KL 正則化を使っていないことと一部関係している可能性があると推測していますが、本サイトが読んだ本文ではこの点を個別に検証していません。
- 構造のアブレーションでは、離散動作ヘッドを FAST ヘッドに置き換えると SR は 64.10% に下がります。Qwen3-VL の全層の特徴を混ぜると 76.19% で、最終層だけの場合より 0.61 ポイント高いだけなので、著者は最終層の特徴を RL の初期化に使っています。
実機での運用:推論は地上局、古くなったウェイポイントは遅延に応じて飛ばす
機体の計算資源が限られるため、VLA の推論は地上局で行います。機体は無線リンクで画像と状態を送り、地上局は動作チャンクを生成してウェイポイントに変換し、機体のフライトコントローラへ送り返します。推論中も機体は飛び続けるので、返ってきたチャンクの最初のいくつかのウェイポイントはすでに古くなっている可能性があります。そこで実行層は、画像取得から指令送信までの実測遅延 δ とウェイポイントの実行周波数 f_c を使い、最初の m = min(H − 1, ⌈δ·f_c⌉) 個のウェイポイントを飛ばします。
本サイトが読んだ本文には、δ と f_c の実測値は書かれていません。仮の値で計算すると、H = 10(論文の設定)で、f_c を 5 Hz、δ = 0.35 s とすれば ⌈1.75⌉ = 2 となり、最初の 2 個を飛ばして 3 個目から実行します。δ = 2.5 s なら ⌈12.5⌉ = 13 が H − 1 = 9 に切り詰められ、残るのは最後の 1 個だけです。5 Hz では 1 つのチャンクは 2 秒分しかないので、遅延がこの長さに近づくと、飛ばしても補えなくなります。動作チャンクの長さと遅延の関係は フィジカルAIラボ 2.6 に手計算の練習があります。
実機の部分は定性的なデモです。屋外の図 7 は π0-UAV(木の左側を通過、標識の右側に接近)、屋内の図 8 は FlowVLA(木の周りを時計回りに周回、標識の左側を通過)です。本サイトが読んだ本文には実機での試行回数や成功率は報告されておらず、要旨の「頑健な実行」や本文の「シミュレーションの定量評価を裏付ける」という表現は著者の記述です。著者は結論で、現在の高頻度の閉ループ制御は地上局の計算と無線通信に大きく依存しており、遅延のリスクがあり機上での自律性も制約されると認めています。今後はモデル圧縮と機上推論に取り組む予定としています。本サイトは別のドローンの手法も紹介しています。イベントカメラによるクアッドロータの障害物回避 で、方策がイベントフレームから加速度を直接出力するもので、言語の指示は扱いません。
制約と注意点
- arXiv のプレプリントで、数値はすべて著者報告 [R] です。本サイトはコードを実行しておらず、データのダウンロードや表の検証もしていません。本サイトが読んだ HTML 本文は結論の節で終わっており、読んでいない付録があるかもしれません。
- 閉ループの成功率はすべて UAV-Flow-Sim の同じキャンパスのシーンでのもので、RL による事後学習もこのシーンで行われています。別のシーンや実機での定量的な成功率はありません。
- ベースラインはシミュレーションのお手本だけで学習し、FlowVLA は実機のお手本も使っているため、事前学習の比較は同じデータでの比較ではありません。
- TGRPO の GRPO に対する 1.10 ポイントの差は、3 回の評価から求めた統計によるものです。本サイトが読んだ本文には複数の学習シードの結果がなく、NDTW は逆の方向を示しています。
- RL は 4 種類のタスクだけを対象にしており、著者は残りのタスクで学習後半にわずかな低下を報告しています。
- 実機飛行は定性的なデモで、屋外のデモはベースラインの π0-UAV によるものです。シミュレーションの結果もこれらのデモも飛行の安全性の検証ではなく、ほかの機種、空域、天候で使えることを示すものでもありません。
- 本文中の 2 つの仮の計算(クリップ付き区間スコアと飛ばすウェイポイントの数)と TGRPO のアドバンテージの小さな表は本サイトの練習で、論文のデータではありません。
リンク
- UAV-Flow++: A Unified Suite for Benchmarking and Learning Language-Guided UAV Flight(arXiv 2611.17163)
- 論文の HTML 全文
- プロジェクトページ(論文に記載)
- コードリポジトリ buaa-colalab/UAV-Flow(論文に記載)
- Hugging Face データセット wangxiangyu0814/UAV-Flow(論文に記載)
- フィジカルAIラボ:すべての数字を確認できるフィジカルAI講座(講座の概要)
- フィジカルAIラボ 1.6:模倣学習――誤差がお手本のカバー範囲からはみ出すまでを手で計算し、ACT・拡散方策・データのスケーリング則の数字をそれぞれの条件に照らして読む
- フィジカルAIラボ 2.6:エッジへ――遅延のログから制御周波数の上限を求め、量子化で減るのが容量か時間かを見分け、動作チャンクの長さを決める
- フィジカルAIラボ 3.3:RL事後学習――HIL-SERL の「2 倍」と RECAP の「処理量 2 倍以上」をそれぞれの条件に戻し、三つのシードの対応のある区間を計算し直す
- フロンティア・レーダー|イベントカメラによるクアッドロータの障害物回避:CUDA のイベントシミュレータを微分可能シミュレーションに組み込み、方策がイベントフレームから加速度を直接出力する


