
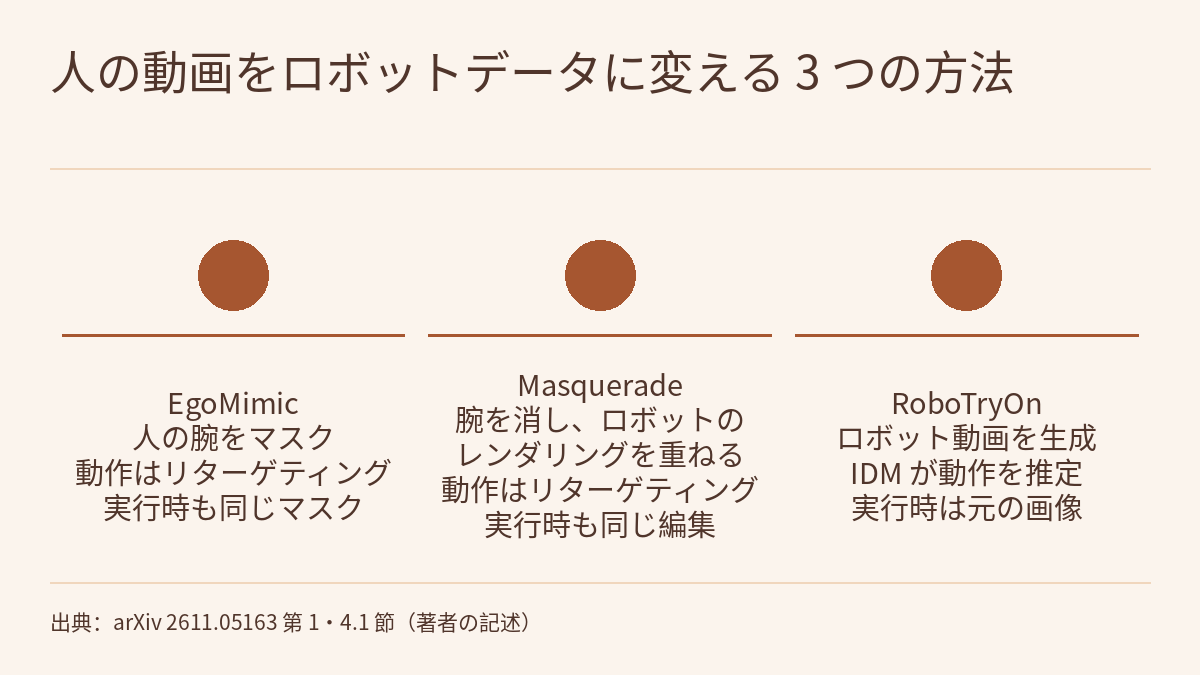
人の動画から多指ハンドを教える一般的な方法は、画面上で人の腕をマスクするかレンダリングしたロボットを重ね、再構成した人の手の姿勢をロボットの関節指令にリターゲティングするものです。プレプリント RoboTryOn(arXiv 2611.05163、2026-11-03)は順序を入れ替えます。まず「バーチャル試着」のように、デモの動き、タスク、物体、背景はそのままにして、画面の人だけを対象ロボットに置き換えたロボット動画を生成します。次に逆動力学モデル(IDM)で、生成した動画から関節の動作ラベルを読み取ります。著者の報告では、多指ハンドを持つ双腕ロボット 2 台で、遠隔操作のデモが一つもない 7 タスクの平均成功率が 2.1% から 60.0% に上がりました。この論文で注目したいのは、「見た目の差」と「動作の差」を別々に測っている点と、「収集コストは約 3 分の 1」が収集の人時だけを数えている点です。以下の数字はすべて著者報告 [R] で、本サイトでは再現していません。
考え方:動きを残し、体を替える
論文は、人の動画とロボットのデモのあいだに 2 つの差があると見ています。見た目の面では、人の動画に映るのは人の腕ですが、実行時の方策が見るのはロボットです。従来の方法は腕をマスクするかレンダリングしたロボットを重ねてこの差を縮めますが、学習時と実行時の両方でロボットのカメラ画像に同じ編集を施す必要があります。動作の面では、再構成した手の姿勢そのものが不正確で、人の手とロボットの手は形態も運動学も異なるため、正確なリターゲティングの写像は存在しません。論文は、仮に写像が完璧でも再現できるのは手の形だけで、どれだけ強く握るべきかは含まれないとも指摘しています。
RoboTryOn の流れは 3 段階です。3 つのモデルと、その後に学習する方策は、いずれも条件付き flow matching で学習します。
- キーフレームの変換:再構成した両手首の軌道からキーフレームを選びます。条件は、両手首の速度がともに極小になり(手がぶれていない)、かつ一方の手首が直前のキーフレームから閾値以上動いていることです。最初と最後のフレームは必ず含めます。画像モデルは人の腕の領域をマスクして手の骨格を描き、参照画像をもとに対象ロボットを描き込みます。各キーフレームは直前に変換したロボットのキーフレームを参照し、最初の参照画像がどのロボットにするかを決めます。マスクは拡大・平滑化され、その輪郭から下にあるのが誰の手かは分かりません。
- 動画の合成:動画モデルが隣り合うキーフレームのあいだを補間し、動きは人の手の骨格の系列で誘導します。学習時には骨格に摂動を加え、ランダムに落とすため、骨格が与えるのは手の大まかな位置と動きだけで、指の細部はモデルが学んだロボットハンドの事前分布から来ます。
- 擬似動作ラベル:IDM は K ステップ離れた 2 枚のフレームから、そのあいだの関節空間の動作チャンクを予測し、遠隔操作データの実際の動作で学習します。状態は、遠隔操作データで測った遅れを使って動作から求めます。IDM は手首の位置を手の再構成ほど正確に推定できないため、著者は逆運動学で手首の位置を再構成値に置き換え、指の関節は IDM の予測を使います。
生成とラベル付けの 3 つのモデルは、ロボットのデータだけで学習します。分布内 4 タスクの遠隔操作デモと、追加のロボット動画(どの方策の学習にも使わない)です。推論時には人の動画から同じマスクと骨格の条件を取り出すので、人とロボットの対になったデモは要りません。
実験設定:ロボット 2 台、卓上タスク 11 種
2 台とも多指ハンドを持つ双腕ロボットです。OpenArm は 7 自由度の腕 2 本と 6 自由度の Inspire RH56F1 ハンド 2 つ、RB-Y1 は 7 自由度の腕 2 本と 20 自由度の WujiHand2 ハンド 2 つを備えます。各ロボットで 11 タスクを評価します。
- 分布内(ピック・アンド・プレース 4 種):PnP Bottle、Doll、Box、Ball。各タスク・各ロボットに遠隔操作デモ 50 本と人の動画 50 本があります。
- 分布外(7 種):各タスクに人の動画 50 本だけがあり、ロボットのデモはありません。内訳は新しい物体 1 つ(PnP Coffee Pot)、新しい目標 1 つ(PnP Bottle to Shelf)、新しいスキル 2 つ(Pouring、Brushing)、両手協調 3 つ(Box Convey、Air Fryer、PnP Ball in Cup)です。遠隔操作のデモはすべて片腕のタスクです。
方策はファインチューニングした π0.5 で、3 通りのデータ構成を同じステップ数で学習します。遠隔操作 200 エピソード(分布内タスクごとに 50)、RoboTryOn が合成した 550 エピソード(11 タスク各 50)、あるいは両方を合わせた 750 エピソードです。各タスクは物体の位置をランダムにして 28 回試行します。比較手法の EgoMimic は人の画像から腕をマスクし、Masquerade は腕を消してリターゲティングした姿勢のロボットのレンダリングを合成します。どちらもリターゲティングした手の動作を使い、それぞれの手順に従って実行時のカメラ画像にも同じ編集を施します。RoboTryOn は元のカメラ画像のまま実行します。
主な結果:分布外 7 タスクがほぼゼロから 73.0% と 46.9% へ
| データ(OpenArm / RB-Y1) | 分布内 4 タスク | 分布外 7 タスク平均 | うち両手 3 タスク |
|---|---|---|---|
| 遠隔操作のみ | 47.3% / 69.6% | 3.1% / 1.0% | 0.0% / 0.0% |
| 遠隔操作 + EgoMimic | 50.0% / 63.4% | 5.1% / 5.1% | 0.0% / 0.0% |
| 遠隔操作 + Masquerade | 67.9% / 63.4% | 8.2% / 7.7% | 0.0% / 0.0% |
| 遠隔操作 + RoboTryOn | 75.9% / 79.5% | 73.0% / 46.9% | 63.1% / 28.6% |
| RoboTryOn の合成データのみ | 57.1% / 60.7% | 48.5% / 40.3% | 38.1% / 16.7% |
要旨の「2% から 60%」は、2 台それぞれの分布外平均をさらに平均した値です。(3.1 + 1.0) / 2 ≈ 2.1、(73.0 + 46.9) / 2 ≈ 60.0 で、両手タスクの 45.9% も同じ計算です。2 台の差は小さくなく、RB-Y1 では両手タスクが 28.6% にとどまります。分母にも注意が必要です。分布外 7 タスクはロボット 1 台あたり計 196 試行で、本サイトの換算では OpenArm の 3.1% と 73.0% はおよそ 6 回と 143 回の成功に当たります。1 タスクだけの列(新しい物体、新しい目標)はロボット 1 台あたり 28 試行しかなく、たとえば新しい目標の 89.3% は 25/28 です。読んだ本文の表 1 には信頼区間がなく、タスクごとの結果は付録 F.2 にありますが、本サイトは読んでいません。
著者はさらに 2 つの確認をしています。アブレーション(OpenArm)では、手の骨格による誘導を外すと分布外が 73.0% から 21.4% に下がり、最も大きな低下でした。最初のキーフレームだけを条件にすると 39.3%、手首の補正を外すと 48.0% です。方策のバックボーンを替えた実験では、構造の異なる VLA の RLDX-1-Img で、分布外が 0.0% から 40.3%、分布内が 53.6% から 60.7% に上がりました。
2 つの差をそれぞれ何で測り、どこまで言えるか
見た目の差:各種の画像を π0.5 の SigLIP 視覚エンコーダで符号化し、実ロボットの画像との Fréchet SigLIP 距離を比べます。RoboTryOn の合成動画は、元の人の動画の 125.5 から 32.7 に下げました。著者によれば、重ね合わせはおよそ半分に、マスクはほとんど変わりません。これは、合成画像が方策自身の特徴空間で実ロボットの画像に近いことを示します。合成動画の接触や物体の動きが物理的に正しいことは示しません。
動作の差:生成した動画には正解の動作がないため、著者は各シーンをシミュレーションで再現した環境で動作ラベルを開ループ再生し、タスクを達成できるかを見ます。ピック・アンド・プレース 3 タスクの計 66 エピソードで、IDM のラベルは 69.7%、手首補正なしは 63.6%、リターゲティングのラベルは 34.8% でした。著者によると差が出るのは主に把持の瞬間で、リターゲティングでは手を物体の近くまで運べても、しっかり握れません。これはシミュレーションでラベルそのものを検証したもので、実機での方策の成功率ではありません。
遠隔操作データと「同じ向き」か:π0.5 の事前学習済み重みで、遠隔操作の分布内データと各分布外タスクのデータそれぞれについて flow matching 損失の勾配を求め、両者のコサイン類似度を計算します。RoboTryOn のデータは 0.53、2 つの比較手法は 0.17 と 0.14 でした。動作エキスパートの部分だけを見ると、RoboTryOn は 0.51、リターゲティングのデータはわずかに負(−0.03、−0.05)です。著者はここから、リターゲティングのラベルが遠隔操作データと食い違う方向に方策を押しており、それが比較手法の分布外での伸び悩みを「説明しうる」と推測しています。これは相関にもとづく説明で、因果の証明ではありません。
「収集コストは約 3 分の 1」が数えているもの
コストの実験は分布内 4 タスクだけで行い、タスクあたりのデモ数を変えて、成功率を収集の人時に対して描きます。著者の報告では、人の動画 1 本の撮影時間は遠隔操作 1 エピソードの約 5 分の 1 です。変換した人の動画だけで、約 3 分の 1 の収集コストでタスクあたり 50 本の遠隔操作デモと同じ成功率に達しました。遠隔操作データに同数の人の動画を加えると、成功率は 47.3% から 71.4% に上がり、追加の撮影は 1 時間足らずです。71.4% はこの規模の実験の値で、表 1 の 75.9% は 11 タスクすべてを含む 750 エピソードの構成なので、同じ設定ではありません。
この計算に入っていないものが 3 つあります。最初の 2 つは論文の制約の節(付録 A)に、3 つ目は 4.1 節「実装の詳細」に書かれています。1 つ目に、生成とラベル付けには計算資源が要り、著者は合成が収集時間を計算資源と引き換えにしていると明言しています。2 つ目に、新しいロボットを加えるたびに、生成モデルと IDM を学習させるため、そのロボットの遠隔操作動画(タスクは問わない)を数時間撮る必要があります。3 つ目に、3 つのモデル自体も分布内タスクの遠隔操作デモで学習しています。したがって「分布外タスクにロボットのデモがない」は成り立ちますが、「システム全体でロボットのデータが要らない」は成り立ちません。
速度も引き継がれます。人のデモは遠隔操作のおよそ 1.25 倍の速さです。骨格の系列を遠隔操作の速度に合わせてから合成すると、分布内は 75.9% から 85.7% に上がり、分布外は 70.4% でした。2 倍速で合成すると方策は最も速くなりますが、両方のタスク群で成功率が下がります(57.1%、42.9%)。
本サイトの既存ページとの関係
フィジカルAIラボ 1.5:データはどこから来る?では、人の動画の難しさは「人の手はロボットの手ではない」ことで、正確な関節角も力も記録されていないと説明しました。RoboTryOn は人の手を直接翻訳せず、まず画素の上でロボットの手に置き換え、そこから IDM に関節を読ませます。力の問題は解決しておらず、著者自身が擬似ラベルでは力を捉えられないと書いています。フィジカルAIラボ 1.6:模倣学習ではお手本のカバー範囲を扱いました。著者は分布内の改善を、まさに合成デモが物体の配置や腕の動きをより広くカバーするためだと説明しています。フィジカルAIラボ 1.8:評価では、まず分母を確かめる練習をしました。本稿の百分率はどれも「どのロボットか、どのタスク群か、タスクあたり 28 回」とあわせて引用すべきです。
リターゲティングを避けようとする研究には フロンティア・レーダー|EgoJEPA もあります。こちらは一人称視点の人の動画から潜在動作を学び、ロボットが変わるたびにアダプターを 1 組加えてファインチューニングします。フロンティア・レーダー|DexStitch も人の動画を多指ハンドのデータに変換しますが、接触に導かれた修復を使います。3 本の論文はロボット、タスク、試行回数がそれぞれ異なるので、成功率を論文間で比べることはできません。
制約と注意点
- arXiv のプレプリントで、数字はすべて著者報告 [R] です。本サイトでは再現していません。著者は KAIST と RLWRLD の所属で、論文は RLWRLD Inc. の支援を受けています。2 つ目のバックボーンに使った RLDX-1 の技術報告の著者にも、本論文の著者 Suhyeok Jang が含まれます。読んだ本文にはコードやデータの公開に関する情報はありません。
- 人の動画はロボットの頭部カメラの位置から撮影され、遠隔操作データではロボットの首と台座が固定されています。著者は、野外の一人称動画のようにカメラが動く場合は動画モデルと IDM の学習分布の外になり、IDM は常に首と台座を動かさない予測をすると書いています。
- 動作は擬似ラベルです。IDM が画素から関節を読み、手首の位置は手の再構成から得ます。力は捉えられず、精度はステレオ動画と手の再構成で分かる範囲に限られるため、きつい挿入のように力や精度に依存するタスクはまだ十分正確にラベル付けできません。手首の補正は頭部カメラの較正に依存します。
- デモの動きはロボットが実行できるものでなければなりません。パイプラインは時間の伸縮はできますが、腕の届かない位置やロボットの手で作れない握り方は直せません。
- 評価はロボット 2 台の卓上操作だけで、タスクあたり 28 回、表 1 に信頼区間はありません。著者は人の動画を GR-1 にも変換しましたが、実機がないため方策は評価できていません。
- コストは収集の人時だけで数えており、生成とラベル付けの計算資源や、新しいロボットごとに必要な数時間の遠隔操作動画は含みません。本稿の結果はハードウェアの安全性検証ではありません。
リンク
- RoboTryOn: Synthesizing Dexterous Robot Demonstrations from Human Videos via Virtual Try-On(arXiv 2611.05163)
- 論文の HTML 全文
- フィジカルAIラボ 1.5:データはどこから来る?――SO-101 のメタデータからお手本の長さを求め、三つの入手ルートの単位と動作空間を見分ける
- フィジカルAIラボ 1.6:模倣学習――誤差がお手本のカバー範囲からはみ出すまでを手で計算し、ACT・拡散方策・データのスケーリング則の数字をそれぞれの条件に照らして読む
- フィジカルAIラボ 1.8:評価――「差し引き +2」を対応表に分解し、失敗ラベルと乱数シードを計算で確かめる
- フロンティア・レーダー|EgoJEPA:人からロボットへのリターゲティングをやめ、一人称視点の人間の動画から潜在動作を学び、ロボットごとにアダプター 1 組を加えて調整する
- フロンティア・レーダー|DexStitch:「遷移」もスキルとしてラベル付けし、人間の動画から多指ハンドのスキルを切り出し、変換し、つなぎ合わせる
- フィジカルAIラボ:すべての数字を確認できるフィジカルAI講座(講座の概要)


