VLA を規模で強くしようとすると、2 つの壁に当たります。動作ラベル付きのロボットのデモは高価で、しかもロボットごとのネイティブな制御量は次元、座標系、意味がそろいません。人間の動画やウェブ動画ははるかに多いものの、対応するロボットの指令がありません。香港具身智能実験室(Hong Kong Embodied AI Lab)、香港中文大学、アリババ DAMO Academy、湖畔実験室などの著者はプレプリント RynnVLA-Latent(arXiv 2610.34356、2026-10-25)で、まず潜在動作モデル RynnLAM を学習し、25 のソースから集めた約 30.1K 時間の人間・ロボット・シミュレーション動画に、7 億 4,552 万個の「潜在動作」記述子を一律に付けました。VLA はまずこの記述子を予測するように学び、最後に対象ロボットのデモで実際の動作につながります。著者は 4B 方策で LIBERO 98.8%、LIBERO-Plus 84.7%、RoboTwin 2.0(Native プロトコル)平均 88.6% と報告しています。本記事では 3 点を読みます。RynnLAM がどんな制約で潜在動作を単なる画像の変化ではなく「制御に関わる動き」に近づけているか。各ベンチマークでのリードの大きさと、その数字が何を測っているか。そして論文でもっとも情報量の多い比較、つまり同じ約 1,000 時間のサブセットで、潜在動作による事前学習と 2 種類の明示的な動作の整合がそれぞれどこで勝るかです。以下の数字はすべて著者報告 [R] で、本サイトでは再現していません。
RynnLAM:608 次元の 1 つの記述子で、動作・局所的な動き・カメラを分ける
潜在動作の考え方は、ネイティブな制御ラベルを使わず、隣り合う 2 フレーム間の変化を代理の動作として符号化することです。著者は、画像の変化にはカメラの動き、静的な見た目、エージェントの制御と無関係な効果も混ざるため、画像をうまく再構成できる表現が低レベルの操作動作の予測に向くとは限らないと指摘します。RynnLAM は Depth-Anything-3 をバックボーンとし、RGB フレームの組を入力として、3 つの部分をつないだ連続の記述子を出力します。
- 8 個の局所運動トークン(8×64 = 512 次元):デコーダーが受け取る唯一のフレーム間の入力で、目標フレームそのものではなく、目標フレームの特徴量がソースフレームからどれだけ変化したか(残差)を予測します。誤差は変化の大きさで正規化されます。
- 大域的な動作潜在(64 次元):ソースのカメラ座標系での動的な 3D シーンフローの予測に使います。疑似ラベルは推定した深度、カメラ姿勢、既製のオプティカルフローから計算し、カメラの動きを補償したあとは静止領域の動的フローがほぼゼロになるはずです。さらに対比損失で、フローで変形したソース特徴が、変形前のソース特徴よりも目標特徴に近くなるよう求めます。
- カメラ潜在(32 次元):2 フレーム間の相対的な 6 自由度のカメラ姿勢を復号します。同時に勾配反転によって、同じ姿勢デコーダーが動作潜在からはカメラ姿勢を読み取れないようにします。
5 つの損失の重みは、再構成・フロー・姿勢が各 5、特徴の対比が 3、勾配反転が 2 です。学習は 2 段階で、エンコーダーを固定して 36K ステップ、固定を外してさらに 20K ステップです。著者の書き方は慎重です。これらの目的はカメラの分離を「促す」ものであり、視点不変性や物理的な識別可能性を保証するものではありません。カメラの分離が働くのは大域的な動作潜在だけで、完全な記述子にはカメラ潜在が残るため、カメラに依存しないとは仮定していません。
プローブの結果。LARY ベンチマークの低レベル制御回帰トラックで、固定した表現と軽量な MLP によってエンドエフェクターの軌跡を回帰します。短いストライドでは、絶対値の目標の一部が画像に見えている現在の姿勢から推測できてしまうため、著者は最初のフレームからのエンドエフェクターの変位を予測する「相対」設定も加えています。完全な記述子の相対平均 MSE は 0.38 で、DreamDojo 0.55、Moto 0.77、LAPA 0.93 より低い値です。ただし相対設定の CALVIN では DreamDojo のほうが良好です(0.35 対 0.40)。構成要素を 1 つずつ外すと、相対平均 MSE はそれぞれ次のように上がります。エンコーダー固定で 0.52、3D フローなしで 0.50、カメラ分岐なしで 0.47、勾配反転なしで 0.49、運動トークンによる残差予測なしで 0.57 です。著者は、このプローブが復元した 3D の動きの正確さを直接測るものではないことも明記しています。
コーパスと 2 段階の学習:事前学習ではネイティブな動作も固有受容も使わない
コーパスは 25 のデータセットからなり、合計約 30,117.68 時間、1,663 万エピソード、30.57 億フレームです。時間で見ると、実ロボットが約 12,038.97 時間、シミュレーションが約 6,139.18 時間、人間のインタラクション動画が約 11,939.53 時間で、それぞれおよそ 4 割、2 割、4 割です。HowTo100M 1 つだけで、実ロボットの全ソースを合わせたよりも多くのエピソードがあります。各クリップには、まず Qwen3-VL で説明文を、DPFlow でオプティカルフローを、Depth Anything 3 で深度を付けます。RynnLAM はオフラインのラベラーとして 4 フレームごとに (0, 4)、(4, 8) のようにフレームの組を取り、7 億 4,552 万個の記述子を生成します。方策の学習では 6 個の記述子で 1 つの予測チャンクを作り、学習インデックスは 1 億 2,106 万サンプル、バッチサイズ 128 で 1 エポックあたり約 94.6 万ステップです。各ソースは設定した重みの 0.7 乗に比例してサンプリングされ、ウェブ動画とロボットのデータの釣り合いを取ります。
方策は Mixture-of-Transformers 構造です。視覚言語バックボーン RynnBrain が多視点の画像と指示を符号化し、バックボーンと同じ層数で隠れ幅が 768 しかない動作エキスパートが、各層でバックボーンと結合注意を行います。「2B」「4B」はバックボーンの規模を指し、動作エキスパートを含む総パラメータ数はそれぞれ 2.51B と 5.04B である点に注意してください。
- 事前学習:flow matching で、ガウスノイズから潜在動作 6 個のチャンクを生成します。条件は多視点の観測と言語で、ネイティブな動作も固有受容も使いません。カメラ構成は 6 つの標準カメラスロットに割り当て、欠けている視点は注意と損失の両方でマスクします。
- 事後学習:同じ flow matching の目的を対象ロボットの動作空間に向け直し、その身体のデモでモデル全体をファインチューニングします。固有受容はこの段階で初めて加わります。潜在動作から動作への専用デコーダーは追加せず、事前学習した読み出しの幹に新しく初期化した薄い射影を 1 層つなぐだけです。異なるロボットは統一した動作レイアウトを共有し、使わない次元はマスクします。
- 推論:Euler ステップでノイズから動作チャンクを積分し、チャンク全体を実行してから再計画します。著者は、実機評価が測るのは閉ループのタスク成功率であり、推論速度は評価指標ではないと明記しています。
ベンチマークの数字の読み方
| ベンチマーク | RynnVLA-Latent-4B | 表中でもっとも強い比較対象 | 読み方 |
|---|---|---|---|
| LIBERO 平均 | 98.8% | Xiaomi-Robotics-0 98.7% | 著者自身が、0.1 ポイントの差は報告スコアの差にすぎず統計的有意性の証拠ではないと述べています。Long スイートでは 2B(97.8%)が 4B(97.0%)を上回ります |
| LIBERO-Plus 総合 | 84.7% | π0.5 84.4% | LIBERO でファインチューニングしたチェックポイントをそのまま評価し、ベンチマーク向けの適応はしていません。カメラの摂動は 72.9% 対 π0.5 の 78.4%、ロボットの初期状態の摂動は 64.0% 対 73.6% で、背景の摂動では StarVLA が上です |
| VLABench 5 トラック平均成功率 | 51.9% | π0.5 48.1% | 4B はすべてのトラックで表中最高の成功率です。常識トラックの進捗スコアと意図スコアは π0.5 がリードします。2B は平均成功率が π0.5 より低い一方、意図スコアは高くなっています |
| RoboTwin 2.0 Native 平均 | 88.6%(クリーン 88.7%、ランダム化 88.4%) | LingBot-VLA 87.7% | Native プロトコルは学習時からランダム化シーンのデモを含み、著者はランダム化シーンへのゼロショット転移ではないと明記しています。ベースラインの数字はそれぞれの報告からの引用です |
| 実機 6 タスク | すべてのタスクで表中最高 | π0、π0.5、GR00T-N1.7 | 双腕プラットフォーム 2 台、各タスク・各設定 35 回の試行。2B の比較では勝ち負けが混在します |
同じ数字に、論文内で 2 つの書き方があります。RoboTwin 2.0 の平均成功率は、要旨と表 6 では 88.6%、序論と結論では 88.3% です。表 6 には、この行の平均はクリーンとランダム化の算術平均だと注記されており、(88.7 + 88.4) ÷ 2 = 88.55 で 88.6% と一致します(本サイトの検算)。88.3% の出どころは、読んだ本文からはわかりません。
実機の百分率を回数に戻す。各タスク 35 回なので、成功 1 回は約 2.86 ポイントに当たります。これで換算すると(本サイトの計算)、Table-Cleaning の π0.5 の 25.71% から 4B の 40.00% は 9 回対 14 回、Steak-Serving の 40.00% から 57.14% は 14 回対 20 回で、Plate-Placement の 4B 85.71% 対 π0.5 82.86% の差はわずか 1 回です。読んだ本文には信頼区間も繰り返し実験もなく、タスクごとのデモ数は付録の表 11 にあり、本記事では読んでいません。実機プラットフォームは、据え置き型の Marvin-WUJI(7 自由度アーム 2 本と 20 自由度の多指ハンド 2 つ、計 54 自由度)と、車輪付き移動型の Astribot-S1(7 自由度アーム 2 本と平行グリッパー)です。結果は対象ロボットで事後学習したあとの性能で、未知の身体へのゼロショット配備ではありません。
同じ約 1,000 時間のサブセット:潜在動作と明示的な動作の整合にはそれぞれ強みがある
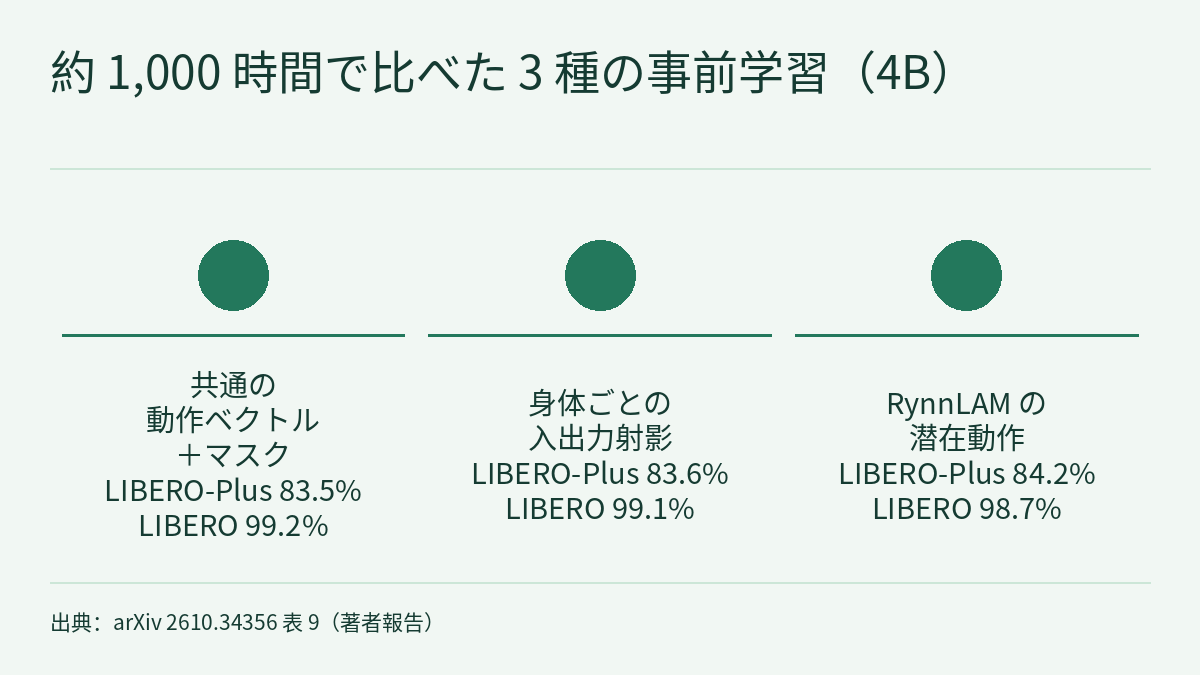
フルスケールの結果には、バックボーン、データ量、教師の種類の影響が混ざっています。これを切り分けるため、著者は約 1,000 時間のサブセット(RoboCOIN、EgoDex、EPIC-KITCHENS、Something-Something)で一連の変種を学習しました。表 9 の行はすべてこのサブセットを使っており、全コーパスでの結果とは直接比べられません。2 つの明示的な整合のベースラインは、ネイティブな動作のない人間の動画に対して、モーションキャプチャから得た手首の姿勢と指先の位置を疑似動作として使っています。
| 事前学習の教師 | 2B LIBERO | 2B LIBERO-Plus | 4B LIBERO | 4B LIBERO-Plus |
|---|---|---|---|---|
| 共通の標準動作ベクトル+マスク | 98.7 | 80.5 | 99.2 | 83.5 |
| 身体ごとの入力・出力射影 | 99.0 | 82.1 | 99.1 | 83.6 |
| LAPA の潜在動作ターゲット | 98.2 | 80.2 | 98.0 | 81.3 |
| RynnLAM の潜在動作ターゲット | 98.1 | 82.3 | 98.7 | 84.2 |
- 傾向は一貫していますが、差は小さいものです。どちらの規模でも、RynnLAM は LIBERO-Plus で最高、LIBERO では 2 つの明示的な整合をいずれも下回ります。著者の解釈は、潜在動作による教師は分布シフト下での頑健性に有利かもしれず、明示的なネイティブ動作の整合は分布内の実行では依然として競争力がある、というものです。ただし RynnLAM が身体ごとの射影を上回る幅は 0.2(2B)と 0.6(4B)ポイントにとどまり、読んだ本文には繰り返し回数も区間もありません。
- ほかの変数。同じサブセットで、RynnBrain バックボーンは Qwen-VL バックボーンより LIBERO-Plus で 3.5(2B)と 4.5(4B)ポイント高く、カメラスロットを外すと 0.4 と 1.3 ポイント、RynnLAM の記述子を LAPA のターゲットに替えると 2.1 と 2.9 ポイント下がります。LIBERO-Plus では、この比較の中で教師の種類どうしの差よりバックボーンによる差のほうが大きくなっています(本サイトによる比較)。
- データ規模。著者はコーパスの 10%、30%、50%、70%、100% で事前学習し、LIBERO-Plus だけで評価しました。どちらの規模も 100% で最高となり、2B は段階ごとに上がる一方、4B は 10% から 30% でわずかに下がってから持ち直します。具体的な値は図 8 にしかなく、本文には書かれていません。なお、4B の LIBERO-Plus は約 1,000 時間のサブセットで 84.2%、全コーパスで 84.7% ですが、両者はデータの構成が異なるため、この 0.5 ポイントを規模の効果の測定とみなすことはできません(本サイトによる比較)。
本サイトのほかの記事との関係
本サイトでは最近、動画から潜在動作を学ぶプレプリントを 2 本取り上げました。フロンティア・レーダー|EgoJEPA は一人称視点の人間の動画だけを使い、手の動きの差分を条件に潜在動作を学び、ロボットごとにアダプターを 1 組加えます。フロンティア・レーダー|SkeLAM はロボットの骨格を使って潜在動作を分け、世界モデルの動作条件に使います。RynnVLA-Latent の新しい点は、人間・ロボット・シミュレーションの 3 種類の動画を 1 つの潜在動作ターゲットにまとめて方策を事前学習し、同じサブセットで明示的な動作の整合と直接比べたことです。3 本の論文はデータ、評価、比較対象が異なるため、数字どうしは比べられません。論文の出発点である「ネイティブな制御量は次元、座標系、意味が異なる」という問題は、フィジカルAIラボ 1.5:データはどこから来る? で扱った動作空間と照らして読めます。「動作チャンクを 1 つ生成し、全体を実行してから再計画する」点は、フィジカルAIラボ 1.6:模倣学習 の動作チャンク化と関係します。0.1〜0.6 ポイントの差や、各タスク 35 回の実機結果は、フィジカルAIラボ 1.8:評価 の方法で読むことができます。
制約と注意点
- arXiv のプレプリントで、数字はすべて著者報告 [R] です。本サイトでは再現していません。読んだ本文には信頼区間も複数シードの結果もありません。シミュレーションのベンチマークのベースラインはそれぞれの報告からの引用で、評価条件が完全に一致しているとは限りません。
- RoboTwin 2.0 の平均成功率は論文内で 88.6% と 88.3% の 2 通りに書かれています。本記事では表 6 と要旨に従い 88.6% としました。
- 3D フローの疑似ラベルは、既製のモデルが推定した深度、姿勢、オプティカルフローに由来します。LARY のプローブが測るのは制御の予測可能性で、3D の動きの計量的な精度ではありません。方策が予測した潜在動作をフローデコーダーで可視化した結果についても、著者は定性的な解釈にとどまるとしています。
- カメラの分離は大域的な動作潜在にだけ働き、完全な記述子にはカメラの情報が残ります。LIBERO-Plus でも、カメラとロボットの初期状態の摂動では π0.5 を明らかに下回ります。
- 事後学習には依然として対象ロボットのデモが必要です。実機の結果は事後学習後の閉ループ成功率で、各タスク 35 回、推論速度は評価しておらず、ハードウェアの安全性検証でもありません。
- 本記事が依拠したのは論文 HTML の本文の結論までで、付録(データ収集、疑似動作の実装、表 11 など)は含みません。読んだ本文には学習に使った計算資源や時間の記載がありません。論文にはプロジェクトページと GitHub、Hugging Face、ModelScope のリンクが記載されていますが、コードや重みが公開されているかどうかは本サイトでは確認していません。
リンク
- RynnVLA-Latent: Scaling Robotic Manipulation Foundation Models with 3D-Grounded Latent Actions(arXiv 2610.34356)
- 論文の HTML 全文
- フロンティア・レーダー|EgoJEPA:人からロボットへのリターゲティングをやめ、一人称視点の人間の動画から潜在動作を学び、ロボットごとにアダプター 1 組を加えて調整する
- フロンティア・レーダー|SkeLAM:ロボットの骨格で潜在動作を「アームの動き」と「シーンの変化」に分け、ロボットの動作は前者だけにつなぐ
- フィジカルAIラボ 1.5:データはどこから来る?――SO-101 のメタデータからお手本の長さを求め、三つの入手ルートの単位と動作空間を見分ける
- フィジカルAIラボ 1.6:模倣学習――誤差がお手本のカバー範囲からはみ出すまでを手で計算し、ACT・拡散方策・データのスケーリング則の数字をそれぞれの条件に照らして読む
- フィジカルAIラボ 1.8:評価――「差し引き +2」を対応表に分解し、失敗ラベルと乱数シードを計算で確かめる
- フィジカルAIラボ:すべての数字を確認できるフィジカルAI講座(講座の概要)