マルチモーダル大規模モデルに高レベルの計画を任せたときの誤りの一つを、論文は例で示しています。何をすべきかは分かっていても、ある行動をいつ実行できるかが分かっていないという誤りです。物を冷蔵庫に入れるべきだと分かっていても、扉が閉じたまま「中に入れる」を実行してしまいます。著者らは、こうした前提条件の違反が長い実行の中で積み重なり得ると指摘しています。華東師範大学、北京智源人工知能研究院(BAAI)、西北工業大学、中国科学院大学人工知能学院、中国科学院自動化研究所の著者らはプレプリント CausGround(arXiv 2610.29702、2026-10-21)で、モデルをファインチューニングせずにこの問題に取り組みました。相互作用の軌跡から各行動の前提条件と効果を導き、再利用できる知識として蓄え、計画時には現在の観測に照らしてタスクに関係する部分を選び、パラメータを凍結したプランナーに渡します。著者らは、3 つの Qwen3.5 バックボーンで、改変版 VirtualHome の平均タスク成功率が 24.9% から 53.3% に、RoboCasa の閉ループ再計画の成功率が 43.0% から 57.0% に、SWITCH の相互作用推論の平均正答率が 25.8% から 31.9% に上がったと報告しています。本記事では 2 点を詳しく読みます。知識がどのように層状に組み立てられているか、そして 3 つのベンチマークがそれぞれどう改変され、どう採点されたかです。後者が、数字がどこまでを示すかを決めるからです。数字はすべて著者報告 [R] で、本サイトでは再現していません。
課題:既存の 2 つの適応方法にはそれぞれ欠けている部分がある
論文は、環境への適応の既存手法を 2 つに分けています。パラメトリックな適応は、ファインチューニングや強化学習で環境の経験をモデルに書き込みます。環境固有の相互作用データと繰り返しの最適化を大量に必要とし、環境が変わるたびにやり直しになるため、実環境では特にコストがかかります。ノンパラメトリックな適応は、推論時に実行フィードバックやエピソード記憶を加えますが、経験は軌跡全体やタスク単位の記憶として保存されることが多く、ある経験のどの部分が成否と因果的に結びつき、どの部分がたまたま現れただけなのかを見分けにくく、タスクをまたいで再利用することや現在の画像に結びつけることも難しくなります。著者らはさらに、既存の状態表現は細かな物体の属性と物体どうしの関係を両方とも捉えているとは限らず、行動の前提条件が満たされているかを判断するには両方が必要だと指摘しています。
CausGround が答えようとする問いは、相互作用の経験を「行動の前に何が成り立っていなければならないか」と「行動の後に世界がどう変わるか」の両方を教える再利用可能な知識に蒸留できるか、というものです。論文の事例では、ベースラインのプランナーは座るべき椅子を正しく見つけたものの、NEAR(近くにいる)という前提条件を満たさないまま SIT を繰り返しました。CausGround は因果知識から欠けている前提ステップを見つけ、タスクを完了しました。
手法:1 つの分解された状態表現で観測・知識・計画をつなぐ
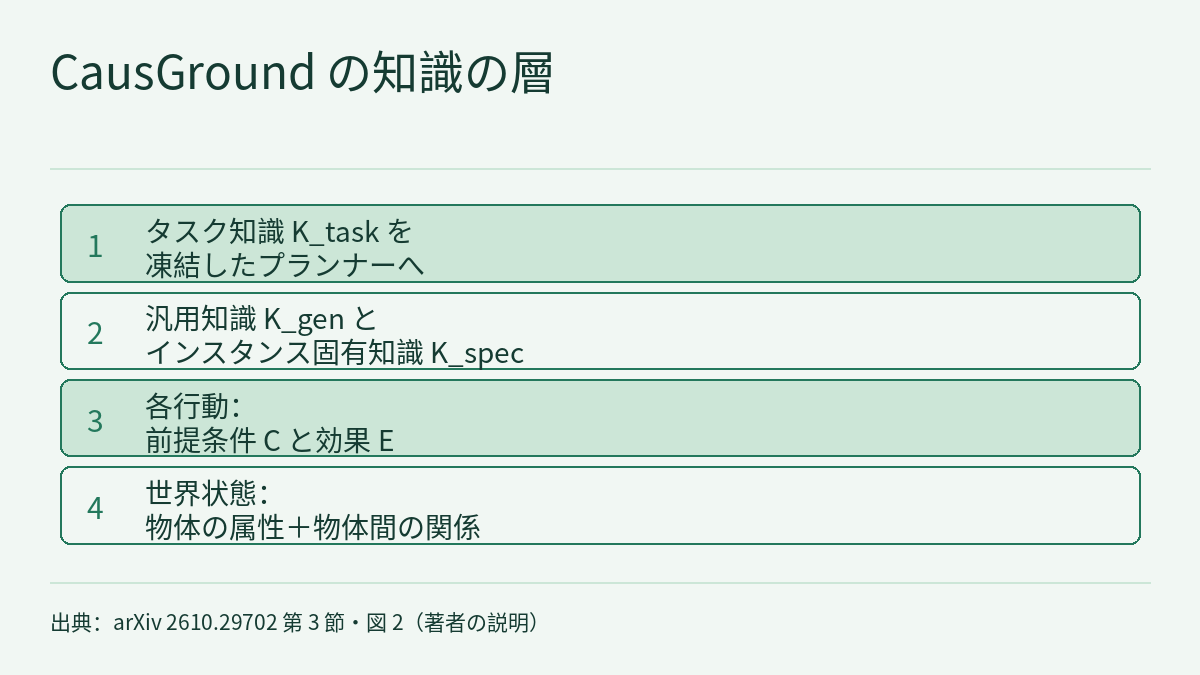
分解された世界状態。RGB 観測 1 フレームから、凍結したマルチモーダルモデルが世界状態 S_t = (O_t, R_t) を取り出します。O_t はシーン内の物体の集合で、各物体は意味カテゴリと属性–値ペアの集合で表されます(付録の例ではコップに graspable=true、color=blue)。R_t は物体間の型付きの関係の集合で、ON(cup, table)、INSIDE(cup, fridge)、NEAR(robot, cup) などです。属性–値ペアと関係の一つ一つが個別に識別できる状態因子で、何らかの行動の前提条件にも効果にもなり得ます。観測と知識が同じ形式を使うので、前提条件を現在の状態と項目ごとに直接照合できます。
行動ごとに前提条件と効果を導く。行動ファミリー(GRAB、OPEN など)ごとに、実行前の候補因子を制御して変化させた条件で相互作用の軌跡を集めます。各記録には実行前の状態、接地された行動とその引数、実行後の状態、実行結果が含まれます。接地された行動 a(x) ごとに、満たされているかどうかで成功と失敗を一貫して分ける実行前の因子を前提条件集合 C(a(x)) として残します。成功した実行の前後の状態を比べ、行動の後に一貫して起こる変化を効果集合 E(a(x)) として残します。偶然現れた因子や変化は捨てます。ある行動の効果が別の行動の前提条件を満たすとき、両者は因果依存でつながり、多段階の相互作用はこの依存の組み合わせとして構成されます。
汎用知識とインスタンス固有知識。同じ行動ファミリーの異なるインスタンスどうしをさらに比較します。複数のインスタンスに共通する前提条件と効果は汎用知識 K_gen(a) にまとめ、特定の物体にだけ成り立つものはインスタンス固有知識 K_spec(a(x)) として残します。論文の例では、OPEN(fridge) と OPEN(microwave) は「openness が open になる」という効果を共有し得る一方、実行が成功するにはそれぞれ異なる物体固有の前提条件が必要です。
タスクへの接地と計画。各タスクの開始時に、CausGround はタスク記述 g を同じ形式の目標状態に解釈し、目標から効果と前提条件をたどって逆向きに推論し、目標に向けた因果依存 K_causal を得ます。並行して、知識ライブラリから関連する汎用知識とインスタンス固有知識を意味的に検索し、K_sem とします。両者を合わせた K_task = K_causal ∪ K_sem は、タスクごとに 1 回だけ構築されます。その後の各ステップで、凍結したプランナーは現在の画像 I_t、構造化状態 S_t、タスク記述 g、K_task から次の行動を選びます:a_t = π_θ(I_t, S_t, g, K_task)。前提条件に対する逆向きの推論で今実行できる行動を特定し、効果に対する順向きの推論で状態がどう変わるかを予測します。論文はこれを世界モデル手法と区別しています。世界モデルは行動の結果を予測できますが、行動の条件を明示的に表すとは限らず、複数の行動間の依存は通常、ロールアウトを繰り返して初めて得られます。CausGround は条件、効果、行動をまたぐ依存を、知識として直接プランナーに渡します。
3 つのベンチマークはそれぞれどう改変され、どう採点されたか
各比較では、すべての手法が同じプランナーのバックボーン、視覚観測、タスク記述、高レベルの行動空間を使い、プランナーのパラメータは評価を通じて凍結されています。主実験のバックボーンは Qwen3.5-9B、Qwen3.5-27B、Qwen3.5-35B-A3B です。比較対象は、補助を何も加えない Vanilla プランナーと、同じインターフェースに合わせて改変した SelfReVision(計画の批評・修正・検証を繰り返す)と LookPlanGraph(視覚観測から動的に更新されるシーン記憶グラフを保持する)です。
| ベンチマーク | 著者らによる改変 | 採点 | 数字を読むときの注意 |
|---|---|---|---|
| VirtualHome | 画像ベースの閉ループ高レベル計画に変更:75 タスクを参照行動数で Short(3–6)、Medium(7–10)、Long(11–22)に 25 タスクずつ分割。6 シーン、33 種類の行動。各ステップで RGB 3 視点。フィードバックは SUCCESS/FAILURE のみで、失敗理由は与えない | 成功率(SR)と最終進捗(P)、3 区分のマクロ平均。行動の試行予算は 20、40、60 回で、失敗した試行も予算を消費する。参照行動列の再現は求めない | シミュレータの状態と合わないネイティブ描画は Qwen-Image-Edit-2511 で修復し、決定論的なルールと目視による確認を経たものだけを残す。どの手法も修復後の画像を見る。1 区分 25 タスクなので、1 タスクが 4 ポイントに当たる |
| RoboCasa | Target Composite タスクを使い、公式に注釈されたスキル段階を原子的な行動として扱い、8 つの高レベル API(NAVIGATE、PICK、PLACE、OPEN、CLOSE、PRESS、ROTATE、TILT)に抽象化。シミュレータの観測を中間状態として使う | 一括計画(最大 40 行動)と閉ループ再計画(最大 25 回の試行)でのタスク成功率 | 予測した計画を公式に記録された遷移に照らして再生する。記録された遷移と一致する行動だけが SUCCESS で、公式の軌跡に対応する分岐がない行動は UNKNOWN になる。100 件のホールドアウト・テストケースから出発し、どの手法も UNKNOWN に当たらなかった共通部分集合だけで比較する。読んだ本文には部分集合の大きさが書かれていない |
| SWITCH | 元のタスクとプロトコルは変えず、4 つのサブタスクを使用:Action(442 例)、Recovery(38 例)、Verification Action(63 例)、Verification State(225 例)、計 768 例 | サブタスクごとの正答率。総合スコアは 4 つのマクロ平均 | マクロ平均では 38 例の Recovery が 442 例の Action と同じ重みを持つ。Recovery では 1 例がおよそ 2.6 ポイントに当たる |
RoboCasa の再生による採点には直接の帰結があります。妥当でも公式の記録にない別の計画は判定できず、そうしたケースは丸ごと除外されます。したがって RoboCasa の数字が測っているのは、公式の軌跡がカバーする分岐の中で正しい行動を選ぶ力であり、シミュレータで低レベルの操作を実際に実行した結果ではありません。
結果:平均値の下にあるいくつかの細部
下の表は、バックボーンごとに Vanilla と CausGround を並べたものです(論文の表 1・表 2 から。最後の行は 3 つのバックボーンの平均で、著者らが本文で示した値です。本サイトで表から検算し、一致を確認しました)。
| バックボーン | VirtualHome 平均 SR | RoboCasa 一括計画 | RoboCasa 再計画 | SWITCH 平均 |
|---|---|---|---|---|
| Qwen3.5-9B | 10.7 → 44.0 | 31.0 → 45.1 | 36.7 → 46.9 | 27.7 → 32.9 |
| Qwen3.5-27B | 33.3 → 62.7 | 27.9 → 27.9 | 57.8 → 75.0 | 27.9 → 35.2 |
| Qwen3.5-35B-A3B | 30.7 → 53.3 | 21.9 → 43.8 | 34.4 → 49.2 | 21.7 → 27.7 |
| 平均 | 24.9 → 53.3 | 26.9 → 38.9 | 43.0 → 57.0 | 25.8 → 31.9 |
- 向上が最も集中しているのは VirtualHome です。平均最終進捗は 38.4% から 71.3% に上がりました。Qwen3.5-9B の Long 区分の成功率は 0.0% から 20.0% で、1 区分 25 タスクで数えると 0 タスクから 5 タスクです(本サイトの換算)。最も強い比較対象の LookPlanGraph は Qwen3.5-27B で平均 SR 56.0% で、CausGround の 62.7% との差は 6.7 ポイントです。このバックボーンの Short 区分では両者とも 84.0% です。
- RoboCasa ですべてに勝っているわけではありません。著者らの表現は「ほとんどのバックボーンとプロトコル設定で」最も強い、です。Qwen3.5-27B の一括計画では CausGround と Vanilla がともに 27.9% で、向上はありません。
- 推論や構造を足せば良くなるとは限りません。2 つの比較手法は RoboCasa で Vanilla を下回ることがあり、たとえば Qwen3.5-35B-A3B の再計画では SelfReVision が 4.9%、Vanilla が 34.4% です。著者らの分析では、自由形式の自己内省は存在しない前提を作り出し(物体が戸棚の中にあると誤って推論し、不要な OPEN を挿入する)、離散的なシーングラフは認識の誤りを後の判断に伝えます(閉じた電子レンジを開いていると読み、必要な行動を飛ばす)。
- SWITCH のマクロ平均での向上は、主に 2 つの小さなサブタスクから来ています。Verification State の向上は 0.9–2.6 ポイントにとどまり、Qwen3.5-35B-A3B の Action は 27.1% から 27.4% です。例数に換算すると(本サイトの計算)、Qwen3.5-27B の Verification Action の 36.5% から 52.4% への向上は 63 例中およそ 10 例の正解増、Qwen3.5-9B の Recovery の 36.8% から 44.7% への向上は 38 例中およそ 3 例の正解増です。ただし正解の例数で数えると、大きなサブタスクである Action の増加も小さくありません(本サイトの換算)。Qwen3.5-9B の 24.2% から 28.1%(+3.9 ポイント)は 442 例中およそ 17 例の正解増、Qwen3.5-27B の +1.8 ポイントはおよそ 8 例の正解増で、同じモデルの Verification Action でのおよそ 10 例に近い値です。SWITCH での比較は Vanilla とだけで、絶対的な正答率もまだ 3 割前後です。
- 2 つの構成要素の役割。構成要素のアブレーションでは、Vanilla が SR 33.3%・進捗 46.9%、分解された状態だけを加えると 36.0%・55.1%、因果知識だけを加えると 53.3%・70.8%、CausGround 全体では 62.7%・79.8% です。読んだ本文には、このアブレーションの環境とバックボーンが書かれていません。最初と最後の行は、表 1 の Qwen3.5-27B の VirtualHome 平均値と一致します(本サイトでの照合)。この数字からは、向上の大部分は因果知識によるもので、構造化状態単独では主に進捗が上がっています。
- モデルファミリーをまたいだ検証。著者らは Qwen3.5、InternVL3.5、Gemma4 の 3 ファミリー、E4B から 38B までの 6 モデルでも試し、平均 SR が 23.3% から 50.7% に、最終進捗が 38.4% から 67.3% に上がったと報告しています。読んだ本文では図で示されており、モデルごとの数値表はありません。
実機の部分は 1 件の実演だけです。タスクと初期観測が与えられると、マルチモーダルモデルが目標状態を解釈し、CausGround が逆向きに推論して Open(Microwave)、Pick(Bread)、Place(Bread, Plate) の 3 つの実行可能な行動を導きました。読んだ本文には実機の試行回数も成功率もなく、これらの高レベル行動をどの低レベルスキルが実行するのかも書かれていません。著者らは詳細を付録 E に記したとしていますが、本記事が依拠したテキストにはその部分が含まれていません。
本サイトの他の記事との関係
CausGround は、フィジカルAIラボ 0.3:見る・考える・動くでいう「考える」のうち、遅いほうの層に位置します。出力は高レベルの行動列で、関節への指令ではありません。前日のフロンティア・レーダー|SLoSaも行動の前提条件を扱いますが、方向は逆です。そちらでは前提条件が PDDL のドメインに書かれ、形式検証器がそれを確かめ、検証結果を報酬としてモデルのパラメータを更新します。CausGround はパラメータを更新せず、前提条件と効果を相互作用の軌跡から導きます。どちらも VirtualHome の改変版を使っていますが、タスク、観測、指標が異なるため、数字は比べられません。同じ日のフロンティア・レーダー|GPT-GEARが扱うのは、汎用のマルチモーダルモデルがツールを通じてロボットアームを直接制御することで、別の層の問題です。VirtualHome の 1 区分 25 タスクや SWITCH のサブタスク 38 例といった小さな標本での差の読み方は、フィジカルAIラボ 1.8:評価の方法と照らし合わせてください。
制約と注意点
- これは arXiv のプレプリントで、数字はすべて著者報告 [R] です。本サイトでは再現していません。読んだテキストには信頼区間、繰り返し回数、乱数シードがありません。論文は要旨の後にプロジェクトページのアドレス causground.github.io を挙げていますが、読んだテキストにはコードや知識ライブラリを公開するのか、どこで公開するのかが書かれていません。本サイトは執筆時にこのプロジェクトページを開いて内容を確認できなかったため、コードやライブラリが提供されているかは確認できていません。
- 知識ライブラリの構築について、読んだ本文は原理しか示していません。軌跡は候補因子を制御して変化させた条件で集められますが、どの環境で、何本集めたのか、ライブラリが評価環境と同じ環境から得られたのか、構築にどれだけのコストがかかったのかは、著者らによれば付録 C にあり、本記事が依拠したテキストには含まれていません。これらの情報が、「パラメータ更新が不要」で実際にどれだけ節約できるかを決めます。
- 分解された世界状態は、凍結したマルチモーダルモデルが画像から取り出します。著者らは LookPlanGraph がシーン認識の誤りを伝えると指摘していますが、CausGround も取り出された状態に依存しており、読んだ本文には状態抽出の正確さが報告されていません。
- VirtualHome の画像は画像編集モデルで修復され、ルールと目視で確認されています。これはすべての手法に共通ですが、改変版での結果を元の VirtualHome でのテキストベースや記号的な計画の結果と直接比べることはできません。RoboCasa は公式記録に照らした再生で採点され、UNKNOWN のケースは除外されるため、測っているのは高レベルの行動選択で、低レベルの操作の実行ではありません。
- SWITCH の総合スコアはマクロ平均で、Recovery(38 例)と Verification Action(63 例)は Action(442 例)と同じ重みを持ちます。「およそ 10 例」「およそ 3 例」「およそ 17 例」「およそ 8 例」「0 タスクから 5 タスク」は、本サイトが例数から換算した値です。
- 実機の部分は成功率のない 1 件の実演です。ハードウェアの安全性検証ではなく、シミュレーションで得た知識が実環境に確実に移ることを示すものでもありません。
- 論文の AI 利用に関する声明によれば、AI ツールは原稿の言語の推敲と、改変版 VirtualHome の構築の補助(上記の画像修復)に使われ、結果は著者らが確認しています。
リンク
- CausGround: Causal Interaction Grounding for Adaptive Embodied Planning(arXiv 2610.29702)
- 論文の HTML 全文
- フィジカルAIラボ 0.3:見る・考える・動く――3 つの周波数をそれぞれのシステムに戻す
- フィジカルAIラボ 1.8:評価――「差し引き +2」を対応表に分解し、失敗ラベルと乱数シードを計算で確かめる
- フロンティア・レーダー|SLoSa:形式検証器が決まった順序で計画を 5 つの結果に分けて報酬区間を定め、4B–14B のタスクプランナーを Jetson Orin 上で INT4 によりローカル実行する
- フロンティア・レーダー|GPT-GEAR:動作方策を学習せず、GPT-6 Astra が 5 つのツールでロボットアームを直接制御――深度・触覚・デモは渡すかどうかより、どう渡すか
- フィジカルAIラボ:すべての数字を確認できるフィジカルAI講座(講座の概要)