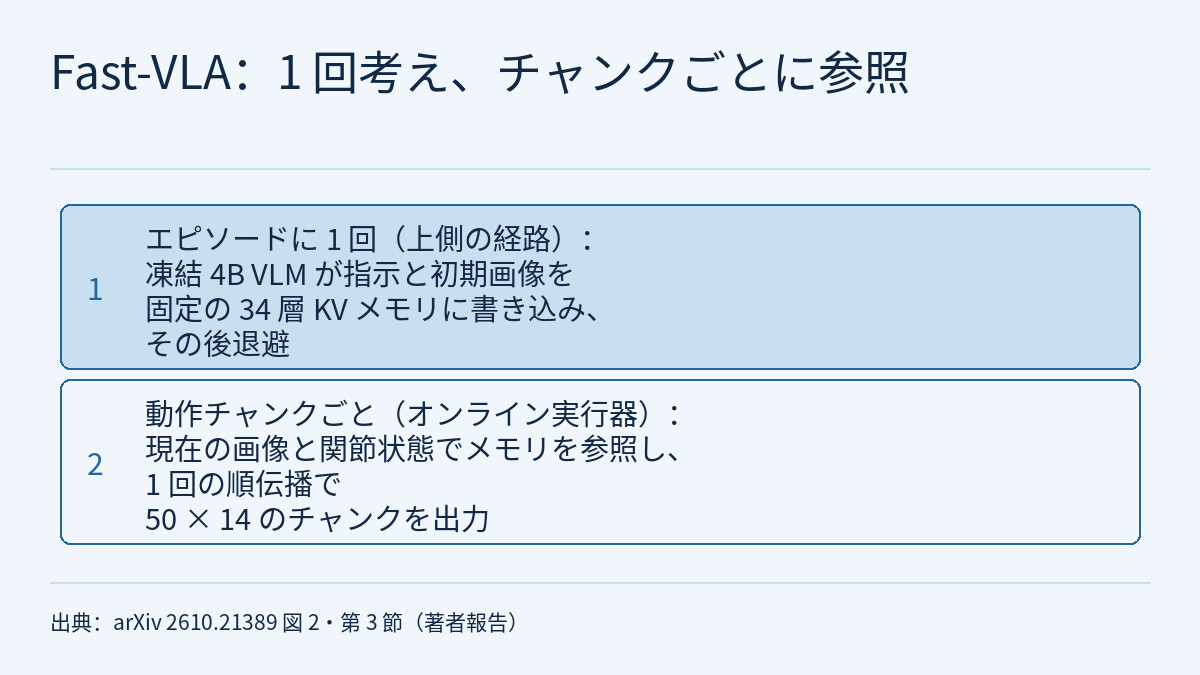
多くの VLA は動作チャンクを 1 つ予測するたびに、現在の画像と言語指示を数十億パラメータのバックボーンに通し直します。しかし、1 つのエピソードの中でタスクそのものはほとんど変わりません。Huawei のチームによるプレプリント Fast-VLA(arXiv 2610.21389、2026-10-15)は、この 2 つを切り分けます。エピソードの開始時に凍結した 4B VLM を 1 回だけ実行し、指示と初期の多視点画像を 34 層のキー・バリュー(KV)タスクメモリに符号化したあと、VLM は制御ループから外れます。以降は動作チャンクごとに、軽量なオンライン実行器が現在の画像と関節状態を使ってこの固定メモリを参照し、1 回の順伝播でチャンク全体を出力します。著者報告では、RoboTwin 2.0 の Clean / Randomized で成功率 92.46% / 92.40%、LIBERO と LIBERO-Plus で 95.95% / 79.11% です。同一ハードウェアでの比較では、RoboTwin の償却推論時間がバックボーンを呼び続ける 3 つのベースラインより 10.9–17.1 倍短く、VLM を退避したあとのオンライン常駐メモリは 1.22 GiB です。以下では、それぞれの倍率が何と比べたものか、実行器が本当にそのメモリに依存しているか、そして「1 回だけ考える」ことで何を手放しているかを見ます。数字はすべて著者報告 [R] で、本サイトでは再現していません。論文の実験はすべてシミュレーションのベンチマークで行われています。
手法:遅い部分はエピソードに 1 回だけ
エピソードの開始時、凍結した VLM が指示 L と初期の多カメラ画像 I_0 を読み込み、タスクメモリ M_0 を作ります。著者は DM0.5(Dexmal Team)の 4B VLM を使い、34 個すべての Transformer 層のキーとバリューのテンソルを保持します。このプリフィルのあと VLM は退避され、メモリはエピソードの終わりまで更新されません。付録によると、RoboTwin の構成ではこの再利用可能なメモリが 1.22 GiB のオンライン常駐メモリのうち 174.6 MiB を占めます。
オンライン実行器は、視覚エンコーダー、クエリ融合、動作デコーダー、動作ヘッドからなります。RoboTwin の構成は次のとおりです。
- ライブ入力:現在のヘッドカメラと 2 台の手首カメラの画像、ヘッドカメラの短い履歴(オフセット −17、−8、0 フレーム)、ロボットの状態。カメラごとに学習可能な DINOv2 ViT-B/14 エンコーダーを 1 つずつ持ちます。
- クエリ融合:未来の各ステップ τ(0–49)と各アームに 1 つずつ学習可能なクエリを置き、時間埋め込みとアーム埋め込みの和とします。各アームの 7 次元の固有受容状態と、その側の手首画像の CLS トークンを MLP で融合してフィードバックとし、ゲート付き残差でクエリに加えます。同じフィードバックは以降の各デコーダー層の前にも再注入されます。
- 動作デコード:4 層のデコーダーで、各層は自己注意(時間ステップと 2 本のアームの協調)、Cross-Visual 注意(現在と履歴の画像トークンの読み取り)、Cross-Memory 注意(固定メモリからのタスク文脈の取得)、フィードフォワードネットワークをこの順に適用します。Cross-Memory 注意の中では KV メモリアダプターが、デコーダー層ごとに 34 のメモリ層に対する softmax の重みを学習します。初期値は深さが対応する層を重視するよう設定されています。
- 出力:線形の動作ヘッドが、1 回の順伝播で 50 × 14 の双腕動作チャンク(50 ステップ分の絶対関節指令)を出力します。反復的なデノイズは行いません。単腕の LIBERO 構成は 10 × 7 を出力し、画像履歴は使いません。
学習で更新するのは実行器(視覚エンコーダーを含む)だけで、正規化した動作に対する ℓ1 損失を使います。VLM は凍結し、その KV キャッシュは事前にオフラインで計算して学習中に再利用します。動作デコーダーと動作ヘッドはゼロから学習し、外部の動作データによる事前学習は行っていません。学習可能なパラメータは RoboTwin で 272.0M、LIBERO で 184.7M、学習計算量はそれぞれ約 150 と約 5 アクセラレーター時間です。
推論では、エピソードごとに VLM のプリフィルが 1 回、その後は動作チャンクごとに実行器の呼び出しが 1 回です。著者が報告する償却レイテンシは環境ステップあたりの平均で、(T_prefill + ⌈H / K⌉ · T_actor) / H です。H は実行したステップ数、K はチャンク長で、観測されたエピソード長を使って計算します。
10.9–17.1 倍は何と比べたものか
次の表は論文の表 2(RoboTwin 2.0)の抜粋で、X-VLA、LingBot-VLA、Qwen-VLA、Motus、Flash-WAM の 5 行(いずれも平均成功率 90% 未満)を省いています。「予測/実行」は 1 回の呼び出しで予測するステップ数と、再計画までに実行するステップ数です。ms/チャンクは 1 回の動作生成呼び出しの時間、ms/ステップは実行スケジュールに沿って償却し、エピソードごとに 1 回の処理も含めた値です。
| 手法 | 予測/実行 | ms/チャンク | ms/ステップ | GiB | 平均成功率(%) |
|---|---|---|---|---|---|
| π0 | 50/50 | 72.38 | 1.580 | 6.26 | 62.16(集計) |
| π0.5 | 50/50 | 80.51 | 1.758 | 6.47 | 79.75(集計) |
| LingBot-VLA 2.0 | 50/25 | 931.29 | 38.892 | 11.98 | 93.16 |
| DM0.5 | 50/50 | 736.10 | 16.069 | 11.68 | 93.45 |
| LingBot-VA | 32/32 | 9553.12 | 317.765 | 29.59 | 92.20(集計) |
| Fast-WAM | 32/24 | 564.80 | 24.624 | 23.13 | 91.83 |
| AHA-WAM(ms/チャンクは 2 チャンクごとに 1 回の 111.40 ms の動画プリフィルを含まず、ms/ステップには含む) | 16/16 | 553.27 | 39.291 | 28.21 | 92.80 |
| Faster-WAM(Noah、コスト計測用に著者が実装) | 32/24 | 119.94 | 5.229 | 21.34 | 89.17 |
| Faster-WAM(HUST) | 32/28 | 416.12 | 15.704 | 22.27 | 92.52 |
| Fast-VLA | 50/50 | 44.87 | 1.437 | 1.22 | 92.43 |
Fast-VLA の最初のチャンクは 153.74 ms(VLM プリフィル 108.87 ms + 実行器 44.87 ms)、以降のチャンクは 44.87 ms です。RoboTwin の平均エピソード長は 237.3 ステップで、償却すると 1.437 ms/ステップになります。論文本文の記述は、表のうち平均成功率が 90% 以上でコストの実測値があるベースラインに対し、Fast-VLA の償却推論は少なくとも 10.9 倍速い、というものです。該当するベースラインは LingBot-VLA 2.0、DM0.5、LingBot-VA、Fast-WAM、AHA-WAM、Faster-WAM(HUST)の 6 つです。要旨と結論の 10.9–17.1 倍は、このうち 3 つ(要旨では「バックボーンを呼び続ける 3 つのベースライン」)だけを取った範囲です。Faster-WAM(HUST)より 10.9 倍速く成功率は 0.09 ポイント低い、DM0.5 より 11.2 倍速く 1.02 ポイント低い(どちらも再計画間隔は 50 ステップ)、Fast-WAM より 17.1 倍速く 0.60 ポイント高い、という内訳です。残る 3 つの倍率はさらに大きく、表の ms/ステップから計算すると LingBot-VLA 2.0(38.892)、AHA-WAM(39.291)、LingBot-VA(317.765)はそれぞれ Fast-VLA の約 27 倍、27 倍、221 倍です(本サイトによる計算)。つまり 17.1 倍はこの 6 つの中での上限ではありません。論文はさらに、Faster-WAM(Noah)に対して 3.6 倍速く、成功率が 3.26 ポイント高いと報告しています。
この倍率の範囲には注意が必要です。同じ表の π0 と π0.5 も 1 回に 50 ステップを実行し、償却レイテンシは 1.580 と 1.758 ms/ステップで、Fast-VLA より約 1.1 倍と 1.2 倍遅いだけです(本サイトによる計算)。ただし平均成功率は大きく下回ります(62.16% と 79.75%)。つまり「少なくとも 10.9 倍」は平均成功率 90% 以上のベースライン群にだけ当てはまり、あらゆる VLA に対する高速化ではありません。
計測条件は付録の表 11 にあります。VLM は BF16、実行器は BF16 autocast で勾配計算を無効化、バッチサイズ 1、3 回のウォームアップのあと 10 回計時して平均を報告し、各計時の直前と直後にデバイスを同期します。計時は生の uint8 画像から始まり、リサイズ、正規化、ホストからデバイスへの転送を含みます。PyTorch 2.7.1+cu128 を使い、torch.compile や TensorRT は使わず、HTTP 通信は含みません。本サイトが読んだ本文には「同一ハードウェア」とあるだけで、デバイスの型番は書かれていません。
さらに 2 点を分けて見る必要があります。1 つはメモリです。Fast-VLA の行の 1.22 GiB は VLM を退避したあとのオンライン常駐メモリで、プリフィル中のピーク 12.11 GiB は注記に別記されています。読んだ本文には、ベースラインの列がピークか常駐かは書かれていません。もう 1 つは成功率とコストの出どころです。ベースラインの成功率は公表済みの報告、ベンチマークの集計(表で「集計」と記載)、または公開チェックポイントに対する著者の評価から取られ、レイテンシとメモリは著者が共通のプロトコルで別に計測しています。そのため、同じ行の成功率とコストが同じ実行から得られたとは限りません。
LIBERO では、Fast-VLA は標準で 95.95%、LIBERO-Plus で 79.11%、償却 3.975 ms/ステップ、常駐メモリ 0.86 GiB です。Faster-WAM(Noah)と Faster-WAM(HUST)と比べると、LIBERO-Plus の成功率は 4.11 ポイントと 5.54 ポイント高く、償却推論は 3.1 倍と 21.2 倍速い一方、標準 LIBERO では下回ります(両者は 98.50% と 99.00%)。3 手法とも 10 ステップごとに再計画します。LIBERO-Plus では π0.5 と DM0.5 をそれぞれ 6.59 ポイントと 6.79 ポイント下回ります。著者は、この 2 つのベースラインが事前学習済みの動作生成の重みを使うのに対し、Fast-VLA の動作デコーダーはゼロから学習している点を挙げています。これは著者の説明であり、論文はこの原因を個別の実験では検証していません。
実行器は本当にこのメモリを使っているか
固定メモリは、実行器が実際にそれを読んでいて初めて意味を持ちます。著者はテスト時にメモリの内容を差し替え、実行器の重みは固定したまま再学習しませんでした(表 4、RoboTwin 2.0)。
| メモリの条件 | Clean(%) | Randomized(%) |
|---|---|---|
| 元のメモリ | 92.46 | 92.40 |
| 言語セグメントを差し替え | 35.18 | 29.66 |
| 同じタスクの別エピソードのメモリ | 6.26 | 8.36 |
| 初期画像セグメントを差し替え | 2.64 | 2.62 |
| 別タスクのメモリ | 0.62 | 0.52 |
初期画像セグメントの差し替えは言語セグメントの差し替えより大きく成功率を下げ、同じタスクの別エピソードのメモリでも成功率は 1 桁にとどまります。著者はここから、実行器は現在のエピソードに対応したメモリに依存していると結論づけています。本サイトの読み方では、このメモリには「どのタスクか」だけでなく、そのエピソードの初期シーンの情報も含まれています。差し替えは凍結した実行器に対するテスト時の介入であり、実行器の出力がメモリの内容に依存することは示しますが、メモリからどの情報を具体的に読み取っているかまでは示しません。
メモリの作り方も影響します(表 5、LIBERO、変種ごとに実行器を再学習)。タスクメモリなし(定数ゼロの KV)では 69.90% / 53.69%(標準 / LIBERO-Plus)、画像条件付きメモリからテキストトークンの KV だけを残すと 93.20% / 73.84%、最終層だけでは 94.70% / 73.70%、34 層すべての指示と画像の KV では 95.95% / 79.11% です。
オンライン入力も同じく重要です(LIBERO、変種ごとに再学習)。手首画像なしで 65.60% / 33.49%、ヘッドカメラのみで 70.80% / 30.80%、手首カメラのみで 87.10% / 68.72%、固有受容状態なしで 94.30% / 72.41%、ヘッド画像なしで 92.70% / 74.54% です。標準 LIBERO では、手首画像を除いた場合(65.60%)とタスクメモリを除いた場合(69.90%)の損失が同程度です。著者は手首画像を閉ループのフィードバックの重要な情報源と位置づけています。このデータは論文の表 6 にありますが、本文では「Table 7」として参照されています。
1 回だけ考えることで手放すもの
著者は最終層メモリの変種を使って、メモリの更新頻度を比較しました(表 8、LIBERO、スケジュールごとに対応した学習。償却コストにはチャンクごとの 34.25 ms の実行器呼び出しと、メモリ構築ごとの VLM プリフィル 1 回を含みます)。
| 更新スケジュール | エピソードあたりの VLM 呼び出し | 償却 ms/ステップ | 標準(%) | LIBERO-Plus(%) |
|---|---|---|---|---|
| 動作チャンクごと | 17.37 | 12.391 | 96.50 | 72.47 |
| 2 チャンクごと | 8.93 | 8.052 | 95.95 | 70.63 |
| 4 チャンクごと | 4.74 | 5.898 | 95.95 | 68.24 |
| エピソードに 1 回 | 1.00 | 3.975 | 94.70 | 73.70 |
チャンクごとに更新すると、標準 LIBERO は 1.80 ポイント上がり、LIBERO-Plus は 1.23 ポイント下がります。VLM の呼び出しは 17.37 倍、償却時間は 3.12 倍に増えます。著者はこれを、エピソードに 1 回の構築が成功率と VLM の計算量のあいだの効率的な折り合いであることの裏づけとしています。この比較は LIBERO だけで、しかも最終層メモリの変種だけで行われています。更新によって LIBERO-Plus の成功率が下がる理由について、論文は説明していません。
メモリのエンコーダーも差し替えられます(表 9、LIBERO、実行器の構造は同じ。メモリはエピソードごとに保存する bf16 の KV キャッシュ)。PaliGemma v1 は 9.8 MB で 95.35% / 73.15%、π0.5 は 9.8 MB で 94.90% / 71.48%、Qwen2.5-VL-7B は 31.8 MB で 95.35% / 75.55%、既定の DM0.5 は 79.7 MB で 95.95% / 79.11% です。標準 LIBERO では 4 つの差が 1.1 ポイント未満で、差は主に LIBERO-Plus に現れます。
タスクの長さについては(表 7、RoboTwin 2.0 を公式のステップ予算でグループ分け)、Fast-VLA は短・中・長の 3 グループで 94.00%、90.27%、90.25% で、各グループのタスク数は 29、15、6 です。put_bottles_dustbin はステップ予算が 1,700 ステップで、同じメモリで最大 34 回の実行器呼び出しが可能であり、成功率は 87.00% です。
時間の粒度の問題もあります。RoboTwin の構成では 50 ステップを予測してすべて実行してから再計画するため、実行器が新しい観測を読むのは 50 環境ステップに 1 回です。LIBERO では 10 ステップに 1 回です。読んだ本文には環境ステップの制御周波数が書かれていないため、秒に換算することはできません。著者が述べる制約は、メモリはエピソード開始時に構築されて固定されるため、エピソード途中でのタスク目標の変更や新しい指示への対応は未検討だという点です。著者は、イベントをきっかけにしたメモリ更新や上位レベルの再計画との組み合わせを提案しています。
本サイトの既存記事との関係
フィジカルAIラボ 0.3:見る・考える・動くでは、「ゆっくり考える」系と「素早く動く」系の 2 つに分けること、そして π0 論文のロボットが 25 ステップの実行ごと、約 0.5 秒ごとに推論し直すことを扱いました。Fast-VLA は遅い系をエピソードに 1 回まで押し下げ、実行器はチャンクごとに再計画を続けます。RoboTwin では 50 ステップごと、LIBERO では 10 ステップごとです。0.3 のルールはここでも当てはまります。周波数や間隔は、それを報告したシステムと構成だけに属します。
フロンティア・レーダー|Fast Plans, Faithful Actionsで取り上げたプレプリントは、π0.5 から派生した階層型 VLA で計画の終点を消しても成功率が変わらない、つまり実行器が上位の計画を実際には使っていないことを見つけました。Fast-VLA のメモリ差し替えは同じ種類の問い、すなわち下流のモジュールが上流から渡された文脈を本当に読んでいるかに答えるものです。2 本の論文はシステムもベンチマークも異なるため数字を直接比べることはできませんが、上位が 1 回だけ、あるいはまれにしか計算しない設計では、この種の介入テストを確認する価値があります。
フロンティア・レーダー特集|エッジとリアルタイム性では、レイテンシ予算がどこに使われているかを整理しました。Fast-VLA の ms/ステップを読むときは、それが予測/実行のステップ数とエピソード長に左右される償却値であることに注意が必要です。1 回の反応時間を見るなら、ms/チャンクと最初のチャンクの 153.74 ms を見るべきです。ベースラインの成功率とコストの出どころが異なる点は、フィジカルAIラボ 1.8:評価の問い方で一つずつ確認できます。
制約と注意点
- arXiv のプレプリントであり、数字はすべて著者報告 [R] です。著者は Huawei Technologies Co., Ltd と Huawei Central Research Institute に所属しています。本サイトはどの結果も再現していません。
- 読んだ本文の実験はすべてシミュレーションのベンチマーク(RoboTwin 2.0、LIBERO、LIBERO-Plus)で行われ、実機実験はありません。シミュレーションの結果はハードウェアの安全性検証ではありません。
- Fast-VLA は DM0.5 の 4B VLM でメモリを構築しており、DM0.5 自体も比較対象のベースラインの 1 つです。
- ベースラインの成功率は公表済みの報告、ベンチマークの集計、または公開チェックポイントに対する著者の評価から取られ、レイテンシとメモリは著者が別に計測しています。Faster-WAM(Noah)のコストは著者自身の実装によるものです。読んだ本文には計測デバイスの型番がなく、信頼区間もありません。
- 償却レイテンシはエピソード長と実行ステップ数に依存します。1.22 GiB は VLM 退避後の常駐メモリで、プリフィル時のピークは 12.11 GiB です。
- メモリは初期観測から作られ、エピソード内では固定です。メモリ構築、オンライン入力、更新頻度のアブレーションは LIBERO だけで行われ、更新頻度の比較は最終層メモリの変種を使っています。
- 論文の本文はオンライン入力のアブレーションを「Table 7」として参照していますが、データは表 6 にあります。本記事は表のデータに基づいて引用しています。
リンク
- Fast-VLA: You Only Think Once for Robot Manipulation(arXiv 2610.21389)
- 論文の HTML 全文
- フィジカルAIラボ 0.3:見る・考える・動く――3 つの周波数をそれぞれのシステムに戻す
- フィジカルAIラボ 1.8:評価――「差し引き +2」を対応表に分解し、失敗ラベルと乱数シードを計算で確かめる
- フロンティア・レーダー|Fast Plans, Faithful Actions:階層型 VLA の計画が遅く、実行器が計画を見ていない問題をどう測りどう直すか
- フロンティア・レーダー特集|エッジとリアルタイム性:VLA と世界行動モデルのレイテンシ予算はどこに使われているか
- フィジカルAIラボ:すべての数字を確認できるフィジカルAI講座(講座の概要)