导航世界模型可以在执行前为每条候选轨迹预测未来画面,再按预测结果挑轨迹;但候选一多,逐条生成 RGB 画面的计算就成了主要开销。南京大学、帝国理工学院、Sony AI 与北京邮电大学作者的预印本 LiteNWM(arXiv 2610.12368,2026-10-08)保留“导航策略提候选、世界模型做评估”的分工,把评估搬到潜空间:每个决策状态只编码一次画面,一次性联合预测 16 条候选和现行轨迹 τ0 在未来四步的特征,再由学习的打分器相对当前轨迹决定换不换。作者报告,离线宏平均轨迹误差比 NoMaD+NWM-XL 低 17.56%,在 RTX 5090 上端到端快 128.00 倍;在 Unitree Go2 EDU 真机上,导航成功率从 NoMaD 的 43.3% 升到 83.3%。以下数字均为作者报告 [R],本站未复现。需要先说明的是,128 倍是工作站显卡上的计时;在机器人自带的 Jetson Orin 上,LiteNWM 每次规划平均 2.228 s,比单独运行 NoMaD 慢。
瓶颈:每条候选都要生成一段 RGB 未来
GNM、ViNT、NoMaD 这类通用导航策略从大规模、多样的机器人数据中学习目标条件导航。NoMaD 用扩散解码器,每个观测可以采样出多条可行轨迹(扩散策略为什么能保留多种正确做法,见 物理AI实验室 1.6)。作者指出的问题是:这些策略选轨迹时并不显式评估各条轨迹的后果。
Navigation World Models(NWM,Bar 等,CVPR 2025)为每条候选预测未来的 RGB 观测,再按预测结果选择。作者明确把“基于预测未来的轨迹重排序”和“提议者—评估者分离”的接口归为已有工作,LiteNWM 只回答一个更窄的问题:短时域候选能否直接用动作条件的潜特征来比较,而不必为每条候选重建 RGB 画面。
作者在 RTX 5090、RECON-100、预测时域 H = 4、候选数 K = 16 的条件下做了组件延迟剖析:逐候选的 CDiT rollout 占 NoMaD+NWM-S 延迟的 84.8%,占 NoMaD+NWM-XL 的 97.6%。本站此前介绍的 Token-World 也在紧凑的特征空间里推演、不生成 RGB,但它用于模拟和评测 VLA 策略的成功率;LiteNWM 用在每个导航决策点上挑选轨迹。
做法:编码一次,联合预测四步,相对现行轨迹打分
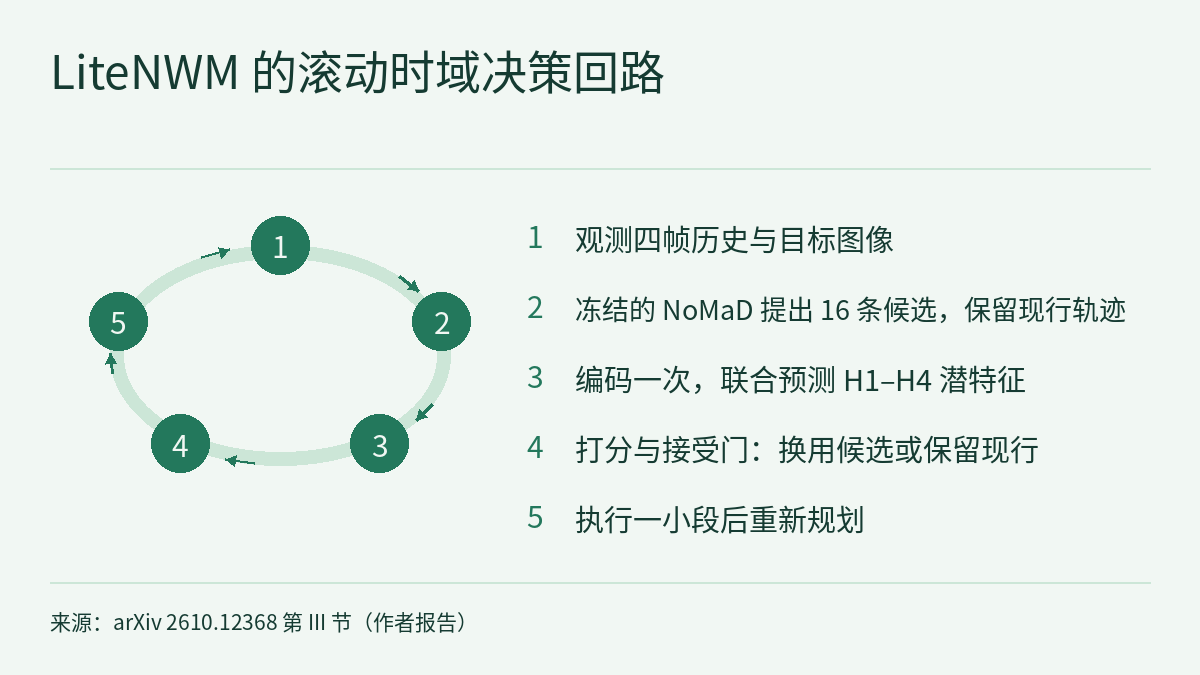
- 提议。冻结的 NoMaD 在四帧观测历史和一张目标图像下给出 K = 16 条四步候选(论文称 challenger),另把 NoMaD 的确定性输出保留为现行轨迹 τ0(incumbent);K 不含 τ0。每条候选经确定性转换写成每步的 [Δx, Δy, Δψ]。
- 共享编码。冻结的 DINOv3 编码器加一个轻量 adapter,每个状态只编码一次历史和目标,所有候选共用。
- 联合预测。动作编码器按 SE(2) 积分出每步的累计位姿,用位姿条件的 warping 初始化查询,经 6 个分解块细化,一次输出 H1–H4 四个时域的未来潜特征,时域之间没有自回归反馈。预测器不接收目标;监督信号是冻结的 DINOv3 加 adapter 对真实未来画面的特征。
- 打分与接受门。打分器结合预测的未来、当前状态、目标特征和整组候选的上下文,预测每条候选相对 τ0 的 ATE、RPE、FDE 和组合指标 J(J = 0.4 ATE + 0.6 FDE)的变化量。预测器和打分器各是 3 个成员的集成,取均值加 z 倍标准差的保守估计。候选要通过物理与提议支持检查,并且 ATE 和 J 的保守估计都下降、“同时改进”的概率足够高、“有害”的概率足够低,才有资格被选中;没有合格候选就保留 τ0。离线默认配置另做一轮 CEM 精修(CEM1)。
- 执行。滚动时域:每个控制周期观测、提议、预测、选择,执行所选轨迹的一小段后重新规划。部署时所有组件冻结,NoMaD 也不微调。
换用另一个导航策略 MBRA 时,一个确定性适配器把 MBRA 的输出映射到同样的四步动作表示,不做针对提议者的再训练或重新标定。
离线:误差更低,消融和接受门各说明了什么
离线评测使用 RECON、SCAND、SACSoN 三个数据集的固定开发集,每个 100 个查询状态,配四个提议种子,共 1,200 次状态—种子评测;所有方法都从同一组 16 条 NoMaD 候选出发。误差按各数据集的平均航点间距归一化。三域宏平均 ATE:NoMaD+NWM-XL 为 0.5538,LiteNWM(CEM1)为 0.4566,降低 17.56%;分域降低 25.21%(RECON)、14.98%(SCAND)、14.71%(SACSoN)。SR@1 比 NoMaD+NWM-XL 高 6.5、3.5、7.0 个百分点;作者写明 SR@1 衡量的是离线终点一致性(归一化 FDE ≤ 1),不是闭环导航成功。
比较的公平性也有作者自己的提示:NWM 的 MPC/CEM 和终帧目标是为 8 步 rollout 设计的,改到 H = 4 可能限制其效果;绝对误差也不能与 NWM 原文(长度 8 的轨迹)直接比较。
消融在固定的 16 条候选上换掉预测特征,打分器各自匹配训练(三域宏平均,越低越好)。这是诊断设置,数值与上文 CEM1 默认配置的 0.4566 不是同一设置:
| 变体 | ATE | RPE | FDE |
|---|---|---|---|
| 不用预测的未来 | 0.4790 | 0.2596 | 0.6743 |
| 重复当前 DINO 特征 | 0.4803 | 0.2610 | 0.6763 |
| 只用预测的 H4 | 0.4662 | 0.2529 | 0.6500 |
| 预测的 H1–H4 | 0.4431 | 0.2316 | 0.6440 |
| H1–H4,候选与未来错配 | 0.4925 | 0.2672 | 0.6996 |
- 预测的未来优于两个对照;把候选与其预测未来的配对打乱后,宏平均 ATE 增加 0.0294(95% 配对聚类 bootstrap 区间 [0.0175, 0.0415]),作者据此认为打分器用到了与每条候选正确配对的预测。
- 作者写明 H4 拿到了大部分收益,中间时域只带来较小的额外改进。附录在另一种分组下给出“只用 H4 减 H1–H4”的 ATE 差为 +0.0031,95% 区间 [−0.0014, 0.0065] 跨过零,所以中间时域的额外收益在这项分析里没有得到确认。
- 接受门的诊断用的是历史 CEM3 配置:门控把有害替换率从 23.00% 降到 9.92%,替换覆盖率从 100% 降到 64.83%;但“不加门减加门”的宏平均 ATE 差为 −0.00409,95% 区间 [−0.00912, 0.00076] 含零。门控主要减少有害替换,没有证明能降低平均误差。
- 固定候选池中,98.42% 的状态—种子组合里存在一条 ATE 低于现行轨迹的候选;LiteNWM 的选择在 49.75% 中降低了 ATE,8.42% 中升高,41.83% 中保留现行轨迹。
同一个冻结评估器接到 MBRA 后,三域宏平均 ATE 从 0.600 降到 0.503,即 16.2%;分域为 6.9%、23.0%、16.8%。
两套计时:RTX 5090 上的 128 倍,Jetson Orin 上的 2.2 秒
论文有两组延迟数字,硬件、配置和计时边界都不同,作者也把它们分开报告。这正是 物理AI实验室 0.3 练过的规则:一个耗时只属于测出它的那套系统。
| 方法 | RTX 5090,每状态端到端(s) | Jetson Orin 机载,每次规划均值(s) |
|---|---|---|
| NoMaD | 0.121 | 0.651(302 次调用) |
| NoMaD+NWM-S | 11.653 | 235.038(22 次调用,DDIM-30,一次 rollout) |
| NoMaD+NWM-XL | 88.449 | 未报告 |
| LiteNWM | 0.691 | 2.228(311 次调用;中位数 2.085,P95 3.883) |
- RTX 5090 一列在 RECON-100、H = 4、K = 16 下测得,计时包括提议生成、未来评估、打分、精修和最终选择;LiteNWM 的数值还把初始化和 30 个预热状态摊到 100 个评测状态上。同一表中,LiteNWM 每状态 GPU 能耗 0.0277 Wh、峰值显存 2,459 MiB,NoMaD+NWM-XL 为 14.0695 Wh、13,776 MiB;GPU 能耗不含整机功耗。88.449 ÷ 0.691 约为 128,与作者的 128.00 倍一致。
- Jetson Orin 一列取自机器人日志里的内部规划延迟,包括共享编码、提议、未来评估、打分、条件精修或恢复以及最终选择,不含模型初始化和机器人运动。机载部署在初始候选满足接受条件时跳过 CEM,否则最多精修三轮;311 次调用中 4 次用了两轮、19 次用了三轮。
- 按表中均值,本站算出机载 LiteNWM 每次规划约是 NoMaD 的 3.4 倍(2.228 ÷ 0.651);这不是论文给出的倍数。论文标题里的 “onboard” 对应附录 F-C:LiteNWM 在 Go2 EDU 机载的 Jetson Orin 上运行;在那里,评估候选仍比单独运行 NoMaD 多花时间。
边缘推理的其他延迟数字如何拆解,可对照 前沿雷达专题|边缘与实时性。
真机:Go2 EDU 上每种方法 30 次
部署平台是 Unitree Go2 EDU,导航策略只接收单目 RGB 观测和一张 RGB 目标图像。三个场景各做 10 次,每种方法共 30 次。成功的条件是:在发生碰撞、人工纠正干预或异常终止之前,进入标定的 1.0 m 目标半径,目标观测可见且与目标一致,偏航误差在 60° 以内;该状态须保持至少 1 s 或随后正常停止,仅仅经过目标不算。
| 场景 | NoMaD 成功率 | NoMaD SPL | LiteNWM 成功率 | LiteNWM SPL |
|---|---|---|---|---|
| 开阔室内 | 70.0% | 0.642 | 90.0% | 0.890 |
| 杂乱室内 | 40.0% | 0.397 | 90.0% | 0.889 |
| 室外庭院 | 20.0% | 0.187 | 70.0% | 0.651 |
| 总体 | 43.3% | 0.409 | 83.3% | 0.810 |
SPL 对全部试验取平均,失败记为 0。真机对比只在 LiteNWM 与 NoMaD 之间进行。NoMaD+NWM-S 在机器人上只做了两次探索性部署:即使把 DDIM 减到 30 步,两次运行平均每次规划决策也要 234.0 s 和 236.5 s(分别 13 次和 9 次决策),作者把它们排除在成功率比较之外。每个场景 10 次的样本量很小,所给正文也没有为真机结果报告置信区间;读这类小样本比较时要问的问题,见 物理AI实验室 1.8。
局限 / 注意
- LiteNWM 是预印本,全部数字为作者报告 [R],本站没有复现;所读论文文本没有提到代码或模型的发布。
- 论文内有两处数字不一致。结论写“比 NWM-S 和 NWM-XL 快 18.39 倍和 132.02 倍”,而摘要、引言和第 IV-E 节写的是比 NoMaD+NWM-S 快 16.86 倍、比 NoMaD+NWM-XL 快 128.00 倍;本文采用与表中计时相符的后者。引言把 221.97 s 写成 NoMaD+NWM-XL 每决策状态的端到端耗时,第 IV-E 节则说 221.974 s 来自单独运行 NWM-XL 的 7 状态原生 CEM 诊断,表中 NoMaD+NWM-XL 为 88.449 s。
- 预测器只评估四步内的局部后果。作者写明:更长的路线依靠反复重规划,不能证明超出这一时域的预测精度;提议者不从评估器获得训练反馈,它的候选分布不变;更激进的分数优化可能暴露模型误差,尤其是在候选分布之外。
- 离线结果来自每域 100 个状态的开发集;SR@1 是离线终点一致性,不是闭环成功率。接受门与集成的诊断用的是历史 CEM3 配置,集成成员的六项对比在 Holm 校正后都不显著。
- 真机为三个场景、每种方法 30 次,只与 NoMaD 比较。附录中的长路线演示依靠预先建图的视觉路线提供一串中间目标图像,属于定性展示,不在成功率表里。
- 128 倍和能耗数字只属于 RTX 5090 上的基准设置,GPU 能耗不含整机功耗;在 Jetson Orin 上,LiteNWM 的平均规划延迟高于 NoMaD。
链接
- LiteNWM: Efficient Latent World Models for Onboard Visual Navigation in the Wild(arXiv 2610.12368)
- 论文 HTML 全文
- 前沿雷达|Token-World:在 VLM token 空间里推演世界模型,不经 RGB 重建来模拟 VLA 策略
- 前沿雷达专题|边缘与实时性:VLA 与世界动作模型的延迟预算花在哪里
- 物理AI实验室 0.3:看-想-动,把三个频率放回各自的系统
- 物理AI实验室 1.6:模仿学习,手算误差怎样滚出示范覆盖范围,再把 ACT、扩散策略与数据规模律的数字放回各自条件
- 物理AI实验室 1.8:评测,把“净增 2”拆成配对表,再给失败标签和随机种子算一笔账
- 物理AI实验室:一套每个数字都能核对的物理 AI 课程(课程大纲)