
Witsense AI の Suvarna Kadam 氏と University of Huddersfield の Soran Parsa 氏が、VLA のサーベイ arXiv 2611.18372(2026-11-13)を公開しました。対象は 2022 年 12 月から 2026 年 10 月までの 88 件の研究です。VLA をモデル設計から学習、デプロイまでのライフサイクルに沿って追い、7 つの設計軸を定め、主要な 22 モデルをその上に配置し、各論文の本文から学習データ、パラメータ数、推論速度、ハードウェアを抜き出しています。新しい論文を読むとき、この軸はチェックリストとして使えます。その研究がどの軸を変えたのか、報告された数字をほかの研究と並べて比べられるのかを確かめられます。以下はサーベイ著者のまとめと抜き出しです [R]。個々のモデルの数字は元論文の著者報告のままで、本サイトでは再現していません。
88 件の内訳は、基礎となる研究 5 件、マニピュレーション VLA 38 件、ナビゲーション VLA 12 件、サーベイ 5 件、ヒューマノイド制御・世界-行動モデル・評価に関する研究 28 件です。著者はこれを系統的レビューではなく構造化レビューと位置づけています。広く使われている VLA から出発し、その参考文献と被引用文献をたどり、arXiv を検索して集めたものです。
7 つの設計軸
4 つの軸がモデル自体を、2 つが学習を、1 つがデプロイを表します。
- 入力と記憶:モデルが何を観測するか(カメラ、言語、ロボットの状態、追加の条件)、過去をどれだけ保持するか。
- アーキテクチャ:バックボーンのネットワークではなく、パイプライン全体の構造を指します。単一のネットワーク、低速の VLM と高速の行動モジュールを一緒に学習するデュアルシステム、別々に学習したモデルからなる階層型の 3 種類があります。
- 行動出力:視覚言語の特徴をどのようにモーター指令へ変えるか。離散トークンから拡散、フローマッチング、回帰まであり、通常は将来の行動をひとまとまり(チャンク)で出力します。
- 中間予測:行動のほかに何を予測するか。テキストでの推論(思考の連鎖、サブタスク)の場合と、世界モデルによる将来の観測の場合があります。
- 事前学習データ:ロボットのデモ、複数のロボット身体から集めたデータ、Web データ、人間の動画、シミュレーションと生成された軌道、そしてそれらの配合。
- 事後学習:対象のロボットやタスクにどう適応させるか。ファインチューニングの手順から、デプロイ中の強化学習まで含みます。
- リアルタイム実行:数ヘルツでしか動かないモデルで、どうやってロボットを滑らかに制御するか。行動チャンク、非同期推論、リモートサーバーとロボットの分担などの手段があります。
分類で一つ注意したい点があります。π0 の行動エキスパートは独立した重みを持ちますが、著者は π0 を単一ネットワークに数えています。エキスパートが同じ transformer の一部で、すべての層で VLM のトークンを参照しているためです。デュアルシステムは、2 つのネットワークの間で 1 つの潜在表現だけを受け渡すものとされています。OpenVLA、π0、GR00T N1 の行動ヘッドとパラメータの内訳は、本サイトの講座 フィジカルAIラボ 3.1 で一つずつ分解しました。本記事ではそれを繰り返さず、サーベイがより多くのモデルを 1 つの表にどう並べたかを見ます。
表 3:22 モデルの選択はどこに集まっているか
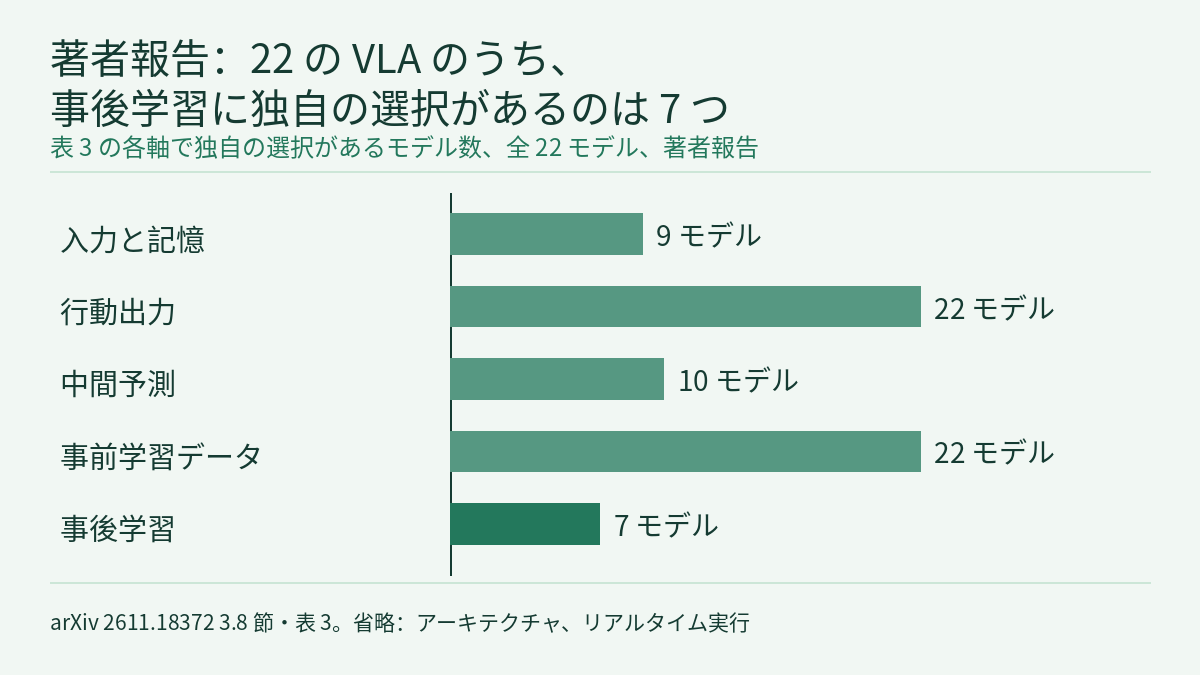
3.8 節の表 3 は、22 モデル(マニピュレーション 15、ナビゲーション 7)を 7 つの軸に配置しています。表中のダッシュは、その研究がその軸で独自の選択をしていないという意味で、その部分がモデルにないという意味ではありません。著者が列ごとに読んだ結果は次のとおりです。行動出力と事前学習データの 2 列は、すべてのモデルに記載があります。9 モデルが入力を拡張し、10 モデルが行動以外のものも予測しており、そのうち将来の観測を予測するのは VLA-JEPA と π0.7 の 2 つだけです。事後学習で独自の選択をしているのは 7 モデルにとどまります。ナビゲーションの 7 モデルのうち 5 つは入力に履歴や追加の視点を加えており、著者はナビゲーションがロボットのこれまでの移動経路に左右されるためだと説明しています。行ごとに見ると、π0.7 は 7 つの軸すべてで独自の選択をしており、RT-2 と OpenVLA はそれぞれ 4 つです。本記事の図はこのうち 5 つの軸の数を示しています。アーキテクチャとリアルタイム実行の 2 軸については著者が数を示していないため、図には入れていません。
表 3 の記載によれば、事後学習の欄に内容がある 7 モデルは、OpenVLA(LoRA ファインチューニング、量子化)、π0(タスクへのファインチューニング)、OpenVLA-OFT(並列デコード、チャンク化、L1 損失)、π0.6*(RECAP によるオフライン RL)、π0.7(メタデータによる条件付け)、StreamVLN(DAgger)、VLingNav(オンライン RL)です。この一覧は本サイトが表 3 から拾い出したものです。OpenVLA-OFT の手順は、OpenVLA の LIBERO 平均成功率を 76.5% から 97.1% に上げ、スループットを 26 倍にしています。RECAP の「処理量 2 倍以上」を元の実験条件に戻すとどう読めるかは、フィジカルAIラボ 3.3 を参照してください。
学習データ:出どころは広がり、単位はそろっていない
サーベイが挙げる事前学習の規模は、RT-1 の約 13 万エピソード、OpenVLA の Open X-Embodiment 97 万エピソードから、π0 の約 1 万時間、LingBot-VLA の約 2 万時間まであります。π0.6* は「数万時間」としか書いていません。出どころも広がっています。GR00T N1 は 78 万件のシミュレーション軌道と約 30 万件の動画生成軌道を使い、Qwen-VLA は 720 万件のシミュレーション軌道を使いました。GR00T N1.7 は事前学習に EgoScale の一人称視点の人間動画 2 万時間を加えています。GR00T N1.5 から N1.7 は NVIDIA のコードリポジトリのリリースノートにしか記載がなく論文がないため、サーベイはこれらのデータと評価をほかの論文と同じ水準では確認できないと明記しています。
問題は単位です。図 6 に載せられるのは、エピソード数を 1 つの値で報告している 16 件だけです。π0 と LingBot-VLA は時間数しか報告していないので、同じ軸に置けません。著者は序論で、これを自分たちが直接突き当たった未解決の問題として挙げています。かなりの割合の論文が、学習データを互換性のない単位で記述しているか、量をまったく示していません。
データの少ない側にも結果があります。SmolVLA はコミュニティが集めた約 2.3 万エピソードで学習しています(表 5 では 481 のコミュニティ SO-100 データセットからの 22.9k エピソードと記載)。TinyVLA、VLA-Adapter、VLA-0 はロボットでの事前学習をまったく行っていません。ただしサーベイは、これらの最も良い結果が LIBERO のようなシミュレーションベンチマークによるもので、こうしたベンチマークが測る範囲は実環境での使用よりずっと狭いと指摘しています。SimVLA は 0.5B の最小限の設計と標準化した学習手順ではるかに大きなモデルに並び、報告されている改善の多くは学習手順の違いと切り分けにくいと論じています。
データを混ぜれば混ぜるほどよいわけでもありません。サーベイは π0.5 のアブレーションを引用しています。ほかのロボットや環境のデータは未知の家庭での性能に重要でしたが、Web データは主にロボットデータにない物体の扱いに役立ち、タスク全体の成功率への影響は統計的に有意ではありませんでした。
モデル規模、デプロイ速度、マニピュレーションとナビゲーションの合流
パラメータ数は二極化しています。2025〜2026 年のモデルの多くは 3〜7B で、同時に 1B 未満のグループが現れました。SmolVLA(0.45B)、VLA-Adapter と SimVLA(0.5B)、X-VLA(0.9B)です。RT-2(55B)は今もこの中で最大のロボット方策です。VLA-Adapter は一般向け GPU 1 枚で 8 時間学習します。
速度の数字はさらに比べにくくなっています。表 2 は各論文が報告した推論速度を、それぞれの単位のまま集めています。π0 は RTX 4090 でのオンボード推論が 1 チャンクあたり 73 ms、OpenVLA-OFT は A100 での LIBERO のスループットが 71.4 Hz、レイテンシが 0.11 s、GR00T N1 は L40 で 16 行動のチャンクあたり 63.9 ms、NaVILA は RTX 4090 で毎秒約 1 フレームです。著者は、これらがスループット、チャンクあたりのレイテンシ、フレームレート、実効制御周波数の混在で、異なる GPU で測られており、そのまま順位づけはできないとはっきり述べています。ハードウェアを明記したモデルはすべて、デスクトップかデータセンター向けの GPU 1 枚(RTX 4090 または 5090、A6000、A100、L40、H100)かクラウドの TPU で動いています。組み込みハードウェアが出てくるのは分割システムのエッジ側だけで、たとえば AsyncVLA(ナビゲーション)のアダプタが Jetson Orin で動いています。7〜8B の動画 VLM をもとにしたナビゲーション VLA は、通常リモートの RTX 4090 や A100 に置かれ、ネットワーク越しに呼び出されます。SmolVLA の非同期推論の時間計算と行動チャンクの長さの決め方は、フィジカルAIラボ 2.3 と フィジカルAIラボ 2.6 を参照してください。
3 つ目の傾向は、マニピュレーションとナビゲーションの両方を扱う汎用 VLA で、例として UniVLA と Qwen-VLA が挙がっています。Qwen-VLA の著者は、1 つのモデルが LIBERO で 97.9%、RxR で成功率 59.6% に達したと報告しています。サーベイの見方では、どちらのモデルも学習段階で統合しており(データの統合、共通の行動インターフェース)、評価はマニピュレーションとナビゲーションの別々のベンチマークに分かれたままです。著者は、統一モデルへの主な障害がアーキテクチャからデータと評価へ移りつつあるのかもしれないと述べています。
制約と注意点
- これは arXiv のプレプリントのサーベイです [R]。研究の選定は著者が 3 つの基準(独自のアイデア、中核的な問題での明確な進展、コミュニティが土台にするツールの提供)で判断しており、小さな改善にとどまる研究や既存手法を新しい分野に適用しただけの研究は、引用はしても議論していません。
- 表 3 の数は、著者による「独自の選択」の判断と、どの 22 モデルを選んだかに左右されます。ダッシュは、モデルにその部分がないことを意味しません。これらは分類の件数で、サーベイは不確かさを示していません。別のモデルの組で数えれば、件数は変わりえます。
- サーベイが抜き出した数字は、元論文の著者報告のままです。GR00T N1 系列の 4 バージョンはいずれも査読を経ておらず、N1.5 から N1.7 はリリースノートしかありません。
- 本サイトが読んだ本文は、8 節(VLA と世界-行動モデル)の途中で切れています。9 節のベンチマークと公平な評価、10 節の未解決問題、付録 A の実践ガイドは読んだ本文に含まれていません。要旨は、ベンチマークでほぼ満点の VLA の一部が物体やカメラが少し動いただけで失敗すると述べています。本記事はこの点を要旨から紹介しただけで、その根拠は確認していません。
リンク
- Vision-Language-Action Models: A Life-Cycle Survey of Design, Training and Deployment(arXiv 2611.18372)
- 論文の HTML 全文
- フィジカルAIラボ 3.1:VLA を分解する――コップを置く動作を 256 区間のトークンに直し、三つのモデルのパラメータ数と周波数の範囲を確かめる
- フィジカルAIラボ 3.3:RL事後学習――HIL-SERL の「2 倍」と RECAP の「処理量 2 倍以上」をそれぞれの条件に戻し、三つのシードの対応のある区間を計算し直す
- フィジカルAIラボ 2.3:SmolVLA をファインチューニングする――指示に合わせてお手本を計画し、各数字が何を測ったかを確かめ、非同期の動作キューの時間を計算する
- フィジカルAIラボ 2.6:エッジへ――遅延のログから制御周波数の上限を求め、量子化で減るのが容量か時間かを見分け、動作チャンクの長さを決める
- フィジカルAIラボ:すべての数字を確認できるフィジカルAI講座


