
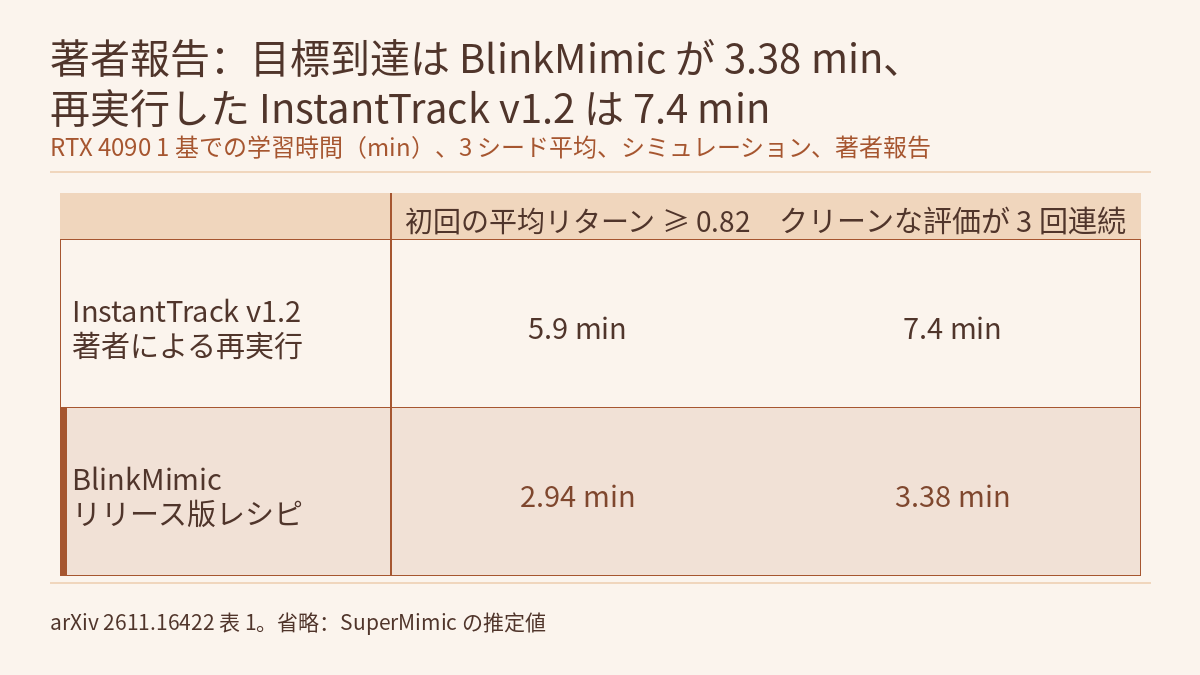
プレプリント BlinkMimic(arXiv 2611.16422、2026-11-12、著者 Fuyi Chen)は、SuperMimic と InstantTrack を土台に、人型ロボットの全身動作追従ポリシーの学習時間をさらに短くしました。著者の報告では、シミュレーション上の Unitree G1 で、40 本の LAFAN1 クリップすべてを追従する 1 つのポリシーが、RTX 4090 1 基で論文の厳しい目標に平均 3.38 分(3 シード)で到達します。同じ GPU・同じ評価器で再実行した InstantTrack v1.2 は 7.4 分でした。学習パイプラインを扱う読者にとっては、この数字より論文の時間の数え方のほうが役に立ちます。学習時間を 1 反復あたりのコスト、フィットに要する反復数、最後の失敗を消すまでの反復数の 3 項に分け、各構成要素がどの項に効くかを 1 つずつ外すアブレーションで確かめています。以下の数値はすべて著者報告 [R] で、シミュレーション内でのみ測定されたものです。本サイトはコードを実行しておらず、独立した再現もしていません。
タスクと「目標到達」の定義
ロボットは駆動関節 29 個の Unitree G1 で、MuJoCo-Warp 上で 50 Hz で制御します。動作ライブラリは G1 にリターゲットした 40 本の LAFAN1 クリップで、計 441,140 フレーム、2.45 時間、1 本あたり平均 3.7 分です。ポリシーは正規化した行動を出力し、スケーリングしたうえで PD 制御器の関節位置目標として渡します。報酬はガウス型の追従カーネルの和に行動変化率のペナルティを加えたもので、アンカー部位の高さまたは傾きの誤差がしきい値を超えると失敗とします。これらの設定は SuperMimic に従っています。
評価では、デプロイ用ポリシーをドメインランダム化もノイズもなしに決定的に動かし、各クリップの最初のフレームから最後まで走らせます。正規化リターンは [0, 1] の範囲で、最初の失敗まで累積します。シミュレータはビット単位では再現できず、余裕の小さいクリップは評価のたびに結果が反転しうるため、各クリップを 4 レプリカ、計 160 ロールアウト実行します。平均リターンが 0.82 以上で、160 本すべてが失敗しなければ、そのチェックポイントは「クリーン」です。目標は 3 回連続のクリーンなチェックポイントで、時間はその最初のものの時点で記録します。この規則は InstantTrack と同じです。チェックポイントは 100 反復ごと(約 13 秒)に取ります。学習時間にはコンパイル、グラフキャプチャ、チェックポイント、プローブを含み、オフライン評価は含みません。
フィジカルAIラボ 1.7 では Learning to Walk in Minutes を読む際に、学習時間はそれ自身のハードウェア・タスク・設定に対してだけ成り立つ、という規則を使いました。BlinkMimic は目標、評価条件、計測範囲を時間のすぐ横に書いており、この規則で数字を読む手頃な例になっています。
学習ループ:学習済み世界モデルを通した逆伝播
1 回の反復は 2 つの部分からなります。収集段階では、4096 台のシミュレーション上のロボットがドメインランダム化の下でノイズ入りの学習用ポリシーを実行し、遷移をリプレイバッファに保存します。終了したエピソードは、ライブラリを 1 秒ごとのビンに分けたリセット分布から引いたフレームで再開します。想像段階では、バッファから B 個の開始状態を取り、学習済みの世界モデルの中で H = 32 ステップ展開し、ポリシーは通時的誤差逆伝播(BPTT)で得た勾配に従って更新されます。critic は想像ロールアウトの λ リターンに当てはめ、デプロイするのは学習用ポリシーの指数移動平均(EMA、β = 0.995)です。
学習済み世界モデルを BPTT で通り抜け、分散の大きい方策勾配の推定をパスワイズ勾配に置き換える方法は SuperMimic によるものです。EMA のデプロイ用ポリシー、Muon による更新、参照動作への補正量を出力する残差ポリシーは、InstantTrack のオープンな実装によるものです。BlinkMimic が新たに加えたのは、学習が進んだら下がるステップ幅、デプロイ条件での失敗に基づくリセット配分、反復全体の CUDA グラフとしてのキャプチャの 3 つです。さらに想像バッチを 2048 に半減しています。
時間の内訳:1 反復のコスト × フィットとテールの反復数
論文は学習時間を T = c̄ (N_fit + N_tail) と書きます。1 反復の平均コスト c̄ に反復数を掛けたもので、反復数はフィット段階 N_fit(評価の平均リターンが初めて 0.82 に達するまで)とテール段階 N_tail(最後に残った失敗クリップが失敗しなくなるまで)に分かれます。3 つの項はそれぞれ別の要因で制約されるため、著者は項ごとに設計しています。RTX 4090 1 基での主結果は次のとおりです(論文の表 1。シード 0 / 1 / 2、括弧内は平均、時間の単位は分)。
| 構成 | ms/反復 | 0.82 までの反復数 | 初めて ≥ 0.82 | 3 回連続のクリーンなチェックポイント | テールの失敗数 | 最終リターン |
|---|---|---|---|---|---|---|
| InstantTrack v1.2(再実行) | 147 | 2408 / 2741 / 2492 | 5.6 / 6.3 / 5.8(5.9) | 7.3 / 8.5 / 6.3(7.4) | 80 / 126 / 113 | 0.856 |
| BlinkMimic(リリース版) | 135 | 1292 / 1456 / 1169 | 2.89 / 3.28 / 2.64(2.94) | 3.32 / 3.28 / 3.53(3.38) | 2 / 6 / 0 | 0.861 |
テールの失敗数は、反復 2000 から 3500 までの各チェックポイントで失敗したロールアウトの合計です。2 つの構成のシードごとの時間は重なっていません。3 シードの平均で見ると、3.38 分のうち約 9 秒が起動とコンパイル、167 秒がリターン 0.82 の最初のチェックポイントまで、26 秒がテールで、フィット段階が 80% 以上を占めます。目標到達時、追従する 14 部位の位置 RMS 誤差は 4.1 cm、平均関節角誤差は 4.0° です。全体位置のフィードバックがないため、ルート位置は 93 cm ずれます。論文の図 1 にある SuperMimic の棒は推定値(InstantTrack が SuperMimic を走らせたときの反復数に、著者の GPU で測った SuperMimic の 1 反復あたりの時間を掛けたもの)で、実測ではありません。高速化の数字を比べる前に基準がどう得られたかを確かめる手順は フィジカルAIラボ 1.4 で練習しました。ここでの InstantTrack は実測の再実行、SuperMimic は推計です。
各構成要素はどの項に効くか
著者は最終レシピから構成要素を 1 つずつ外し、各行 3 シードで比較しています(論文の表 2)。このアブレーションは別の種類の GPU で実行し、反復数で比べています。そこでは完全なレシピが 0.82 に達するまで 1422 反復、RTX 4090 では 1306 反復なので、数値は同じ表の中でだけ比較します。
| 外した構成要素 | 効く項 | 著者が報告した変化 |
|---|---|---|
| ポリシーの Muon(代わりに Adam) | N_fit | 反復 6000 までに目標未達、リターンは 0.81 にとどまる。この行は ×4 のステップ幅とバッチ 2048 を維持しており、Adam を調整した場合の最良値を示すものではない |
| 世界モデルの Muon | N_fit | 0.82 までの反復数 +24% |
| 進捗で下がるステップ幅(一定の ×1 に変更) | N_fit | +14% |
| 参照残差 | N_fit | +23% |
| 半陰的な世界モデルとミラー拡張 | リターン水準 | フィットの反復数は不変(1428 対 1422)、反復 2000–3500 の平均リターンは 0.854 に低下(完全なレシピは 0.860) |
| デプロイ条件でのリセット配分 | N_tail | 3 シード合計のテール失敗は 9 → 18。ただしシード間で重なり、3 チェックポイント規則でも遅くならない |
| 想像バッチを 4096 に戻す | c̄ | 反復数は −20%。ただし以前の構成で RTX 4090 上で測ると 1 反復あたり 41% 増(172 対 122 ms)で、合計時間は延びる |
ステップ幅は基本学習率の 4 倍から始まり、学習リターンが初めて 0.75 を超えた時点(遅くとも反復 1400)から 300 反復かけて線形に 1 倍まで下がります。InstantTrack はすでに 2 つの更新段階を CUDA グラフとしてキャプチャしていました。BlinkMimic は最初の反復からキャプチャし、さらに収集ステップ(ポリシー推論、物理ステップ、報酬、固定形状の演算で行うエピソードのリセット)を同じ CUDA グラフに入れています。著者の報告では、同じ GPU で交互に実行し、チェックポイントとプローブを含めない 2 組の対応付き実験で、定常状態の 1 反復が 127.5 ms から 118.5 ms に短くなり(−7%)、最初の 700 反復が 18 秒短縮されました。著者は、マスク付きリセット後のシミュレータの状態が元のリセットとビット単位で一致し、関節速度だけが最大 2.4 × 10⁻⁷ 異なることを確認しています。
フィット段階は更新規則で、テール段階は練習の配分で制約される
勾配信号にどれだけ改善の余地があるかを見るため、著者は同じネットワークと最適化手法で、収束済みポリシーの行動を DAgger 式のデータ収集で回帰させ、「完全な教師」の参照としました。Muon により教師の更新回数は 3494 回から 1478 回に減り(2.3 倍)、リリース版レシピはバッチ 2048 で 1306 反復と、教師の 1478–1499 回より少なくて済みます。著者はここから、信号を良くする余地は小さく、更新規則を良くする余地はまだあると結論づけています。この比は参照であって下限ではない、とも著者は述べています。世界モデルが与える行動勾配とシミュレータとの相関は、1 ステップで 0.95–0.98、8 ステップで 0.80–0.89 で、32 ステップでは低くなります。critic を外すと反復数は 50% 増えます。
テール段階の分析は jumps1_subject2 を例にしています。配分を入れる前は、後期の失敗の大半がこのクリップの、床を転がってから立ち上がる動作から出ていました。このクリップを単独で学習させると、反復 1000 までは 16 本すべてのロールアウトが失敗し、反復 1250 以降は 128 本中失敗ゼロです。40 本を混ぜて学習させると、難所の手前 10 秒が受け取るリセットは 0.6%–1.5% にすぎません。リセットの 10% をこの区間に強制的に割り当てると、反復 1750 から 3000 までの 6 つのチェックポイントで 256 本すべてが成功しました(いずれも 1 シード)。著者の結論は、これらの状態は学習可能だが練習量が足りないこと、そして学習中に集めた失敗統計(ノイズがあり、ランダム化され、平均化されていないポリシーによるもの)は誤った場所を指すことです。リプレイバッファの遅れもあります。新たに現れた失敗区間がリセットの 18.2% を受け取っても、バッファが一巡する約 400 反復後までは想像の開始状態の 2.5% にしかなりません。
そこで BlinkMimic は、反復 1000 から 125 反復ごとに EMA ポリシーでデプロイ条件のもとライブラリ全体を走査し、最初の失敗を 1 秒ごとのビンに数えます。カウントは走査ごとに 0.7 倍に減衰させ、失敗したビンとその手前の 10 ビンに広げ、このマップに全リセットの 15% を割り当てます。以前のレシピ B では、著者が実行前に判定基準を登録しており、テールの失敗は 23 / 22 / 10 から 2 / 10 / 2 に減り、3 チェックポイント規則の時間は 6.1 分から 4.9 分になりました。リリース版レシピでは残る失敗が少なすぎて、3 シードでは 2 群を区別できなくなっています。
本サイトで以前紹介した SONIC-K1 も人型の動作トラッカーですが、扱っているのは Booster K1 への移植と遅延下での成功率です。ロボット、学習用ハードウェア、指標が異なるため、2 本の論文の数字は直接比較できません。
制約と注意点
- 著者 1 名の arXiv プレプリントで、数値はすべて著者報告 [R] であり、独立した再現はありません。論文はコードとシードごとの結果のリポジトリのアドレスを示していますが、本サイトは開いておらず、何も実行していません。
- 著者が明記した証拠の範囲は、ロボット 1 種、動作ライブラリ 1 つ、学習時間の計測は GPU 1 種で、実機へのデプロイ結果はありません。「数分で学習」はシミュレーション内の学習のみを指し、ハードウェアの安全性検証ではありません。
- 3 シードでは、厳しい規則のもとで約 15% 未満の差を区別できません。アブレーションは完全なレシピ用に調整した設定を維持しているため、外した構成要素は独自の設定ならもっと良い可能性があります。構造とミラーは一緒に外されており、いくつかの診断は 1 シードで、以前の構成で測定されたものです。
- 目標到達後もチェックポイントがクリーンであり続ける保証はありません。シード 1 では反復 3100 で fallAndGetUp2_subject2 が 4 レプリカすべてで失敗しました。著者はこうした後期の反転を、今後最も価値のある課題としています。
- 非同期プローブは GPU がほかに使われていないことを前提としています。別のプロセスが GPU を共有すると学習がクラッシュすることがあり、同期プローブなら避けられますが速度が落ちます。
- 図 1 の SuperMimic の時間は推定値で、同じ条件での実測ではありません。InstantTrack は著者が再実行した v1.2 です。
リンク
- BlinkMimic: Training a Humanoid Motion Tracker in Minutes on a Single GPU(arXiv 2611.16422)
- 論文の HTML 全文
- フィジカルAIラボ 1.7:強化学習――1 回分の収益を手で計算して報酬の抜け道を見つけ、論文の地形カリキュラムとタイムアウト時のリセットを読む
- フィジカルAIラボ 1.4:シミュレータの地図――刻み幅のコストを数え、接触で軌道が分かれる点を読み、3 つの高速化の比較対象を確かめる
- フロンティア・レーダー|SONIC-K1:汎用の人型動作トラッカーを小型の Booster K1 に移植し、共有 H100 1 基で学習――シミュレーションではホールドアウトの 97.4% を追従するが、遅延 40 ms では 56.0% に低下
- フィジカルAIラボ:すべての数字を確認できるフィジカルAI講座


