本节视频
配音由 AI 合成。 视频章节、文字稿与出处
文字稿
文字稿
知行问
一个机器人策略,报告说成功率百分之八十四。这个数字,你真敢信吗?上一集,造了安全过滤器。这一集问:怎么证明它真的管用?答案是,重复实验和置信区间。
一个成功率的谎言
先做个实验,全用这集Notebook模拟。假设真实成功率,就是百分之七十。我们让它跑,看报告出什么。跑一轮,看看成功了几次。算出来,正好百分之七十。看起来,挺准。先说清楚,成功率就是个比例。成功次数,除以总次数。可越简单的数,越容易被误读。可再跑一轮呢?只换个随机种子,数字就变了。这一轮,也许只有百分之六十。别急着骂这个策略。它可能真有百分之七十的实力。只是这一次,运气差了点。更麻烦的是挑数据。跑很多轮,只报最高那一轮。这种成功率,等于自欺欺人。同一个策略,跑上十二轮。高的低的,能差出一大截。全是运气,在里面晃。这不是瞎说,有论文做过。同一套设置,只换种子,跑十次。拆成两组,结论能差到显著不同。原来只跑一次,你看到的,可能只是运气!拿抛硬币打个比方。抛十次,五正五反很常见。可七正三反,也一点不稀奇。规律就在这。样本越少,随机的脾气就越大。样本多了,它才慢慢老实下来。
给成功率一个区间
所以,别只报一个数。要给它一个区间。说清楚:真实的成功率,大概落在哪一段。最常见的算法,叫Wald区间。就是课本里,那个正态近似的公式。可它,藏着一个大毛病。一篇统计学论文指出,Wald区间的覆盖率,长期偏低。它推荐:小样本,改用Wilson区间。Wilson区间是怎么做的?它把观测到的成功率,往中间轻轻拉一点。样本越少,拉得越多。有多离谱?如果十次全成功,Wald区间说,成功率就是百分之百。区间宽度,居然是零。这显然荒唐。十次全对,你就敢说,一次都不会错?Wilson,就不会这么天真。它为什么偏低?正态近似在样本少、比例又极端时,尤其不准。可样本不算少时,覆盖率也会忽高忽低。区间还告诉你一件事。两个策略比高低,区间重叠很多,就还分不出胜负。完全不重叠,差距才靠得住。所以看排行榜,别只盯着第一名。先看看区间,重叠了多少。要严格比较,就算两者差距的区间,或者做检验。还有个通用办法,叫自助法。有论文用自助法,重采样一万次来算区间。算法有好几种,最简单的一种,是取中间那段。自助法的好处,是不用假设分布和公式。可它把样本当成总体的替身。样本太少、比例极端时,它也会失灵。那到底信哪个?小样本的成功率,优先用 Wilson。样本较多、统计量又复杂时,再用自助法。原来区间不是装饰!它在告诉你,这个数到底有多不确定。
要跑多少次
那到底要跑多少次?先看一个规律。区间的宽度,大约按根号n,慢慢缩小。这句话,其实很扎心。想把不确定性,砍掉一半。样本量,得翻上两番。所以别指望十次八次就够。想要一个像样的区间。样本量,往往得往大了估。真机评测更金贵。每一次,都要让机器人真的动一次手。所以样本,往往少得可怜。换个角度想。你观察得越久,就越有底气说,它确实很少失败。还有个反直觉的坑,看这个Notebook里的例子。假设上一集的安全过滤器,测一百次都没失败。也不代表,它的成功率就是百分之百。样本越少,失败率的上界就越松。零失败,只说明你还没撞见失败。不等于,它以后不会失败。原来零失败,不等于零风险!只是你还没试够。所以报成功率,要连着报三样。多少次、哪种区间、区间多宽。一个都不能少。随机种子也要报。这样,别人才能一模一样地,把你的结果重新跑出来。区间也会告诉你,样本什么时候够了。够了就停,别盲目地一直跑下去。有件事最容易忘:成功和失败,得先定义清楚。判据一变,数字就全变了。评测的场景,也得说清。在哪评的、有多难、挑没挑简单的。换个场景,成功率就不是一回事。打开这集Notebook,跟着做。让同一个策略,重复评测很多轮。看那些成功率,怎么散开。再画一条覆盖率曲线。你会看到,Wald那条,明显掉在百分之九十五以下。Wilson那条,基本贴近它,偶尔略低。最后,把区间的半宽,对着样本量画出来。你会亲眼看到,它怎么按根号n慢慢收窄。原来评测的诚实,就藏在这条区间里!回顾一下:一,只报一个成功率会骗人,要给区间。二,别用Wald区间,小样本用 Wilson。自助法,适合样本多、统计量复杂时。三,样本越少区间越宽,零失败不等于零风险。评测不是为了那个好看的数字。是为了知道,你到底有几分把握!把成功率背后的把握讲清了。那个会看、会想、会动的大模型,内部到底长什么样?下一集见!
证据与出处
动手与自测
小测公开,答案与解析在作答后显示;图文课里的练习答案需登录查看。
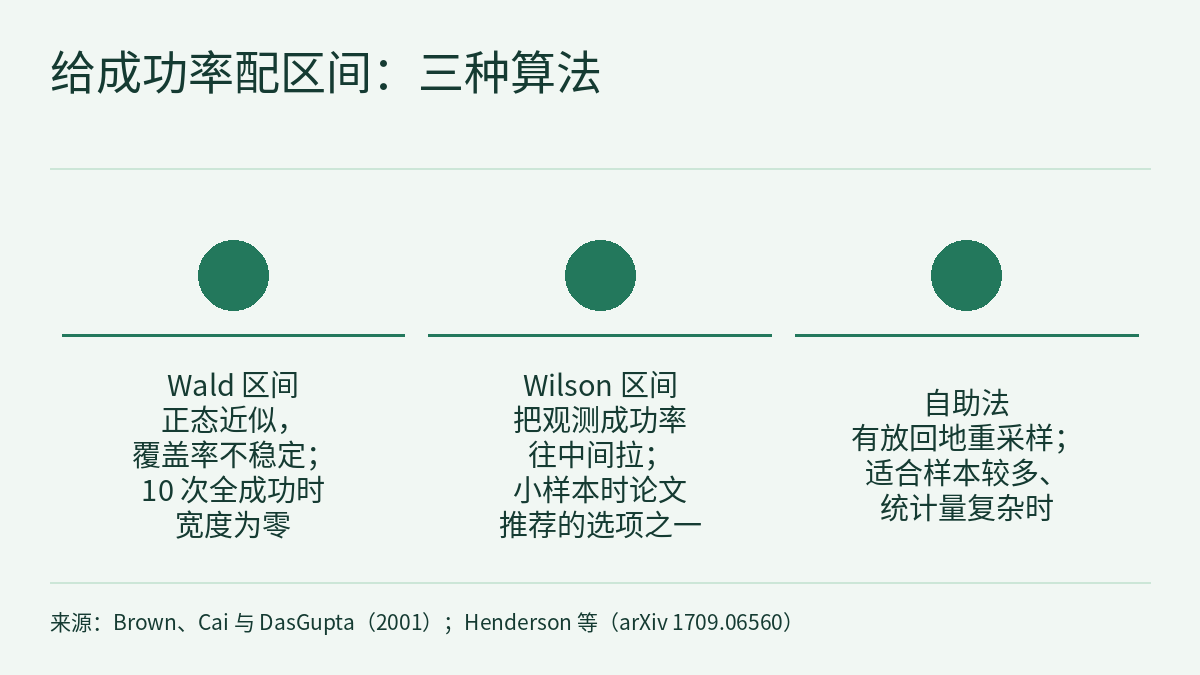
第 2.8 集的视频问:一个策略报告“成功率 84%”,这个数字能信吗?视频讲了三件事:只报一个成功率会骗人,只换随机种子,数字就会跳,所以要给区间;别用课本上的 Wald(正态近似)区间,小样本的成功率用 Wilson 区间,自助法(bootstrap)适合样本较多、统计量复杂的时候;区间宽度大约按 1/√n 收窄,零失败也不等于零风险。片中三张数字卡出自两份公开材料:Henderson 等的 Deep Reinforcement Learning that Matters(arXiv 1709.06560)里,同一套超参数只换随机种子跑 10 次、拆成两组各 5 次,结论可以差到统计上显著不同;同一篇论文给几个 MuJoCo 环境的平均回报算自助法 95% 置信界,用了一万次重采样和 pivotal 方法;Brown、Cai 与 DasGupta 的 Interval Estimation for a Binomial Proportion(Statistical Science,2001)指出 Wald 区间的覆盖性质混乱,并推荐小 n 时用 Wilson 区间。本篇是这一集的图文课与练习,不重复文字稿,而是把视频只给了结论的三件事算出来:用一个虚构的 20 次评测手算 Wald 和 Wilson 区间,看 Wald 为什么会超出 100%、在全成功时宽度为零;用 1/√n 的规律为一次评测定次数,再推出零失败之后失败率上界的算法;最后读 Henderson 等表 3 的真实数字,看区间怎样用于比较,自助法在样本很少时为什么失灵。贯穿全文的规则:一个区间只描述它自己那组试验的次数、判据和场景,报告时要连同次数、区间类型和宽度一起写。
本节视频、文字稿与出处在本页上方,全季安排见课程大纲。上一课物理AI实验室 2.7:安全过滤器,手算一步控制障碍函数修正,再算清它该挂在哪条回路、要留多少余量结尾问:我们怎么知道,这套东西真的管用?本课接着回答。Henderson 等“只换种子跑 10 次、拆成两组”那段原文与实验条件,以及成功率怎样配对、失败怎样分类,物理AI实验室 1.8:评测,把“净增 2”拆成配对表,再给失败标签和随机种子算一笔账已经讲过、练过。本课不再重复,只讲本集新增的部分:区间怎么算、要跑多少次、零失败怎么报,以及自助法的适用范围。下一集 3.1 进入 L3,拆解 VLA 的视觉编码、语言骨干与动作头。
公开小测的 5 道题附完整解析;登录后可完成三项练习:为三组虚构评测手算 Wald 与 Wilson 区间和零失败后的失败率上界,并写出报告句;为一台虚构真机的评测定次数和时间预算,跑完后用 Wilson 区间验收;审一份误用自助法、区间和停止规则的虚构评测报告,并改写它。每项都附分步解法、常见错误与 20 分评分标准。
一、两份材料各自说了什么
Henderson 等,Deep Reinforcement Learning that Matters(arXiv 1709.06560,本课读的是 HTML v1,2017-09-19 提交)。作者来自 McGill University 与 Microsoft Maluuba。论文研究的是强化学习结果为什么难以复现,实验对象是 MuJoCo 连续控制任务上的策略梯度方法(TRPO、DDPG、PPO、ACKTR)。按本课程的分级属 R 级,以下都是作者报告,本站没有复现。片中“10 次”那张数字卡对应“Random Seeds and Trials”一节的两句,各自独立摘录:
We perform 10 experiment trials, for the same hyperparameter configuration, only varying the random seed across all 10 trials. We then split the trials into two sets of 5 and average these two groupings together.
这项实验的条件和论文的解读,1.8 已经讲过。和本课有关的是同一节的另外两点:论文说,近期报告的结果里,从多次试验中挑出最好的前 N 次、或只平均很少几次(N < 5)的做法并不少见,并认为这可能误导读者;论文也说给不出一个推荐的具体试验次数。视频第一章说的“挑数据”,指的就是这类做法。
片中“10,000 次”那张数字卡对应表 3 的说明:
Bootstrap mean and 95% confidence bounds for a subset of environment experiments. 10k bootstrap iterations and the pivotal method were used.
表 3 给出四个算法在四个环境里的平均回报,每格是自助法均值,括号里是 95% 置信界。论文实验部分的通用设置是:每个评测跑 5 次试验,各用一个不同的预设随机种子,所有实验共用同一组种子。表 3 的说明没有单独写明每格用了几次试验。第四节会用到下面这张表,这里先列出原数:
| 环境 | DDPG | ACKTR | TRPO | PPO |
|---|---|---|---|---|
| HalfCheetah-v1 | 5037 (3664, 6574) | 3888 (2288, 5131) | 1254.5 (999, 1464) | 3043 (1920, 4165) |
| Hopper-v1 | 1632.1 (607, 2370) | 2546 (1875, 3217) | 2965 (2854, 3076) | 2715 (2589, 2847) |
| Walker2d-v1 | 1582 (901, 2174) | 2285 (1246, 3235) | 3072 (2957, 3183) | 2926 (2514, 3361) |
| Swimmer-v1 | 31 (21, 46) | 50 (42, 55) | 214 (141, 287) | 107 (101, 118) |
Brown、Cai 与 DasGupta,Interval Estimation for a Binomial Proportion(Statistical Science 16(2),2001)。这是统计学期刊论文,按本课程的分级属 R 级;本课读的是它的摘要。二项比例就是“n 次里成功几次”这类数据的比例,成功率正是一个二项比例。片中“Wald→Wilson”那张数字卡对应摘要里的两句,各自独立摘录:
We begin by showing that the chaotic coverage properties of the Wald interval are far more persistent than is appreciated. Furthermore, common textbook prescriptions regarding its safety are misleading and defective in several respects and cannot be trusted.
Based on this analysis, we recommend the Wilson interval or the equal-tailed Jeffreys prior interval for small n and the interval suggested in Agresti and Coull for larger n.
“覆盖”指的是:按同一种方法反复评测、反复算区间,区间包含真实成功率的比例。一个名义 95% 的区间,覆盖比例应该接近 95%。摘要说 Wald 区间的覆盖性质混乱,而且这种混乱比人们以为的更持久;课本上关于它何时“安全”的经验规则也不可信。
| 片中数字 | 出处 | 原文的条件 | 原文没有说什么 | 等级 |
|---|---|---|---|---|
| 10 次 | Henderson 等,Random Seeds and Trials 一节 | 同一套超参数只换随机种子,跑 10 次,拆成两组各 5 次求平均;对象是强化学习的训练结果 | 不是机器人成功率评测;论文说给不出推荐的具体次数 | R(作者报告) |
| 10,000 次 | Henderson 等,表 3 的说明 | 给一部分环境实验的平均回报算自助法均值与 95% 置信界;10k 次自助重采样,pivotal 方法 | 对象是回报,不是成功率;所读部分没有定义 pivotal 方法,表 3 的说明没有写明每格的试验次数 | R(作者报告) |
| Wald→Wilson | Brown、Cai 与 DasGupta,摘要 | 二项比例的区间估计;Wald 覆盖性质混乱;小 n 推荐 Wilson 或等尾 Jeffreys 区间,较大 n 推荐 Agresti 与 Coull 的区间 | 摘要没有给出“小 n”的界限,也没有写出各区间的公式 | R(期刊论文) |
读这张表要注意:Henderson 等研究的是训练的随机性,讨论的数是回报;Brown 等研究的是二项比例的区间,讨论的数是成功率这一类比例。视频把两者放进同一集,是因为它们回答的是同一个问题:一个数背后有多少不确定性。两份材料的数字不能互相换算。
登录后继续阅读本课其余各节、自测题与答案。
局限 / 注意
- Henderson 等(arXiv 1709.06560,HTML v1,2017-09-19 提交)属 R 级,是预印本。本课读了摘要、引言、实验设置、超参数一节的表 1、表 2、表 3 和“Random Seeds and Trials”一节到图 5 说明的开头;10 次拆两组、10k 次 pivotal 自助法和表 3 的数字都是作者报告,本站没有复现。所读部分没有定义 pivotal 方法,表 3 的说明没有写明每格的试验次数。
- Brown、Cai 与 DasGupta(Statistical Science 16(2),2001)属 R 级,本课只读了摘要。Wald 与 Wilson 的公式是本课采用的标准写法,摘要没有写出;摘要也没有给出“小 n”的界限。
- 以下是本课的推导、读法或建议:Wilson 中心“往中间拉”的公式读法;全成功时 Wilson 下限 n/(n + z²);规划式 n ≈ z²·p(1−p)/E²;零失败上界 1 − 0.05^(1/n) 和 3/n 近似;两个独立估计之差的半宽;10/10 与 9/10 时自助法分位数的推导;“合并区间不包含种子之间的差异”“按结论停止是挑数据的变体”等判断;开跑前写定判据、场景、种子和次数的建议。
- 第二到第五节的策略 X、Y、A、B、C、N,机械臂 M,团队 Q,以及所有次数、成功数、耗时、工时和各种子结果都是虚构的;0.640、0.722、9.5% 等正文例子数字,以及练习里算出的所有数值,都只在这些假设下成立,不是论文或任何系统的数据。
- 本课没有运行视频的 Notebook,没有核对它的覆盖率曲线、半宽曲线或 100 次零失败例子显示的数字。
- 区间重叠只是粗读法,视频也说明它不是严格的“无差异”判据;严格比较要算差的区间或做检验,本课没有展开具体的检验方法。
- 区间只描述被测场景、判据和次数下的不确定性。零失败的上界不是安全证明;区间计算和仿真结果都不是硬件安全验证。
链接
- 物理AI实验室:一套每个数字都能核对的物理 AI 课程(课程大纲)
- 物理AI实验室 2.7:安全过滤器,手算一步控制障碍函数修正,再算清它该挂在哪条回路、要留多少余量
- 物理AI实验室 1.8:评测,把“净增 2”拆成配对表,再给失败标签和随机种子算一笔账
- Henderson 等:Deep Reinforcement Learning that Matters(arXiv 1709.06560,HTML v1)
- Brown、Cai 与 DasGupta:Interval Estimation for a Binomial Proportion(Statistical Science 16(2),2001)