移動マニピュレーターや人型ロボットでは、VLA を搭載の組み込みボードで動かすしかありません。こうしたハードウェアでは言語バックボーンのプレフィル(prefill)が演算律速になり、その時間は制御ステップごとに入力される数百個の視覚 token に応じて増えます。既存の学習不要な高速化手法は、各ステップで視覚 token の一部だけを再計算し、残りはすべて枝刈りするか、すべて前回の KV キャッシュを再利用するかのどちらかです。ソウル大学とカーネギーメロン大学の著者らはプレプリント TRIAGE(arXiv 2610.34519、2026-10-25)で、再計算しない token を再利用すべきか枝刈りすべきかは、そのキャッシュがどれだけ「ドリフト」したかで決まり、token ごとに判断すべきだと主張しています。著者の報告では、LIBERO と SimplerEnv のシミュレーションで平均成功率は全再計算との差が 3 ポイント以内に収まり、Jetson AGX Orin でのプレフィル遅延は最大 48% 減りました。本記事では 3 点を読みます。再利用か枝刈りかを決める診断実験の手順、TRIAGE が各ステップで token を 3 つの集合に分ける方法、そして主結果表のプレフィル、エンドツーエンド、p99 の 3 種類の遅延がそれぞれ何を示すかです。以下の数字はすべて著者報告 [R] で、本サイトでは再現していません。
問題:再計算しない視覚 token をどう扱うか
論文が示す背景の数字です。OpenVLA は各ステップで 256 個、OpenVLA-OFT は 2 台のカメラから計 512 個の視覚 token を入力し、視覚 token は入力系列の約 90% を占めます。1 回の順伝播ですべての動作をデコードする OpenVLA-OFT では、プレフィルが各制御ステップの約 3 分の 2 を占めます(表 I)。著者は推論をリモートサーバーにオフロードしない理由も説明しています。その場合のエンドツーエンド遅延はネットワークに左右され、移動ロボットの無線リンクは変動や断絶があり、応答が 1 回遅れたり失われたりするだけで制御ループが止まるためです。
既存の 2 つの方式にはそれぞれ弱点があります。枝刈りは浅い層で各 token の重要度を見積もり、重要でない token を恒久的に捨てます。元に戻せないため、強く刈り込むとタスクに関わる token まで失います。再利用は前フレームからほとんど変わらない token を見つけ、その KV キャッシュを使い続けます。ただしそのキャッシュは前フレームの文脈で計算されたもので、シーンが変わると古くなり、繰り返し再利用すると誤差が蓄積します。著者の見方では、再計算集合の外にあるすべての token に同じ操作を当てはめると、計算を無駄にするか精度を落とすかのどちらかになります。重要だが変化していない token について、枝刈り方式は再計算するか捨てるかしかできません。重要でない token について、再利用方式はそれを残し、キャッシュが古くなっても使い続けます。著者の知る限り、token ごとに両者を選ぶ VLA 高速化手法はこれまでありませんでした。
診断実験:drift が再利用か枝刈りかを決める
著者が使う信号は drift です。浅い層(論文では第 2 層)における token の attention の value が、最後に再計算されたときからどれだけ相対的に変化したかを、attention ヘッドについて平均したものです。これらの浅い層は毎ステップすべての token で実行されるため、drift の計算に追加コストはかかりません。
診断は対照実験です。LIBERO-Spatial で全再計算を実行し(バックボーンごとに 20 エピソード)、その動作を基準にします。各「プローブ」は 16 個の token を取り出し、第 3〜31 層で一度は再利用、一度は枝刈りで扱い、それ以外の token はすべて再計算して、得られた動作が基準からどれだけ離れるかを比べます。その差を Δ とし、Δ が負なら再利用のほうが全再計算に近いことを意味します。キャッシュの経過は 1、2、5、10、20、40 クエリ(OFT は 20 まで)で、調べる token は drift と重要度をそれぞれ 3 段階に分けた 9 通りの組み合わせから抽出します。プローブ数は OpenVLA で 14,442 回、OFT で 9,925 回です。結果は次のとおりです。
- drift が 0.3 未満:両バックボーンで、全キャッシュ経過をまとめた Δ は負で、95% 信頼区間は全体がゼロを下回り、個々のキャッシュ経過で見てもゼロを超えません。再利用は枝刈りより悪くなりません。
- drift が 0.5 超:傾向が逆転し、古い KV を再利用した場合の動作誤差は枝刈りの 1.6 倍(OpenVLA)と 4.4 倍(OFT)になり、キャッシュが古いほど顕著です。
- 0.3〜0.5 の間:OpenVLA では再利用はまだ無害ですが、OFT ではすでに枝刈りよりわずかに悪くなります。したがってしきい値はバックボーンに依存し、著者は新しいバックボーンでは、全再計算のロールアウトだけで学習を必要としないこの診断を再実行して較正することを勧めています。
- 重要度とは無関係:著者はこの結論が token の重要度によらず成り立つとしています。キャッシュの経過が左右するのは再利用の利得の大きさです。OpenVLA では 20 や 40 クエリ前のキャッシュでも再利用のほうが良く、OFT では経過 10 からその利点が消えますが、再利用が有害になることはありません。
簡単のため、両バックボーンとも δ = 0.3 を使います。これは試した値のうち、どちらでも再利用が一度も有害にならなかった最大の値です。付録では δ を 0.2 や 0.4 に変えても、エンドツーエンドの成功率は統計的に変わりませんでした。
TRIAGE は各ステップで token をどう 3 つに分けるか
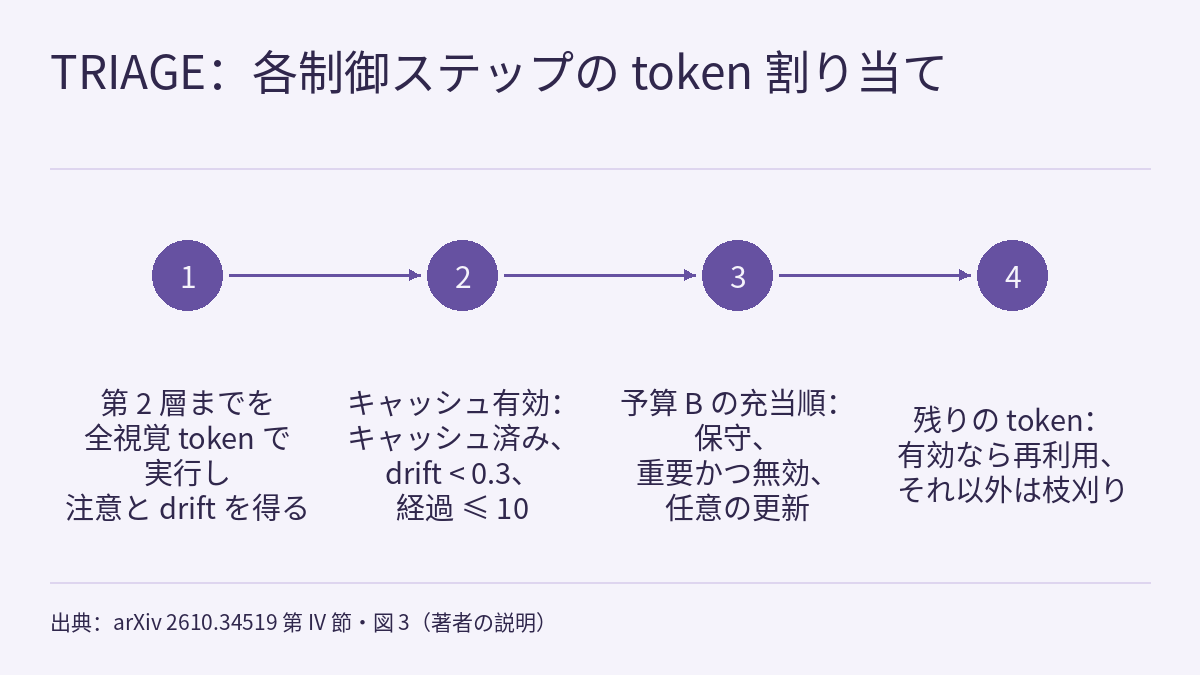
ここから 2 つの信号の役割が分かれます。キャッシュの有効性は、再計算しない token を再利用するか枝刈りするかを決めます。重要度は、限られた再計算予算をどこに使うか、すなわち重要なのにキャッシュがもう有効でなく、再利用も枝刈りも適さない token に回すかを決めます。
- 重要度:浅い層で動作デコード token がその token に向ける attention に、SAFE-Pruner から採用した深い層の顕著性予測メモリを加えたものです。メモリは最初のクエリでだけ記録し、その後はプロジェクター出力のコサイン類似度によるパッチ対応で現在のフレームへ移し、更新はしません。SAFE-Pruner はキーフレームで全 token を使って記録し直しますが、著者はそれがテール遅延を押し上げると指摘しており、TRIAGE はどのステップでも全 token のクエリを実行しません。重要度の上位 B + κ 個(κ = 70)を重要集合とし、あえて予算より大きくすることで、キャッシュがまだ有効な重要 token を再計算せずに再利用できるようにしています。
- 有効性:キャッシュが有効なのは、その token にキャッシュがあり、drift < 0.3 で、最後の再計算から T = 10 クエリ以内である場合に限ります。drift の基準値は直前のクエリではなく最後の再計算時に固定されるため、ゆっくりした変化も蓄積していずれ検出されます。経過の上限は保守的な安全策で、著者はこれを外しても成功率は有意に変わらないと報告しています。
- 予算 B の充当は優先順に、(1) 保守:重要集合の外でキャッシュが最も古い round(μB) 個の token(μ = 0.06)で、背景 token の再利用を維持するためのものです。(2) 必須の再計算:キャッシュが無効な重要 token と、重要集合に入ったばかりで、重要でないと判定されていた間にキャッシュが計算された token。(3) 任意の更新:残りの枠を、キャッシュが有効で変化が最も速い重要 token に回します。
- 残りの token:重要度とは関係なく有効性だけで決まり、有効なら再利用、そうでなければ枝刈りします。
枝刈りだけの方式と再利用だけの方式は、この分割で再利用集合が空の場合と枝刈り集合が空の場合という両極端にあたります。各ステップで再計算する token 数は常に B なので、プレフィル遅延は B で決まり、配備時には制御ループの遅延目標を満たす最大の B を選びます。実験では B を SAFE-Pruner の FLOPs に合わせ、OpenVLA で 88 個(256 個中)、OFT で 163 個(OFT-Goal は 91 個、512 個中)としました。ハイパーパラメータは主に LIBERO-Spatial の開発用エピソードで調整し、固定しています。
予算の掃引:両極端ではなぜ足りないか
図 4 は LIBERO-Object と OpenVLA で B を 88 から 18(視覚 token の 34% から 7%)まで下げ、予算ごとに 500 エピソード、Wilson の 95% 区間を報告しています。比較用の drop-all と keep-all は TRIAGE と同じ重要度の順位を使い、同じ B 個の token を再計算し、残りをすべて枝刈りするか、すべて再利用します。
- drop-all は予算が小さくなるにつれて着実に下がり、B = 18 で 22.4% です。保持しない token をすべて枝刈りする SAFE-Pruner は 19.4% です。
- keep-all は予算が大きいときは健闘しますが、B が 46 を下回ると崩れ、B = 18 で 0.0% になります。再計算集合を B に制限した VLA-Cache は 0.4% まで落ちます。どちらの極端が上回るかは予算次第で、B = 46 と 64 では keep-all、B = 28 では drop-all が上です。
- TRIAGE は B = 64 で全再計算と同等、B = 28(約 11%)まで下げても 3 ポイント以内に収まり、B = 18 でも 75.8% で、他の手法はすべて 51.4% 以下です。最強のベースラインである VLA-Pruner との比較(エピソード単位の対応のあるブートストラップ)では、B ≥ 46 で統計的に区別できず、B = 28 で 13.2 ポイント、B = 18 で 24.4 ポイント上回ります。
アブストラクトの「視覚 token の 7% だけを再計算して、最強のベースラインを 24.4 pp 上回る」は、この 1 つのスイート、1 つのバックボーン、B = 18 の 1 点を指しています。
主結果表:まずどの遅延かを区別する
下表は論文の表 I から抜粋したものです(LIBERO の 4 スイート、各 500 エピソード。遅延は Jetson AGX Orin、bf16、単位 ms)。遅延は同じ録画済み観測ストリームを再生し、スイートごとに 250 クエリで測ったもので、ロボットが閉ループで動いている間の計時ではありません。
| バックボーン / 手法 | 平均成功率 | FLOPs | プレフィル | エンドツーエンド | p99 |
|---|---|---|---|---|---|
| OpenVLA 全再計算 | 76.5 | 1.00× | 229.5 | 1261.3 | 1307.1 |
| OpenVLA VLA-Cache | 75.2 | 0.78× | 211.3 | 1365.7 | 1415.3 |
| OpenVLA VLA-Pruner | 73.3 | 0.39× | 204.5 | 1368.7 | 1428.5 |
| OpenVLA SAFE-Pruner(著者による移植) | 70.1 | 0.45× | 158.4 | 1166.6 | 1255.9 |
| OpenVLA SpecPrune-VLA(著者による再実装) | 70.2 | 0.40× | 171.4 | 1177.0 | 1248.1 |
| OpenVLA TRIAGE | 73.7 | 0.45× | 167.7 | 1173.4 | 1228.2 |
| OFT 全再計算 | 97.1 | 1.00× | 433.9 | 653.0 | 674.8 |
| OFT VLA-Cache | 96.2 | 0.77× | 421.5 | 702.3 | 774.2 |
| OFT VLA-Pruner | 95.8 | 0.53× | 328.3 | 555.2 | 765.8 |
| OFT SpecPrune-VLA(著者による再実装) | 96.8 | 0.46× | 240.6 | 460.7 | 672.4 |
| OFT SAFE-Pruner | 95.5 | 0.44× | 238.3 | 466.5 | 768.0 |
| OFT TRIAGE | 95.8 | 0.44× | 224.0 | 443.1 | 461.1 |
- 「最大 48%」は OFT のプレフィルです。224.0 ms 対 433.9 ms、つまり 0.52× です。OpenVLA ではプレフィルが 0.73×、エンドツーエンドは 0.93× にとどまり、著者はその理由を、全再計算の 1 ステップのうち 82% がプレフィル以外にあるためと説明しています。OFT のエンドツーエンドは 0.68× です。
- FLOPs が少ないことは Jetson で速いことと同じではありません。OpenVLA では VLA-Pruner の FLOPs は 0.39× ですが、エンドツーエンドは TRIAGE より 17%、VLA-Cache は 16% 長く、どちらも全再計算より遅くなっています。
- TRIAGE がすべての列で最速なわけではありません。OpenVLA では SAFE-Pruner のプレフィル(158.4 ms)とエンドツーエンド(1166.6 ms)が TRIAGE より低い一方、平均成功率は 3.6 ポイント低くなっています。著者の主張は、TRIAGE が成功率とプレフィル遅延のパレートフロンティア上にあり、より正確かつより速いベースラインはない、というものです。
- テール遅延。Jetson では、TRIAGE はすべての設定で p99 が最も低くなっています。OFT ではその p99 は平均より 4% 高いだけですが、SAFE-Pruner の p99 は平均の 1.6 倍に達します。著者はその原因を、後者がキーフレームで全 token の推論を行うことにあるとしています。固定予算の価値が最もはっきり現れるのはこの列です(本サイトの解釈)。
- 「3 ポイント以内」は平均値です。表 I をスイート別に見ると(本サイトの計算)、OpenVLA の TRIAGE は Long で 49.2%、全再計算は 56.0% で 6.8 ポイント差、OFT の Long は 88.6% 対 93.6% で 5.0 ポイント差です。
SimplerEnv(Google Robot、ベースの OpenVLA、再調整なし)では、TRIAGE の平均は 54.5%、全再計算は 54.8% で、SpecPrune-VLA と VLA-Pruner はそれぞれ 4.2 ポイントと 6.1 ポイント低くなっています。Jetson でのプレフィルは全再計算の 0.74× です。Move Near は設定ごとに 240 エピソード、Pick Coke Can は 297 エピソードです。
本サイトの他の記事との関係
フロンティア・レーダー特集|エッジとリアルタイム性 では、VLA と世界行動モデルのレイテンシ予算がどこに使われているかをまとめました。TRIAGE が対象とするのはそのうちプレフィルの部分だけで、OpenVLA のように Jetson 上でプレフィルが全再計算の 1 ステップの約 18% にすぎないモデルでは、エンドツーエンドの効果は限られます。フロンティア・レーダー|Fast-VLA も KV を使いますが、発想は逆です。VLM はエピソードごとに 1 回だけ考え、その結果をタスクメモリとして保存します。TRIAGE は制御ステップごとにバックボーンを呼び出し続け、再計算する視覚 token の数だけを減らします。著者は非同期実行、量子化、層スキップを TRIAGE と組み合わせられる直交した手段として挙げています。非同期の動作キューの時間計算は フィジカルAIラボ 2.3 を参照してください。こうした遅延の数字を読むときは、フィジカルAIラボ 0.3 の原則がそのまま当てはまります。ミリ秒の数字は、それを測ったモデル、ハードウェア、測定方法にだけ属します。「3 ポイント以内」や Wilson 区間は、フィジカルAIラボ 1.8:評価 の方法で分解できます。
制約と注意点
- arXiv のプレプリントで、数字はすべて著者報告 [R] です。本サイトでは再現していません。読んだ本文にはコードの公開の有無は書かれていません。
- 成功率はすべて LIBERO と SimplerEnv のシミュレーションによるもので、論文に実機実験はありません。遅延は録画済み観測ストリームの再生で測ったもので、搭載状態での閉ループ動作ではありません。シミュレーションの結果はハードウェアの安全性検証でもありません。
- 診断実験とハイパーパラメータ調整の大部分はどちらも LIBERO-Spatial を使っており、このスイートはホールドアウト評価ではありません。感度分析では調整に使っていない LIBERO-Goal を用い(OpenVLA、B = 28、既定値 70.6%)、どの単一の変更でも成功率の変化は 4 ポイント以内で、95% 区間はすべてゼロを含みます。経過の上限を外すと 68.6% です(対応のある差 −2.0 ポイント、95% CI [−6.2, +2.2])。区間の幅は約 8 ポイントあり、より小さな影響はこの実験では見分けられません(本サイトの推論)。
- OpenVLA の SAFE-Pruner は著者自身の移植(公式コードなし)、SpecPrune-VLA は静的段階のみの再実装(公開コードなし)です。主結果表の本文には信頼区間がなく、成功率の結果で区間を報告しているのは予算の掃引(Wilson 区間)と感度分析だけです。
- 著者自身も次の点を挙げています。δ、T、κ、λ、μ は経験的に設定した値であること。drift のしきい値はバックボーンによって異なることが観測されており、著者はタスクやシーンの速さによってもさらに変わりうると考えているため、配備中に適応的に調整する手法が必要なこと。drift は変化が起きた後にしか検出できないこと。
リンク
- TRIAGE: Efficient Vision-Language-Action Inference Needs Both Reuse and Pruning(arXiv 2610.34519)
- 論文 HTML 全文
- フロンティア・レーダー特集|エッジとリアルタイム性:VLA と世界行動モデルのレイテンシ予算はどこに使われているか
- フロンティア・レーダー|Fast-VLA:4B VLM はエピソードごとに 1 回だけ考え、実行器は動作チャンクごとに固定の KV タスクメモリを参照する
- フィジカルAIラボ 0.3:見る・考える・動く――3 つの周波数をそれぞれのシステムに戻す
- フィジカルAIラボ 1.8:評価――「差し引き +2」を対応表に分解し、失敗ラベルと乱数シードを計算で確かめる
- フィジカルAIラボ 2.3:SmolVLA をファインチューニングする――指示に合わせてお手本を計画し、各数字が何を測ったかを確かめ、非同期の動作キューの時間を計算する
- フィジカルAIラボ:すべての数字を確認できるフィジカルAI講座(講座の概要)