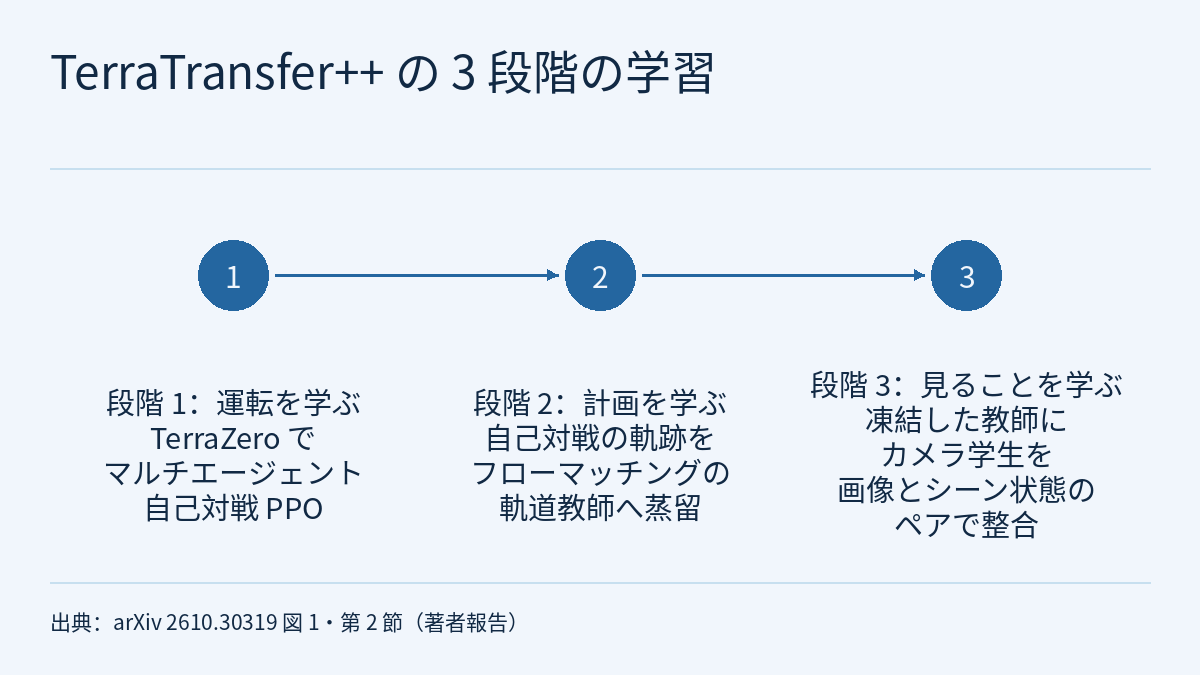
エンドツーエンドの自動運転は、通常まずフリートログに記録された人の運転を模倣することから始めます。しかし、衝突、ニアミス、立て直しといった安全上重要な事象は、ログの中にはごくわずかしかありません。Applied Intuition、UCLA、UC Berkeley の著者らはプレプリント TerraTransfer++(arXiv 2610.30319、2026-10-21)で順序を入れ替えました。まずベクトル化シミュレータ内のマルチエージェント自己対戦で運転を学び、次にこのベクトル状態を読む「教師」を、計画軌道も出力する 2 つ目の教師へ蒸留し、最後に(画像, シーン状態)のペアのフレームだけを使って、どちらかの教師をカメラ画像を読む学生に整合させます。どの段階でも、記録された人の軌跡を教師信号にはしません。著者報告では、計画学生は NAVSIM navhard で 59.4 EPDMS、navtest で 95.5 PDMS、閉ループ学生は HUGSim の 436 シナリオで閉ループ HD-Score 0.548 です。以下の数値はすべて著者報告 [R] で、本サイトでは再現していません。
なぜフリートログをそのまま模倣しないのか
論文の出発点はコストの計算です。NHTSA の衝突率では、自然な運転で衝突が起きるのはおよそ 1.6 万運転時間に 1 回で、論文が引用する推定では、こうした稀な事象を 1 件記録するだけで、フリート運用費だけでも 100 万米ドルを超えることがあります。模倣学習は記録されたドライバーが実際に取った行動しか写せず、ログの軌跡に対する開ループの強化学習では、自分が試した新しい行動に他の車両がどう反応するかが見えません。フォトリアルな描画を伴うシミュレータでの閉ループ RL なら結果は見えますが、毎ステップ描画と大きな視覚バックボーンの計算が必要で、複数のエージェントを一緒に学習させるとそのコストが何倍にもなります。
ベクトル化シミュレータでの自己対戦はこの計算を変えます。1 つの共有方策がすべての車両を制御し、方策が改善するたびに他の車両が直面する交通も変わり、相互作用の振る舞いが方策とともに進化します。論文が引用する関連研究によれば、この種のシミュレーションは一般的なハードウェアで毎秒数百万ステップを実行できます。問題は、自己対戦の方策が読むのはベクトル化されたシーン状態で、生のセンサーではないことです。展開するには、画像から HD マップ形式の入力を復元する知覚スタックが必要になります。TerraTransfer++ が取り組むのはまさにこの部分です。
フィジカルAIラボ 1.6:模倣学習では、ロボットがお手本のカバーしない状態に入ると誤差が雪だるま式に増えることを扱いました。フィジカルAIラボ 1.7:強化学習では、お手本ではなく報酬による試行錯誤を扱いました。この論文はその役割分担を運転に当てはめています。振る舞いは報酬と自己対戦から学び、画像は「見ること」を学ぶためだけに使います。
3 つの段階:運転を学ぶ、計画を学ぶ、見ることを学ぶ
段階 1、自己対戦の教師。シミュレータは著者らの TerraZero で、nuPlan の HD マップを車線トポロジー、車線境界、走行可能領域に変換します。学習には nuPlan に記録された軌跡、初期状態、目標、人の行動、再生交通を一切使いません。車両は車線中心線に沿って手続き的に生成され、各車両の目標は到達可能な車線グラフ上で 20〜100 m 先に置かれます。0.1 s ごとのステップで、車両は自分の運動状態と目標、近くの道路ポリラインと交通制御、周囲の物体を観測し、それぞれ ego、road、partner の 3 系統のエンコーダーに入ります。1 組のパラメータがすべてのシーンのすべての車両を制御し、行動は 12 個の離散的なジャーク(加加速度)行動で、PPO で最適化します。報酬は目標到達、衝突、快適性、車線への整列と中央維持、速度、交通ルールの遵守などの項の重み付き和です。GigaFlow の方法に従い、重みはエージェントごと・エピソードごとに再サンプリングされ、そのエージェント自身の観測に含まれます。著者らによれば、この方策は 16 基の A100 で 96 時間学習し、シミュレーション上の走行距離は 24 億 km を超えます。視覚の整合を行う前の段階で、nuPlan val14 で 94.19(それまでの最良の模倣プランナーは 92.28)、相互作用の多いロングテールの InterPlan で 70.87(比較対象は 63.66)、書き出した走行は WOSAC 2023 の人間らしさベンチマークで 0.632(記録データの参照値は 0.722)と報告されています。
段階 2、軌道教師。閉ループ方策はステップごとに 1 つの行動しか出しませんが、計画インターフェースや NAVSIM のような疑似閉ループ評価は数秒分の軌道を採点します。著者らは凍結した自己対戦教師が実際に走った結果を目標にします。各フレームについて、その後の 80 個の姿勢(10 Hz、8 s)を記録するもので、ログ中の人の軌跡ではありません。軌道教師は同じベクトル観測を読む 1120 万パラメータの Transformer で、フローマッチングのヘッドが軌道を生成し、推論時は 10 ステップの Euler 積分を行います。64 基の GPU で 1 時間自己対戦を回すと、こうした 8 s の軌道が 6 億本得られます。NAVSIM では、16 回の異なるノイズから 16 本の候補を生成し、他車両を等速で外挿した予測に対して衝突、TTC(衝突までの時間)、進捗で最も良い 1 本を選びます。この選択は真値の車両状態を読むため、論文は軌道教師を特権付きの参照として扱っています。
段階 3、視覚の整合。論文はまず閉ループ学生についてこの手順を説明しています。閉ループ学生は段階 1 の教師に直接整合し、段階 2 を経ません。教師の凍結された方策ヘッドと ego エンコーダーをそのまま使い、road と partner の 2 つのエンコーダーだけを画像を読むものに置き換えます。凍結した DINOv3 バックボーンに別々の線形アダプターを 2 つ付け、学習するのはアダプターだけです。教師信号は 2 つあります。1 つ目は教師と学生の行動分布の順方向 KL ダイバージェンスで、サンプルされた行動だけでなく分布全体を合わせます。2 つ目は構造損失で、各バッチで教師の特徴の主部分空間(partner は先頭 13 次元、road は先頭 9 次元。累積エネルギー 80% の打ち切り点)を取り、バッチ内のシーン同士のコサイン類似度だけを学生に再現させます。重みは λ = 0.5 です。
計画学生は同じ手順を軌道教師に適用したもので、いくつかの違いがあります。凍結した DINOv3 バックボーンと軽量なアダプターが、画像から軌道教師の 20 個の種類別潜在トークン(road、partner、交通制御の 3 種類)を予測します。行動損失は軌道教師の行動ヘッドに対する KL ダイバージェンスで、構造損失は平坦化した潜在トークンに種類ごとに適用し、重みは同じく λ = 0.5 です。ego エンコーダー、融合層、行動と軌道の 2 つのヘッドは凍結したまま、予測された潜在トークンを読みます。さらに、軌道教師が 16 本から選んだ計画に 80 個すべてのウェイポイントで合わせる L2 損失が重み 1 で加わります。推論時の学生は 1 本だけサンプルし、選択は行わないので、真値の状態は読みません。
著者らは、「先に知覚し、その結果を凍結した教師に渡す」カスケードを避ける理由も説明しています。知覚モジュールは検出などの代理目的で学習するため、その誤差には運転品質からの勾配が届きません。また教師はきれいなシミュレータ状態で学習しており入力ノイズに弱く、復元が不完全な入力はその性能を下げます。
「デモなし」で使わないものは何か
ここでの「デモなし」は、記録された軌跡を教師信号に使わないという意味で、実データを使わないという意味ではありません。閉ループ学生の主実験の整合データは約 183 万フレームの nuPlan のペア(256 フレームのシャード 7,129 個、10 Hz で約 51 時間)で、各フレームの目標は再構成したシーン上での教師の行動分布です。画像は記録された実際のカメラ画像で、シーン状態には知覚ラベルが必要です。著者らはこのラベルを方策に依存せず、オフラインの自動ラベリングで得られるものと説明しています。論文の 2.4 節で説明される閉ループ学生の設定では、ログ中の自車軌跡の終点が、目標信号として学生の ego ベクトルに入ります。このほか HUGSim のドメイン適応用フレームが 30 万枚あり、評価シーンそのものから描画されていますが、それらのシーンの総ルート長の 10% しかカバーしていません。この閉ループ学生の整合は 8 基の A100 で 10 時間です。計画学生は、3.1 節にあるとおり NAVSIM navtrain だけで整合しています。著者らの見積もりでは、学習ループ内で描画すると、ベクトルでのロールアウトより約 6,000 倍遅くなります(全カメラ合計で 17.5 万 fps 対 30 fps)。
著者らはこれを、フリートログが「見たもの」は使い続けるが、ログが「したこと」はもう使わない、とまとめています。一方で、ブレーキランプや手信号のようにバウンディングボックスの状態に含まれない視覚的手がかりには、模倣学習が引き続き役立つとも書いています。
結果:2 つの学生はそれぞれ何と比べているか
HUGSim の閉ループ。HUGSim は 3D Gaussian splatting に基づくフォトリアルな閉ループベンチマークで、436 シナリオが nuScenes(88)、PandaSet(127)、KITTI-360(113)、Waymo(108)の 4 分割に分かれ、それぞれ Easy、Medium、Hard、Extreme の 4 つの難易度区分があります。シナリオ数で重み付けして集計すると、ベクトル状態を読む教師の閉ループ HD-Score は 0.562、カメラ学生は 0.548(教師の約 97.5%)、HUGSim のネイティブ採点では 0.528 です。表中で最も強いベースラインの ECO は学生より 0.120(閉ループ)、0.184(ネイティブ)低く、模倣で学習した LTF、UniAD、VAD の閉ループは 0.266、0.244、0.187 です。ベースラインはすべて著者らが公開チェックポイントから再実行した結果で、UniAD、VAD、LTF は現在のシーンと地図で再実行されています。学生は軌道を出力しないため、ネイティブ採点には著者らが「減速の代替計画」と呼ぶものを渡します。実際に実行した最初の 1 ステップに、快適性の制約内で止まる計画をつなげたもので、構造上、快適性の上限を必ず満たします。論文は、分割をまたいで絶対値を直接比べられないことにも注意を促しています。
弱点は Extreme 区分です。学生は閉ループ 0.162、ネイティブ 0.137 で、教師も 0.158 と 0.136 にとどまり、ECO や模倣ベースラインが一部の分割で上回ります。著者らによれば、この区分には不自然なシナリオがあり、自車が何をしても他の車両がぶつかってきます。そのため、反応せずにまっすぐ加速するだけの方策が閉ループで 0.227 を取り、反応するどの方策よりも高くなります。学生は教師と同じく停止して譲り、ルート完了を犠牲にします。これはこの区分の採点についての著者らの解釈です。
同時期の「自己対戦からピクセルへ」の手法との比較。GigaPixel と DriveZero は旧版の 345 シナリオのプロトコルでネイティブ HD-Score(0.385 と 0.466)を報告しており、チェックポイントは公開されていません。著者らは同じ 345 シナリオで自分たちの手法を評価し直し、教師 0.527、学生 0.518 と報告しています。ただし採点対象が異なります。著者らの数値は減速の代替計画で、ほかの 2 手法はそれぞれの方策が出力した計画で採点されています。
NAVSIM の疑似閉ループ計画。NAVSIM は 4 s の計画を採点します。計画学生は NAVSIMv2 navhard で 59.4 EPDMS で、DriveZero-Scale(57.1)より 2.3 ポイント高く、特権付きで 16 本から 1 本を選ぶ軌道教師(62.1)より 2.7 ポイント低い値です。NAVSIMv1 navtest では 95.5 PDMS で、DriveZero-Scale は 95.3 です。表のベースラインは He ら(2026、DriveZero の論文)がまとめた公開済みの結果です。著者らは学生の弱点を安全余裕と摂動後の立て直しとし、教師と同じ傾向だと述べています。navtest の TTC サブスコアは 92.2(教師 93.2、DriveZero-Scale 97.3)、navhard のステージ 2 の DAC サブスコアは 90.2(教師 90.4、DriveZero-Scale 95.6)です。つまり総合スコアでは上回る一方、この 2 つのサブスコアはどちらも DriveZero-Scale を下回ります。
アブレーション:同じデータで教師信号の出所を変える
論文の表 4 は nuScenes 分割で、183 万フレームの nuPlan のペア(HUGSim のドメイン適応用フレームは含まない)、知覚ラベル、計算予算を固定し、教師信号の出所だけを変えています。nuPlan の記録行動の模倣は 0.206、SparseDrive でベクトル入力を復元して凍結した方策ヘッドに渡すモジュール型カスケードは 0.361、自己対戦の教師と整合の組み合わせは 0.574 です。損失を 1 つ外すと、行動項だけでは 0.434、構造項だけでは 0.373 です。ランクのアブレーションは、ドメイン適応用フレームを含む主実験のデータを使い、436 シナリオ全体で行われています(表 3)。partner/road を 7/5 次元にすると 0.517、打ち切り点の 13/9 次元で 0.548、26/18 次元で 0.533、全座標を合わせると 0.456 です。
著者らは特権付きのプローブも試しています。視覚エンコーダーを、ベクトル観測を読む教師と同じ構造の初期化し直したエンコーダーに置き換え、同じ損失とデータで学習させるものです。nuScenes で 0.645 と教師の 0.647 にほぼ並び、著者らはここから、整合の目的関数そのものはほとんど性能を失わないと結論しています。同じデータでのカメラ学生は 0.574 で、著者らはこの 0.071 の差を知覚のコストと nuPlan から HUGSim へのドメインギャップを合わせたものとしています。ドメイン適応用フレームを加えると 0.636 となり、プローブとの差は 0.009 です。著者らはこの残りの差を観測の非対称性の問題に対応づけています。教師が読むベクトル状態には、カメラから見えない車両が含まれうるという問題です。結論では、隠れによる要因を他の知覚誤差からまだ切り分けていないことも明記しています。
これらの数値を読むときも、フィジカルAIラボ 1.8:評価の問いがそのまま当てはまります。各アブレーションは 1 つの分割または 1 組のシナリオで行われ、読んだ本文には複数シードや信頼区間の報告がありません。0.002 や 0.009 のようなごく小さな差は、確かな結論として読まないほうがよいでしょう。
制約と注意点
- arXiv のプレプリントで、数値はすべて著者報告 [R] です。本サイトでは再現していません。読んだ本文は参考文献の冒頭までで、付録(環境設定、報酬項、難易度区分別の内訳、バックボーンのアブレーション)は読んでいません。読んだ本文には、コード、重み、TerraZero が公開されるかどうかの記載もありません。
- 著者の多くは Applied Intuition の所属で、TerraZero は自社のシミュレータです。HUGSim のベースラインは著者らが再実行したもので、NAVSIM のベースラインは DriveZero の論文がまとめた値です。
- 「デモなし」は記録された軌跡を教師信号に使わないという意味にとどまります。閉ループ学生の整合には、実際のカメラ画像、シーン状態のラベル、(2.4 節の設定での)目標としてのログ中の自車軌跡の終点が必要です。HUGSim のドメイン適応用フレームは評価シーンそのものから描画されています(ルート長の 10% をカバー)。計画学生は NAVSIM navtrain だけで整合しています。
- HUGSim のネイティブ採点と 345 シナリオの比較では、学生は自分で出力した軌道ではなく、快適性の制約内の減速の代替計画で採点されています。軌道教師の 16 本からの選択は真値の状態を読む特権付きの参照で、展開できる手法ではありません。
- 評価はすべてシミュレーション、またはログに基づく疑似閉ループのベンチマークで行われており、読んだ本文に公道での実車試験はありません。これらのスコアは安全性の検証ではありません。著者らが結論で今後の課題として挙げているのは、教師がカメラから見えない隠れた車両に基づいて判断しうること、そして nuPlan のログと再構成シーンから取る整合データには、悪天候、珍しい時間帯、まれなシナリオ形状がほとんど含まれないことです。
リンク
- TerraTransfer++: Demonstration-Free End-to-End Planner(arXiv 2610.30319)
- 論文の HTML 全文
- フィジカルAIラボ 1.6:模倣学習――誤差がお手本のカバー範囲からはみ出すまでを手で計算し、ACT・拡散方策・データのスケーリング則の数字をそれぞれの条件に照らして読む
- フィジカルAIラボ 1.7:強化学習――1 回分の収益を手で計算して報酬の抜け道を見つけ、論文の地形カリキュラムとタイムアウト時のリセットを読む
- フィジカルAIラボ 1.8:評価――「差し引き +2」を対応表に分解し、失敗ラベルと乱数シードを計算で確かめる
- フィジカルAIラボ:すべての数字を確認できるフィジカルAI講座(講座の概要)