人形机器人做移动操作(loco-manipulation),要同时管行走、平衡和与物体的交互:示范数据少,从零做强化学习又很难。来自慕尼黑工业大学(TUM)、麦吉尔大学和 INRIA 的作者在预印本 DiPLO(arXiv 2610.24847,2026-10-17)里把两件事分开:扩散运动规划器负责生成机器人全身和物体的运动,另一个用强化学习训练的全身跟踪策略负责执行。论文最值得看的是训练顺序:预训练时,规划器依赖由人类动作重定向得到的运动学参考;后训练先用自蒸馏(SD:DPO)把这个参考拆掉,再用扩散强化学习(DA:PPO)让规划器适应冻结的跟踪器。作者报告,仿真中的抓取-搬运-放置任务成功率从 45.4% 升到 98.8%,在 Unitree G1 真机上 15 次执行全部成功,没有做真机微调。以下数字均为作者报告 [R],本站未复现。
分工:规划器生成全身与物体运动,跟踪器负责执行
规划器是一个以 Diffusion Transformer(DiT)为去噪器的条件扩散模型。输入是机器人与物体的状态历史,以及目标物体位姿(相对物体当前位姿表示);可选输入是 IK 重定向得到的运动学参考。输出是一段 n 帧的机器人-物体运动。每帧状态包括平面根位移、朝向变化、根高度、根姿态、29 个关节位置,以及物体的位置和姿态;旋转用连续 6D 表示编码,每帧共 48 维特征。欧氏特征用余弦噪声调度的方差保持(VP)扩散和 v 预测;根姿态与物体姿态则在 SO(3) 上单独扩散。
跟踪器是一个通用跟踪策略,在 mjlab 中用 PPO 训练,学习跟踪动力学可行的参考运动。它以 50 Hz 运行,读取规划运动在未来 1、2、4、8 帧处的参考,输出叠加在参考关节位置上的残差,作为 PD 控制器的关节目标。执行时形成闭环:跟踪器只执行运动块的前 m ≤ n 帧,规划器再从测得的状态重新规划。论文强调,这样重规划时考虑的是实际执行出来的运动,包括跟踪误差。
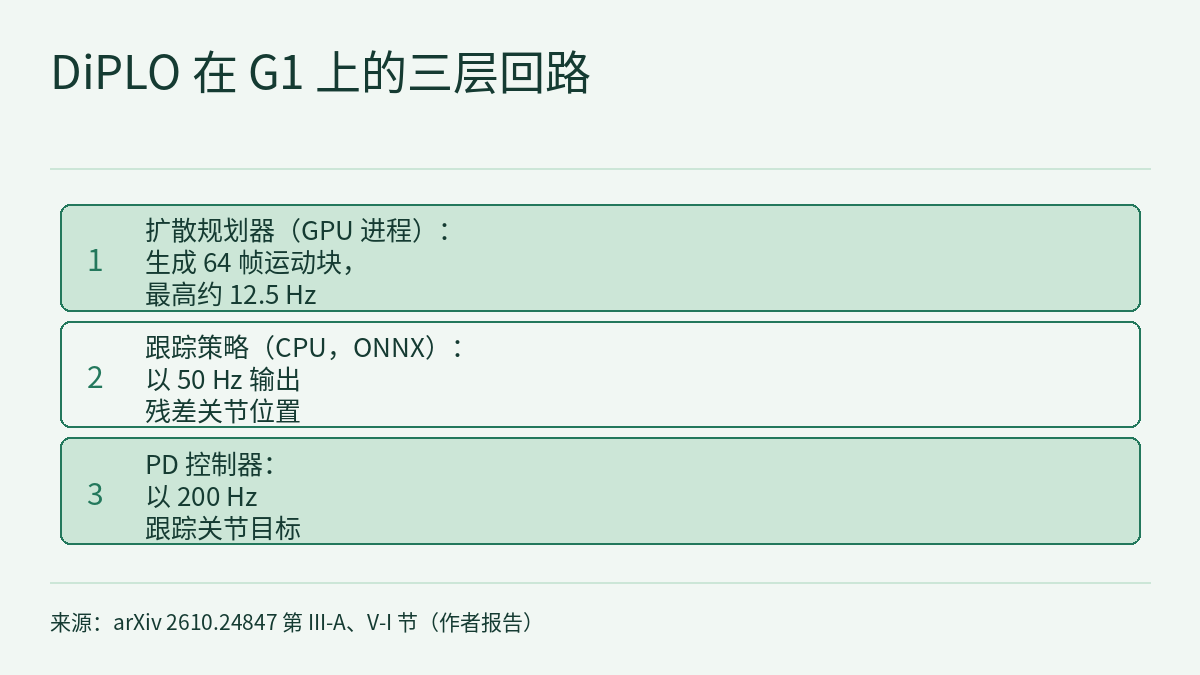
真机部署时,三个频率写明属于同一套系统:规划器作为独立进程在 GPU 上运行,用 10 步去噪生成 64 帧运动块,对应 1.28 s;算上通信延迟和扩散采样,最高约 12.5 Hz。跟踪器在 CPU 上通过 ONNX Runtime 以 50 Hz 运行,新运动块到达前继续执行当前这一块;PD 控制器以 200 Hz 跟踪关节目标。按 12.5 Hz 算,新运动块最快约每 80 ms 到达一次,相当于跟踪器的 4 个控制步(本站换算);所读文本没有给出真机上的 m。物理AI实验室 0.3:看-想-动强调,来自不同数据集、模型和接口的频率不能拼成一台机器人的参数;DiPLO 这三个频率则出自同一份部署说明,可以按层并列阅读。
预训练:29 段示范、动力学可行的扩增,以及参考条件为什么重要
起点是一个已有数据集(OmniRetarget)中的 29 段重定向机器人-物体运动,合计 2.7 分钟。运动学重定向不保证机器人的动力学和接触约束成立,作者因此用 DynaRetarget 中的采样式轨迹优化(SBTO)把每段参考细化成动力学可行的运动:扰动初始条件、改变优化种子,得到同一段示范的多个可行变体;再沿矢状面镜像,并利用箱子的四分之一转旋转对称继续扩增。每个训练样本都由一段运动学参考和一段可行的目标运动组成。预训练时,50% 的样本把参考换成空 token,让同一个网络学会两种条件下的去噪。
扩增的作用见论文表 I(预训练模型的闭环生存率):只用原始运动为 90.0%,加对称为 90.7%,加 SBTO 变体为 92.3%,两者都加为 96.5%。两种扩增都用时,DA:PPO 后训练把生存率提到 100.0%、任务成功率提到 96.4%;不做扩增的模型后训练后只有 93.3% 和 72.3%。同一张表还让跟踪器直接执行参考本身:跟 IK 重定向运动时生存率 93.5%、成功率 53.0%,跟 SBTO 解时为 100.0% 和 61.6%。两种情况的任务成功率(53.0% 和 61.6%)都低于后训练规划器的 96.4%。
参考条件的作用见论文第 V-B 节。作者用七种不同的任务先验各预训练一个模型:以完整的 IK 重定向机器人与物体运动为条件时表现最好;直接用 OMOMO 数据集中未经重定向的人体与物体位姿,生存率约低 9%;末端执行器与物体参考只保留每 5 帧一帧,与稠密参考相比没有观察到明显下降;只保留物体运动,生存率降到约 70%;完全不给先验,约 45%。作者的结论是:在这种小数据量下,预训练需要强任务先验。这对应物理AI实验室 1.5:数据从哪来里“人手不是机器手”的问题:DiPLO 把人体动作翻译成机器人数据分两步,先运动学重定向,再做动力学可行性优化。
后训练两步:SD:DPO 拆掉参考,DA:PPO 对齐冻结的跟踪器
直接去掉参考,预训练模型的表现会明显变差。作者的解释是:规划和跟踪误差会把系统带到训练数据覆盖不好的状态,在这些状态上数据给不出怎样继续运动的指导。SD:DPO(Self-Distillation Diffusion Policy Optimization)的做法是:
- 学生只接收状态历史、目标和空 token,教师另外接收运动学参考;两者都从预训练规划器初始化。
- 每个规划步,学生和教师各生成一段运动,以 1/2 的概率选一段,由冻结的跟踪器在仿真中执行前 m 帧。无论执行的是哪一段,学生的提议、起始上下文和对应的参考都存入缓冲区;失败的回合终止并重置,之前收集的提议仍保留,包括与失败相关的那些。
- 训练时取出一段存储的提议,按均匀采样的扩散步加噪;教师和学生拿到同样的带噪运动、扩散步和上下文,只有教师多看到参考。损失是两者在欧氏与旋转部分的去噪预测之间的均方误差,梯度只经过学生,教师的预测作为固定目标。
- 这个损失和原来的数据预训练损失、一个锚定损失一起训练;锚定损失约束学生带参考时的预测不偏离冻结的预训练副本。教师用学生权重的指数滑动平均更新。
这一步不需要奖励。作者称它借鉴了语言模型中的 SDPO:以额外信息为条件的同一个模型当“自教师”。
第二步 DA:PPO 把每一个去噪步当作一次决策(Diffusion-Augmented MDP):执行前 m 帧得到的环境奖励只记在最后一个去噪步上,再经贝尔曼递推传给生成这段运动的各个去噪决策。最大熵正则项用反向与正向转移密度之比计算,温度控制强度,用来保持生成计划的多样性。微调时跟踪器保持冻结,规划器只接收状态历史和目标。论文指出,DPPO 靠截断去噪过程来探索,可能导致动作抖动,这正是人形控制要避免的。
论文表 V 把两步的作用拆开(抓取-放置任务):
| 规划器 | 生存率(%) | 任务成功率(%) |
|---|---|---|
| 无先验预训练 | 46.9 | 32.2 |
| 无先验预训练 + DA:PPO | 74.1 | 67.0 |
| 自教师(预训练,带参考) | 96.5 | 51.9 |
| 学生(预训练,参考置空) | 57.7 | 45.4 |
| 学生 + DA:PPO | 92.1 | 92.1 |
| 学生 + SD:DPO | 100.0 | 55.1 |
| 学生 + SD:DPO + DA:PPO | 99.5 | 98.8 |
摘要中的“约 99% 对 45%”,比的是最后一行和参考置空的学生;带参考的自教师成功率为 51.9%。从表中能读出(本站解读):SD:DPO 单独使用主要提升生存率(57.7% → 100.0%),成功率只从 45.4% 到 55.1%;只做 DA:PPO 已到 92.1%;两步都做,成功率再高约 6.7 个百分点,生存率也更高。不带参考预训练的模型即使做 DA:PPO 也只有 67.0%,作者据此强调预训练阶段参考条件的重要性。踢物体和推/拉两组任务各自单独预训练规划器:踢物体的学生成功率从 1.2% 经 SD:DPO 到 31.9%,再经 DA:PPO 到 68.1%(自教师 34.4%);推/拉从 12.8% 到 21.7%,再到 52.7%(自教师 23.3%)。这两组没有“学生 + DA:PPO”一行,无法单独分出 SD:DPO 的贡献。
指标的口径:生存率指机器人既没摔倒、也没掉落物体的回合比例;任务成功率指在生存回合中,最终物体位姿距离目标在 15 cm 和 30° 以内的比例。仿真结果是不同参考运动上的均值 ± 标准误,每段运动跑 100 次。
其他消融:SO(3) 扩散、运动级与动作级、奖励,以及调规划器还是调跟踪器
- SO(3) 扩散:只改变旋转特征的扩散方式,在 SO(3) 上扩散时生存率 96.5%、成功率 51.9%、物体姿态误差 14.0°;把 6D 坐标当欧氏量扩散时为 85.9%、46.4%、19.6°。
- 运动级与动作级扩散:三种方法拿到相同的任务信息(状态、目标物体位姿、IK 重定向运动)。DiPLO 的状态扩散加跟踪器为 96.5% / 51.9%;按 PDP 做法构建的动作扩散为 87.5% / 45.3%;按 BeyondMimic 做法构建、在推理时引导的状态-动作扩散为 58.2% / 8.2%。两个基线用预训练跟踪器在扩增数据上的回放做行为克隆,以 50 Hz 每步重规划、只执行第一个动作。作者的论证是:生成式学习相当于前向 KL 拟合,近似不完美时,模型可能把概率放到几个动作模式之间的区域;在动作层面,这样的样本直接变成关节指令,可能破坏平衡或接触。物理AI实验室 1.6:模仿学习用左绕、右绕被平均成一次碰撞讲过同一类问题;DiPLO 的做法是让扩散模型生成运动,再由在仿真中通过 RL 学过纠错的跟踪器执行。
- 奖励:DA:PPO 用紧跟稠密 IK 重定向运动的奖励
r_kin时,成功率 96.4%、MPKPE 4.3 cm;用接近目标加生存奖励的r_goal时为 92.9%、8.0 cm。r_kin只在有重定向示范的地方才能计算,r_goal不需要。物理AI实验室 1.7:强化学习讲过奖励写法决定策略学到什么;这里两种奖励都提升了生存率和成功率,r_goal不依赖示范,但成功率略低、跟踪误差更大。 - 最大熵:不带温度的 DPPO 式更新为 99.1% / 94.0%,DA:PPO 为 100.0% / 96.4%,跟踪误差也更低。作者去掉了原始 DPPO 注入额外扩散噪声的做法,因为它导致不稳定、难以跟踪的行为;作者把 DA:PPO 的优势归因于最大熵目标,并引用文献称 DPPO 式目标会出现严重的模式坍缩。
- 调规划器还是调跟踪器:规划器保持预训练、只用 PPO 微调跟踪器 1000 次迭代,成功率 87.9%(加目标项为 89.3%);跟踪器保持预训练、用 DA:PPO 微调规划器,成功率 96.5%。表 I 写明规划器微调为 500 次迭代、2048 个并行环境;所读文本没有给出两种微调的算力对比。
泛化与真机:88% 的目标网格和 15 次执行
去掉参考后,规划器可以接受数据集中没有的目标位姿。作者在机器人起点周围的极坐标网格上放置目标,距离 0.5 到 5 m,每个位置再取 0°、90°、180°、270° 四个朝向;示范中最远的目标在 1.9 m。每个目标位姿跑 100 次,物体初始位姿随机偏移最多 5 cm 和 12°。经 SD:DPO 和 DA:PPO 的学生在这个网格上生存率约 100%,任务成功率 88%。这是仿真结果。
真机实验用 29 自由度的 Unitree G1 做抓取-搬运-放置。关节编码器和机载 IMU 提供本体状态,外部动作捕捉系统跟踪机器人基座和物体。论文表 VII 的结果:
| 实验 | 成功 | MPKPE(cm) | 最终物体位置误差(cm) | 最终物体姿态误差(°) |
|---|---|---|---|---|
| 同一目标重复 10 次 | 10/10 | 6.5 ± 0.7 | 1.8 ± 0.8 | 3.4 ± 1.1 |
| 5 个不同目标各 1 次 | 5/5 | 6.8 ± 1.1 | 5.7 ± 5.0 | 12.8 ± 12.5 |
表中误差为执行间的均值 ± 样本标准差。读这组数字要注意三点:一共 15 次执行;所读文本没有写明真机的成功判据是否沿用仿真的 15 cm 与 30°;摘要称真机用的是 DA:PPO 规划器-跟踪器,但第 V-I 节没有写明这个规划器是否经过 SD:DPO、是否仍接收运动学参考,5 个不同目标是否落在示范范围之外也没有说明。物理AI实验室 1.8:评测里关于次数、条件和失败类型的问法,同样适用于这组 10/10 和 5/5。
本站此前的前沿雷达|HWAM处理的是相近的问题:人形机器人的参考动作不等于实际执行出来的动作,HWAM 让策略同时生成参考动作和执行后的本体状态。DiPLO 的做法不同:冻结跟踪器,从测得的状态重规划,并用执行回报微调规划器。两篇论文的任务和评测不同,数字不能直接比较。
局限 / 注意
- 这是 arXiv 预印本,全部数字为作者报告 [R],本站没有复现。所读文本没有提到代码或模型权重的发布。
- 所有定量消融都在仿真中完成。真机只测了抓取-搬运-放置一个任务、共 15 次执行,依赖外部动作捕捉;作者把机载感知列为未来工作。仿真结果和这组真机执行都不是硬件安全验证。
- 抓取-搬运-放置的数据只有 29 段示范,对称扩增用的是箱子的旋转对称;踢物体和推/拉任务各自单独预训练规划器。作者把单一模型覆盖多种技能、更多样的物体与环境列为未来工作。
- “45% → 99%”比较的是参考置空的预训练学生和完整后训练的学生;任务成功率只在生存回合中统计。引用时应带上这两个口径。
- 动作级基线是作者按 PDP 和 BeyondMimic 的做法构建的,不是这些工作发布的结果。表 VI 写明跟踪器微调为 1000 次 PPO 迭代;所读文本没有给出表 VI 中规划器微调的迭代数或算力,因此两组实验无法按训练预算比较。
- 本文依据论文 HTML 正文到参考文献开头,没有读附录中的奖励、超参数和网络结构细节。
链接
- DiPLO: Self-distilled Diffusion Planning for Loco-manipulation(arXiv 2610.24847)
- 论文 HTML 全文
- 物理AI实验室 0.3:看-想-动,把三个频率放回各自的系统
- 物理AI实验室 1.5:数据从哪来,从 SO-101 元数据算出示范时长,再分清三条来路的单位与动作空间
- 物理AI实验室 1.6:模仿学习,手算误差怎样滚出示范覆盖范围,再把 ACT、扩散策略与数据规模律的数字放回各自条件
- 物理AI实验室 1.7:强化学习,手算一局回报看奖励怎样被钻空子,再读论文里的地形课程与超时重置
- 物理AI实验室 1.8:评测,把“净增 2”拆成配对表,再给失败标签和随机种子算一笔账
- 前沿雷达|HWAM:人形机器人的参考动作不等于实际动作,把执行后的本体状态和动作一起生成
- 物理AI实验室:一套每个数字都能核对的物理 AI 课程(课程大纲)