把几个技能接成一串,难点常常不在单个技能,而在技能之间的那段过渡:上一个技能结束时的状态,未必是下一个技能在训练中见过的起点。预印本 DexStitch(arXiv 2610.17789,2026-10-13)的做法是把“过渡”也定义成一个普通的技能标签,对长程人类视频(共约 240 段)人工逐帧标注一部分、再用分类器把其余的切成技能和过渡,然后借助逐指接触估计把人手换成灵巧手机器人,得到带技能标签的机器人观测与动作;过渡的监督全部来自人类视频,遥操作只补了约 32 段单技能示范。作者报告,四个家务技能的单技能成功率 80.0%,四技能序列中 77.5%,分类器与人工标注的逐帧一致率 92.4%。读这篇论文时值得先弄清 77.5% 数的是什么,以及它只在一种固定顺序上测过。以下数字均为作者报告 [R],本站未复现。
问题:技能之间的过渡由谁来监督
作者把长程操作看成“基本技能 + 连接它们的过渡”。要让技能能按顺序执行,两者都需要监督,而在机器人上靠遥操作和人工标注采集,成本很高;人类视频容易录,却没有机器人动作,也没有技能标签。论文把已有工作分成两条路线:一条在人和机器人之间学共享的潜在技能空间(XSkill、UniSkill),技能结构经由连续潜变量传递,策略不知道下一个技能是什么;另一条重定向人的动作并把人换成渲染的机器人(Phantom、Masquerade、H2R、EgoEngine),但一段示范被当作一整条轨迹,没有标出技能和过渡的边界。
DexStitch 选了相反的方向:先由用户固定一个技能集合,把过渡作为其中一个标签,人工逐帧标注一部分视频,训练分类器去切其余视频。由于每一对有序技能都需要各自的过渡,作者录的是包含多次过渡的长程人类视频,而不是逐个采集过渡。
从人类视频到机器人数据:接触引导的重定向与四层合成
转换分三步,逐帧进行,因此每一帧转换后仍保留源帧的技能标签:
- 手部姿态与接触:HaWoR 在相机坐标系里拟合 MANO 手模型,给出手部关键点和手腕位姿;HaCo 在 MANO 顶点上预测接触概率,按手指汇总,再用带滞回的阈值得到时间上稳定的逐指接触状态,并保留每根接触手指的接触点。
- 接触感知的重定向:先用 DexPilot 匹配手腕到指尖的向量,得到运动学初值;因为人手和机器人手形状不同,只对齐指尖未必能碰到人实际接触的点,所以第二步用 L-BFGS-B 优化关节角,最小化每个人手接触点到机器人指尖表面最近点的距离(只取法向与人手接触点法向一致的表面点),并加二次正则项让解靠近第一步。手臂部分先用 EasyHeC 标定一次相机到底座的变换,再解逆运动学;逐帧结果用中值滤波和 Savitzky–Golay 滤波平滑。
- 修补与合成:SAM2 跟踪两组掩码,人手与手臂、被操作的物体;ProPainter 修补人手区域,同时保护物体掩码;再按重定向的构型和标定的位姿渲染机器人。
直接把机器人叠在画面上,会让本该绕到物体后面的手指画在物体前面。作者的处理依赖一个假设:手包住物体时,拇指在物体前方,其余手指弯到后方,构成对握。于是把非拇指的接触手指的三维接触点投影到图像中,膨胀成连通区域,与物体掩码重叠的地方让物体画在机器人前面。每帧从后到前合成四层:
- 修补后的背景
- 被物体挡住的机器人手指
- 从源帧复制的物体(不用修补后的画面,因为修补恰好会改动手与物体接触的区域)
- 其余的机器人像素
论文说明,这条流程只用 RGB 视频,不需要物体网格、深度或物理仿真器。转换质量只做了定性比较(图 4:握海绵、提零食纸盒、把杯子挂上架子):作者描述,Masquerade 的平行夹爪表达不了灵巧抓取,并把夹爪画在物体上面;去掉接触引导的遮挡处理后,手被画在物体前,抓取看起来像悬在半空。论文没有给出转换质量的量化指标。
技能分类器与带“下一技能”条件的策略
分类器:冻结的 V-JEPA 2 视频编码器加一个小 MLP 头,可训练参数只有 296K。编码器以 4 FPS 采样、每两帧输出一个 token,因此分类器以 2 Hz 读视频;它看最近 8 个 token(4 秒上下文)的因果窗口,预测最新时刻的技能。作者认为,正因为编码器冻结,才能用手头少量标注过的会话拟合分类器。逐帧预测再经时间滤波,合并成有序的技能段序列。
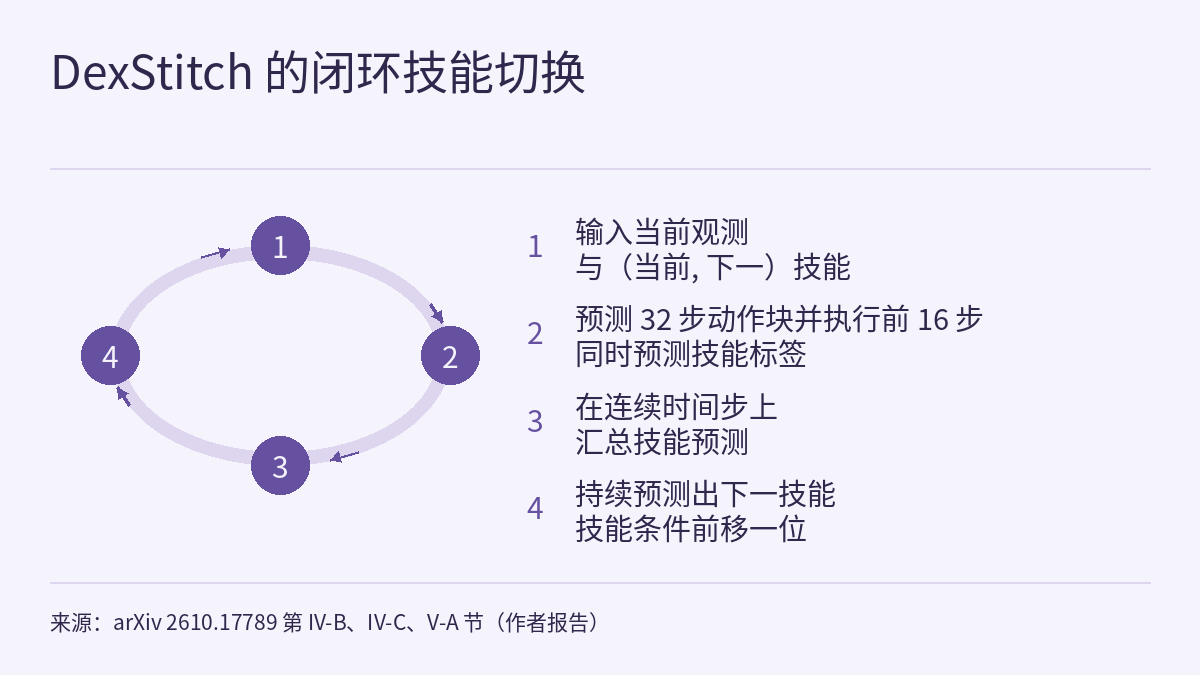
策略:一个共享的 Diffusion Policy,条件是当前观测、当前技能和下一技能,输出一段动作块,并同时预测这段时间的技能标签。当前技能决定做什么,下一技能告诉策略这段行为该怎样收尾、接到后面。推理时,策略在连续多个时间步上持续预测出下一技能,才认为当前技能完成,条件前移一位;汇总多个时间步是为了避免单个预测触发过早切换。技能序列可以来自脚本,也可以由同一个分类器从一段人类提示视频中提取。
实现细节:观测是 224×224 的 RGB 图像加 33 维的本体与技能状态(手腕 3 维位置与 6 维旋转、12 个手部关节角、当前与下一技能的 6 + 6 维 one-hot);执行时手臂 6 自由度由预测的手腕位姿经逆运动学求出,手部 12 个关节直接下发,合计 18 自由度。观测历史 2 步、预测 32 步、执行前 16 步,以 20 Hz 运行,推理用 10 步 DDIM。先在约 240 段转换后的人类示范上预训练 120k 步,再混入约 32 段遥操作示范(每个技能约 8 段,各自只做一个技能)微调 70k 步,单块 NVIDIA A100。硬件是 RB5-850E 机械臂加 xHand 灵巧手,相机是 Intel RealSense D435i,只用 RGB。
结果:77.5% 数的是什么
四个技能是:抓放绿盒子、抓放红盒子、杯子任务、叠碗。对照方法 UniSkill 用同样的转换数据、同样的 120k 步预训练和 70k 步微调,只有技能表示不同。
| 方法 | 单技能:绿 / 红 / 杯 / 碗 | 单技能平均 | 序列中:绿 / 红 / 杯 / 碗 | 序列合计 |
|---|---|---|---|---|
| UniSkill | 80 / 20 / 20 / 60 | 45.0 | 0 / 0 / 0 / 0 | 0.0 |
| DexStitch | 100 / 100 / 40 / 80 | 80.0 | 80 / 70 / 80 / 80 | 77.5 |
分母很小。单技能每个技能 5 次,所以 100% 是 5/5、40% 是 2/5,平均 80.0% 相当于 20 次中 16 次。序列设置是 10 次四技能序列,即 40 次技能执行、每个技能 10 次;77.5% 对应 40 次中的 31 次(本站换算)。也就是说,77.5% 是“序列中每次技能执行”的成功率,不是“四个技能全部做完的序列”的比例。论文没有给出 10 次序列中有几次四步全部成功,也没有说明某个技能失败后后续技能是否继续执行或重置。杯子任务的叫法也不一致:任务列表写“递杯子”(handing over a cup),表 I 的说明写“挂杯子”(hanging a cup)。
作者把与 UniSkill 的差距归于技能表示,尤其是否对过渡建模,理由是两者数据和训练预算相同;这一归因是作者的解读,没有单独的检验。
分类器:240 段人类示范中 216 段训练分类器,留出 24 段(18,792 帧)评测。对照是零样本提示的两个视觉语言模型,在同样的 2 Hz 决策时刻和同样的因果窗口上回答同一个封闭集问题:
| 方法 | 准确率 | Macro-F1 | Edit | F1@50 |
|---|---|---|---|---|
| Qwen2.5-VL-7B(零样本) | 65.8 | 66.0 | 70.3 | 41.0 |
| InternVL3-8B(零样本) | 57.8 | 56.7 | 47.5 | 28.5 |
| V-JEPA 2 + MLP(本文) | 92.4 | 92.7 | 99.6 | 99.0 |
作者报告,本文分类器切出 242 段,真值 241 段,除一个回合外技能顺序全部一致;差距集中在过渡上,过渡的 F1 本文 0.89、Qwen 0.41、InternVL 0.18。要注意,这是在同一套场景数据上训练过的分类器与零样本模型的比较,说明的是这套设置下切分的可用性,不是两类模型的一般能力对比。
消融(四技能序列设置,%):
| 变体 | 成功率 |
|---|---|
| 去掉人类数据 | 35.0 |
| 去掉遥操作数据 | 5.0 |
| 去掉过渡技能 | 10.0 |
| 去掉下一技能条件 | 7.5 |
| 微调时遥操作占 50% / 75% / 100% | 10.0 / 20.0 / 50.0 |
| 完整方法(遥操作占 90%) | 77.5 |
作者的解读:两种数据单独都不够;去掉过渡技能或下一技能条件,失败主要出现在过渡处,因为同一个过渡要根据后面的技能走向不同的状态;微调中保留少量合成数据(遥操作占 90%)比只用遥操作数据(50.0%)好。论文写“所有变体都使用 90% 的遥操作比例”,但比例组和“去掉遥操作数据”显然不在此列,以表为准。如果消融也以 40 次技能执行为分母,5.0% 相当于 2 次、7.5% 相当于 3 次(本站推算,论文没有写明消融的分母)。比例只试了 50%、75%、90%、100% 四档,“90% 是峰值”只在这四档之间成立。
和站内已有内容的关系
物理AI实验室 1.5:数据从哪来讲过人类视频的难处:人手不是机器手,视频里没有精确的关节角,也没有力。DexStitch 用重定向补上了关节角,用修补与合成让画面变成机器人的样子;但它得到的仍是运动学轨迹,不含力或触觉信息,实际执行的落差由约 32 段遥操作微调去弥补。
物理AI实验室 1.6:模仿学习讲过误差会把机器人带出示范覆盖的范围,并把 Diffusion Policy 论文数字放回其实验条件。DexStitch 的策略就是一个 Diffusion Policy;它把同样的问题放到技能边界上看:上一个技能留下的状态,可能不在下一个技能的训练起点里,所以它让过渡本身成为有标签、被监督的技能。
物理AI实验室 1.8:评测练过先问分母和条件。这里 100% 是 5 次中的 5 次,序列结果的单位是技能执行而不是整条序列,这两点都要在转述时写清。
前沿雷达|Cracking Mobile Manipulation同样关注技能串起来之后的表现,报告的是整个长程任务的成功率;DexStitch 的 77.5% 是序列中每次技能执行的成功率。两篇论文的机器人、任务和指标都不同,数字不能互相比较。
局限 / 注意
- 这是 arXiv 预印本,全部数字为作者报告 [R],本站没有复现。本站所读文本中没有代码或项目页链接,文中也不链接。
- 作者自己写明两点局限:合成假设是包握(拇指在前、其余手指在后),捏取和自上而下的抓取不在这条规则内;组合只在一种固定的四技能顺序上评测,训练中没有出现过的顺序还没有测,因此“可组合”的结论尚未被直接检验。
- 真机评测规模小:单技能每个技能 5 次,序列 10 次。论文没有报告置信区间或显著性检验,也没有报告整条序列全部成功的次数。
- 转换质量只有定性图示,没有量化指标;分类器的对照是零样本视觉语言模型,而本文分类器在同一场景的 216 段视频上训练过。
- 所有实验都在一套硬件(RB5-850E 加 xHand、一台 D435i)和四个家务技能上完成;人类视频与机器人场景的具体对应关系、录制者人数和场景变化,所读正文没有展开。
- 重定向只保证运动学上的接触点对齐,不包含力;真机执行的安全性不在论文讨论范围内,本文的结果也不构成硬件安全验证。
链接
- DexStitch: Learning and Composing Dexterous Skills from Human Videos via Contact-Aware Robotic Inpainting(arXiv 2610.17789)
- 论文 HTML 全文
- 物理AI实验室 1.5:数据从哪来,从 SO-101 元数据算出示范时长,再分清三条来路的单位与动作空间
- 物理AI实验室 1.6:模仿学习,手算误差怎样滚出示范覆盖范围,再把 ACT、扩散策略与数据规模律的数字放回各自条件
- 物理AI实验室 1.8:评测,把“净增 2”拆成配对表,再给失败标签和随机种子算一笔账
- 前沿雷达|Cracking Mobile Manipulation:子任务成功率 80%,串成移动操作只剩 19%,先给失败回合归因,再逐段加干预
- 物理AI实验室:一套每个数字都能核对的物理 AI 课程(课程大纲)