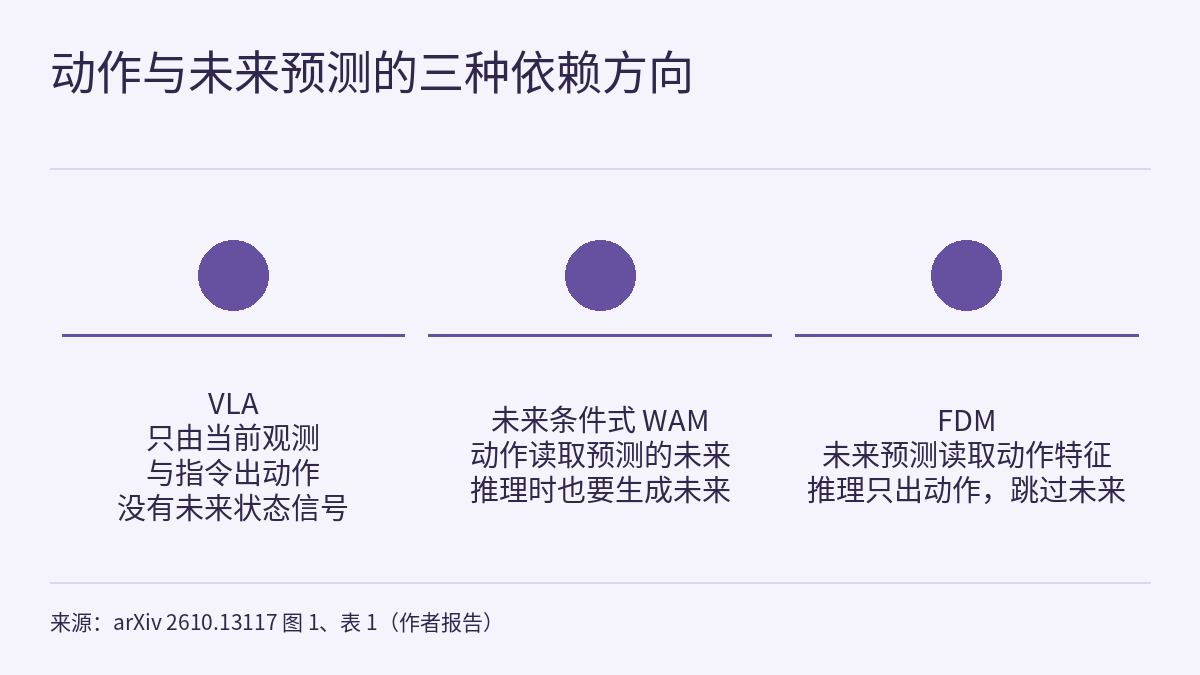
复旦大学数据科学学院等机构作者的预印本 Forward Dynamics Models(FDM,arXiv 2610.13117,2026-10-09)讨论的是机器人动作模型里一个设计选择:动作预测和未来状态预测之间,谁读谁。VLA 直接从当前观测和指令输出动作,训练时没有“接下来会发生什么”的监督;常见的未来条件式世界动作模型(WAM)先预测未来再推动作,推理时必须生成未来,未来预测的误差也会传进动作。FDM 把方向反过来:训练时让未来预测分支读取动作特征,未来损失经这些特征反传给策略;动作路径看不到任何未来信息,所以推理时可以完全跳过未来生成。作者报告 LIBERO 平均成功率 99.4%,在双臂 ARX-X5 机器人的五项真机任务上平均 96%(π0.5 为 83%)。以下数字均为作者报告 [R],本站未复现。
三种依赖方向
论文表 1 用同一套记号比较三类模型:C = (O_t, L) 是当前观测与任务指令,A 是动作块,V 是未来世界状态的目标。
| 模型族 | 训练 | 推理 |
|---|---|---|
| VLA | p(A | C) | p(A | C) |
| 未来条件式 WAM | p(V | C) · p(A | C, V) | p(V | C) · p(A | C, V) |
| FDM | p(A | C) · p(V | C, A) | p(A | C) |
作者强调,这个分解只是对依赖关系的概念表述,真正起作用的是表示层的连接:未来预测分支读取的是动作专家的隐状态 H_a,不是最终输出的数值动作。未来损失对 H_a 求梯度,再传回产生 H_a 的动作专家参数,于是真实的未来状态在训练中监督了“用来生成动作的内部特征”。
实现上,两个实例都用混合 Transformer(MoT)把几个专家逐层用注意力连起来,并用非对称的注意力掩码规定谁能看谁:上下文只看上下文;动作看上下文和动作;未来生成可以看全部三组。论文还特别说明,这个限制也适用于间接路径:动作专家能读到的上下文特征,本身也不能依赖生成分支的 token。
两个实例:在 VLM 和视频生成模型上各做一个
FDM w/ VLM。 在 π0.5 上加一个随机初始化的生成专家,结构与动作专家相同。生成专家读取当前帧之前第 15 帧(按记录帧计)和当前帧的 Wan VAE 潜变量,加上上下文与动作特征,对每个相机视角直接回归当前帧之后第 15 帧图像的潜变量,用 MSE 损失,一次前向,不做视觉去噪循环。上下文专家只处理当前图像和指令,所以历史帧只服务于训练时的未来预测,部署时不需要。部署时生成专家和它的 VAE 处理都可以拿掉。
FDM w/ VGM。 在视频生成模型 Wan2.2-5B 上加一个随机初始化的动作专家。视频主干同时承担上下文处理和未来生成:当前帧潜变量保持干净,未来视频潜变量用 flow matching 加噪训练,损失只算在未来潜变量上。同一个生成专家里,当前观测 token 和未来视频 token 的注意力权限不同,动作专家只能读前者。部署时保留当前观测的处理,并在每层缓存其 key/value,每一步动作去噪只更新动作流,不分配未来视频 token。
两个实例的总损失都是动作 flow matching 损失加未来损失,权重 λ_a = λ_v = 1。训练用 8 块 NVIDIA H100,推理在 1 块 H100 上进行。两个 FDM 都没有做机器人策略预训练,而表中对比的 π0、π0.5、Motus、LingBot-VA 都做过。
结果:仿真两个基准和五项真机任务
| 基准 | 方法 | 平均成功率(%) | 同组对比 |
|---|---|---|---|
| LIBERO(4 个套件) | FDM w/ VLM | 99.4 | π0 94.1,π0.5 96.9 |
| LIBERO(4 个套件) | FDM w/ VGM | 98.1 | Motus 97.7,LingBot-VA 98.5 |
| RoboTwin 2.0(50 个任务) | FDM w/ VLM | 81.20 | π0 62.16,π0.5 79.75 |
| RoboTwin 2.0(50 个任务) | FDM w/ VGM | 89.23 | Motus 87.8,LingBot-VA 92.20 |
摘要里的“state-of-the-art 99.4%”来自 VLM 一组。分开看还有几处 FDM 并非最好:VGM 一组在 LIBERO 平均和 RoboTwin 平均上都低于 LingBot-VA,LIBERO-Long 上 FDM w/ VGM 为 94.2%,低于 Motus 的 97.6% 和 LingBot-VA 的 98.5%;RoboTwin 的 Clean 条件下 FDM w/ VLM 为 81.54%,低于 π0.5 的 82.74%,它的优势来自随机化条件(80.86% 对 76.76%)。
真机实验用双臂 ARX-X5 做五项任务:装抽屉、装箱并合盖、插两只羽毛球、叠杯、叠积木,每种方法每项任务 20 次。FDM w/ VLM 平均 96%,π0.5 为 83%;FDM w/ VGM 平均 83%,FastWAM-Joint 为 78%,DreamZero 为 71%。本站的解读是:摘要中“真机绝对提升最多 13%”与 96% 对 83% 这一组的 13 个百分点一致,论文没有写明这一对应关系。这里的 FastWAM-Joint 是作者自己实现的未来条件式 WAM,与 FDM w/ VGM 结构相同,只把跨专家注意力的方向反过来;它是一个干净的对照,但不是其他论文发布的原版模型。
消融:反传这条路径到底值多少
作者在五项真机任务上比较四种变体,用相同的训练种子,且都只做动作推理:
| 变体 | 未来监督 | 未来分支读 H_a | 未来损失经 H_a 反传 | VLM 平均(%) | VGM 平均(%) |
|---|---|---|---|---|---|
| A. 只学动作 | 否 | 否 | 否 | 83 | 66 |
| B. 只基于上下文的未来预测 | 是 | 否 | 否 | 87 | 72 |
| C. stop-gradient | 是 | 是 | 否 | 89 | 78 |
| D. 完整 FDM | 是 | 是 | 是 | 96 | 83 |
C 和 D 的前向计算完全相同,区别只在训练时梯度是否经过动作特征接口,因此 D 比 C 高出的 7 和 5 个百分点,是作者用来说明“反传监督”本身价值的证据。B 比 A 高 4 和 6 个百分点,说明单纯加未来预测的视觉共训练已有帮助;D 比 B 再高 9 和 11 个百分点,这部分混合了前向读取和反向监督两者的作用。作者另外报告,经动作接口传回的未来梯度与动作模仿梯度的余弦相似度大多为正。
误差传播和计算代价
作者在 FastWAM-Joint 的联合去噪中途向未来视频潜变量注入一次高斯噪声,观测和加噪动作块不变。扰动强度 α = 1.0 时,动作误差在 LIBERO 上增加 4.44%,RoboTwin 上增加 5.52%,五项真机任务上增加 0.22%(Box)到 1.17%(Cup);小扰动在 LIBERO 和 Box 上反而让误差略降。作者没有报告对 FDM 的这项测量:动作路径从不读取生成的未来,所以在参数、输入和采样随机性固定时,扰动未来不会改变动作。图中 FDM 的零线是结构上的不变性,不是测量值。
| 方法 | 训练步时(s) | 峰值显存(GiB/GPU) | 推理延迟(ms/动作块) |
|---|---|---|---|
| π0.5 | 0.4436 | 67.08 | 203.77 |
| FDM w/ VLM | 0.6305(+42.14%) | 72.04 | 202.98 |
| FastWAM-Joint | 0.9754 | 66.80 | 446.55 |
| FDM w/ VGM | 0.9729(−0.26%) | 66.80 | 253.45(1.76 倍加速) |
两条路线的代价落在不同地方:VLM 版推理延迟与 π0.5 持平,但训练每步慢 42.1%;VGM 版训练成本基本不变,推理因省掉未来视频生成而比 FastWAM-Joint 快 1.76 倍(正文写作 1.8 倍)。
和站内已有内容的关系
物理AI实验室 1.6:模仿学习讲的是行为克隆和动作分块:策略从示范学“看到什么、做什么”。FDM 指出的正是这种训练缺了“做了之后会怎样”的信号,它补这个信号的方式不改变部署时的动作推理:仍然只从当前观测和指令去噪出动作块。
前沿雷达此前介绍的 HWAM 走了另一条路:它把执行后的本体状态和动作拼在一起联合去噪,动作通道可以看到部分去噪的状态通道。FDM 则明确禁止动作读取任何未来信息。两篇论文的预测目标(本体状态与未来图像/视频潜变量)、平台和任务都不同,数字不能互相比较;可以并排看的是依赖方向这一设计维度。
读真机数字时,可以用 物理AI实验室 1.8:评测里的问题去问:每种方法每项任务 20 次,五项合计 100 次;所读正文没有给出置信区间或不同训练种子之间的波动,消融各变体之间几个百分点的差距,有多少落在抽样误差之内,论文没有回答。
局限 / 注意
- 这是 arXiv 预印本,全部数字为作者报告 [R],本站没有复现。论文列出了项目页,本站没有核对。
- FastWAM-Joint 是作者自己的实现,扰动分析和效率对比都基于它,不代表其他已发布 WAM 的表现。
- FDM 对未来扰动“不敏感”是结构上成立的,不是实验测得;FastWAM-Joint 在 α = 1.0 时动作误差的增幅在 0.22% 到 5.52% 之间,这个量级对闭环成功率的影响,论文没有单独测。
- FDM 没有做机器人策略预训练,基线做过;两者训练设置不同,表中差距不能完全归因于依赖方向。
- 真机部分只有一台双臂 ARX-X5、五项任务,未报告置信区间;消融只比较平均成功率。
- 本站所读文本在附录 A.5 处截断,不含附录 C(训练超参数)、附录 D(硬件与任务细节)和附录 E(RoboTwin 逐任务结果)。
- 论文的 AI 使用声明写明,生成式 AI 只用于辅助写作、LaTeX 排版和信息检索,未用于方法、实验、代码、数据处理或结果解读。