
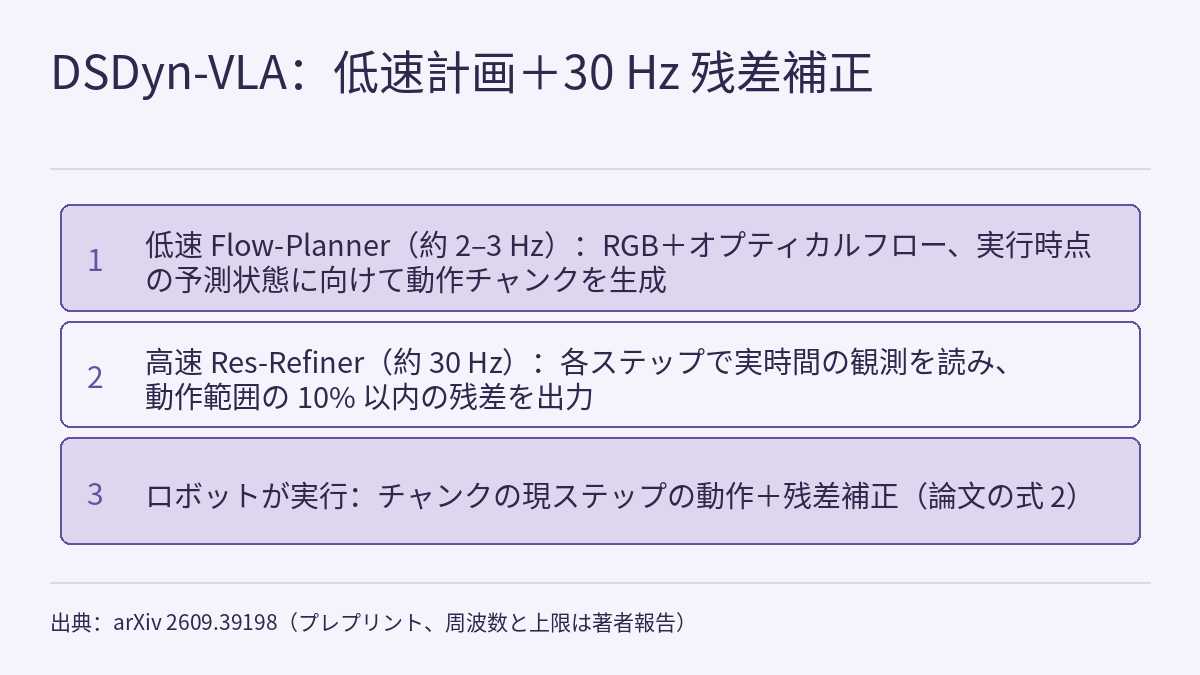
コンベヤー上のキューブ、動いているカップ。対象が動き出すと、静的なタスクを得意とする VLA は空振りしやすくなります。シドニー大学、中南大学、UC San Diego、Ace Robotics によるプレプリント DSDyn-VLA(arXiv 2609.39198、2026-09-30、証拠レベル [R])は、その原因を知覚・レイテンシ・制御の 3 つのギャップに分け、約 2–3 Hz の低速ストリームで計画し、約 30 Hz の高速ストリームで残差補正を行います。著者報告では、実機の動的タスク 4 種の平均成功率は π0.5 の 8.4% から 49.0% に上がりました。これがアブストラクトの「約 6 倍」です。ただし、より注目すべきなのは最も強いベースライン DynamicVLA との比較で、38.1% 対 49.0% です。
3 つのギャップ:静的な VLA は動く対象のどこでつまずくか
論文は、現在の VLA が動的操作で失敗する原因を 3 種類に分類しています。
- 知覚ギャップ:標準的な VLA の入力は静止 RGB 画像で、意味情報は残りますが動きの手がかりは失われます。速度の情報がなければ、対象の軌道や接触までの時間を推定できません。
- レイテンシギャップ:非同期推論では、行動バッファーの残りが
T_latステップになった時点で VLA が推論を始めます。そのため動作はT_latステップ前の状態から生成され、その後に実行されます。静的な場面ではほぼ問題になりませんが、対象が動いているとずれが生じます。 - 制御ギャップ:動作チャンク(action chunk)は実行が始まるとオープンループで進み、次の推論まではロボットは環境の変化が「見えない」状態になります。
関連研究のうち RTC、VLASH、DynamicVLA は主にレイテンシギャップを扱っています。著者は、これらの手法も静的な視覚入力とオープンループのチャンク実行に依存しており、残り 2 つのギャップは解決していないと主張しています。
低速ストリーム Flow-Planner:オプティカルフローを入力し、実行時点に向けて計画する
低速ストリームは π0.5 アーキテクチャ(条件付き flow matching 方策)をベースに、2 点を変更しています。
- 動きを捉える知覚:RAFT-Large で連続する 2 フレーム間の密なオプティカルフローを抽出し、極座標マッピングで 2 チャンネルのフローを RGB 風の 3 チャンネル画像に変換します。方向を色相、速さを彩度に対応させ、CLIP の事前学習済み意味空間に合わせるためです。RGB 画像とフロー画像は並列の 2 つの Vision Transformer エンコーダーに入り、出力トークンは系列方向に連結されます。
- 将来状態の認識:推論中もロボットは前のチャンクのバッファー済み動作を実行し続けており、この部分は確定しています。Flow-Planner はバッファー済み動作を順運動学で展開して実行時点の固有受容状態を計算し、観測時点ではなくその状態を条件として入力します。学習時はランダムな時間シフトを組み合わせ、時刻 t の画像を t+Δ の固有受容状態と動作チャンクに対応付けます。
学習は 2 段階です。第 1 段階では動的なデモンストレーションデータを使い、時間シフトを加えて Flow-Planner を教師ありファインチューニングします。第 2 段階では Flow-Planner を凍結し、高速ストリームだけを学習します。
高速ストリーム Res-Refiner:30 Hz の上限付き残差
高速ストリームは軽量な残差方策です。ResNet-10 の視覚バックボーンに 8 個の学習可能な空間ブロックを加えて 256 次元の表現を得ます。これを固有受容状態および Flow-Planner の現ステップの動作と連結し、256 ユニットの隠れ層 2 層からなる MLP に入力して、Tanh で圧縮した残差を出力します。実際に実行される動作はチャンクの現ステップと残差の和(論文の式 2)で、残差は各次元で動作の全範囲の 10% 以内に制限されています。
学習には RLPD を使います。報酬は疎な二値報酬で、リプレイバッファーの半分をオフラインのデモンストレーション、半分をオンラインの経験とし、複数の critic のアンサンブルで Q 値の過大評価を抑えます。実機ではタスク成功を人が確認したうえで報酬を与え、RL 段階はタスクごとに約 30–60 分かかります。
著者が報告した結果
実機は 6 自由度の Agilex Piper アームと 2 台の Intel RealSense D435 カメラです。低速ストリームは π0.5 ベースでチャンク長 10、高速ストリームは 30 Hz で動作します。タスクはコンベヤー上での把持、動く容器への投下、動くキューブへの積み重ね、動くカップへの注水の 4 種で、それぞれ 5 回 × 50 試行です。
| 実機タスク(成功率) | π0.5 | RTC | VLASH | DynamicVLA | DSDyn-VLA |
|---|---|---|---|---|---|
| コンベヤー把持 | 8.8% | 12.4% | 20.0% | 33.2% | 44.8% |
| 動的な投下 | 14.8% | 43.6% | 50.0% | 56.0% | 62.8% |
| 動的な積み重ね | 1.2% | 2.4% | 6.8% | 18.0% | 32.0% |
| 動くカップへの注水 | 8.8% | 16.0% | 30.4% | 45.2% | 56.4% |
| 平均 | 8.4% | 18.6% | 26.8% | 38.1% | 49.0% |
最も強いベースライン DynamicVLA に対しては、平均で 10.9 ポイント、タスクごとに 6.8〜14.0 ポイントの向上です。「約 6 倍」は π0.5 に対する倍率です。
シミュレーションでは 2 種類の評価があります。DynBench は著者が構築した MuJoCo ベンチマークで、Franka Panda アームと 9 タスク(うち 4 つは実機タスクを移植)からなり、各タスクにルール生成のデモンストレーションが 100 本付き、評価は 100 試行です。平均成功率は π0.5 が 9.7%、RTC 19.4%、VLASH 27.1%、DynamicVLA 34.3%、DSDyn-VLA 48.4% でした。Kinetix は状態ベースのベンチマークで、著者は 12 タスクに 0–4 ステップの人為的な遅延を加え、各設定 2048 試行で評価しています。論文によれば高遅延の設定で SOTA 手法の失敗率を 13% から 3% に下げ(アブストラクトでは 76% 超の削減と表現)、最大遅延(δ=4)でも成功率は 97% を超えています。付録では、静的な LIBERO の 4 スイートで π0.5 を下回らないこと(例:LIBERO-10 で 93.30% 対 92.60%)、外部の動的ベンチマーク DOMINO で成功率 20.74% と PUMA の 17.18% を上回ったことも報告されています。
アブレーションとオーバーヘッド
実機の設計アブレーション(4 タスク、50 試行)では、完全なモデルが 48.5% です。オプティカルフローを除くと 30.5%、極座標マッピングを除くと(ResNet-34 でフローを直接エンコード)33.0%、将来状態の認識を除くと 36.5%、Res-Refiner を除くと 25.0%、Res-Refiner を RL ではなく教師ありファインチューニングで学習すると 37.5% でした。DynBench では Refiner と Future のどちらを除いても 42.7%、フロー分岐を除くと 35.3% です。
「向上は時間方向の文脈や追加の RL が増えただけではないか」という疑問に対し、付録 D では RTC、VLASH、DynamicVLA にそれぞれ過去フレーム 2 枚とエンドツーエンドの PPO 1 時間を追加しています。3 手法はそれぞれ 18.0% から 24.0%、26.5% から 32.5%、37.5% から 39.0% に上がりましたが、DSDyn-VLA の 48.5% には届きません。オプティカルフローを単純なフレームスタックに置き換えると 42.5% でした。
RTX 4090 でのモジュール別計測では、VLA バックボーンが合計 73 ms、システムレイテンシ 13 ms、RAFT-Large 3 ms、フローエンコーダー 14 ms、運動学による展開が 1 ms 未満で、Flow-Planner 全体は 103 ms です。Res-Refiner は合計 3 ms で、30 Hz の 1 周期(約 33 ms)に収まります。動的な積み重ねと動くカップへの注水の 2 タスクでは、残差は 95.8% のケースで全次元が上限の 80% 未満にとどまりました。著者は上限が使い切られることはまれだとし、10% の予算で足りることを示唆するとしています。オプティカルフローの品質が落ちると成功率は段階的に下がり、70% の遮蔽で 42.0%、点滅する照明で 40.5% でした(クリーンな条件では 48.5%)。
本サイトの既存ページとの関係
『フィジカルAIラボ 0.3:見る・考える・動く――3 つの周波数をそれぞれのシステムに戻す』は「大脳はゆっくり考え、小脳はすばやく動かす」というたとえを使い、それがたとえにすぎないことを強調しています。DSDyn-VLA の著者も、デュアルストリーム設計は大脳と小脳の役割分担に着想を得たと述べています。この回のルールに従えば、ここでの約 2–3 Hz と約 30 Hz は DSDyn-VLA というシステムだけのもので、ほかのモデルやインターフェースの周波数と組み合わせて読むべきではありません。シーズン全体の構成は講座の概要をご覧ください。
『VLaRL』も基盤方策を凍結して残差 RL を重ねますが、残差はシミュレーションだけで学習し、実機での RL は行いません。DSDyn-VLA は人が与える二値報酬を使って実機で残差を学習し、1 つのチャンクを実行している間も動く物体に追従することを狙っています。103 ms の内訳は『フロンティア・レーダー特集|エッジとリアルタイム性』と併せて読めます。論文は高速ストリームをエッジデバイスに配置できるとしていますが、示されている計測値はすべて RTX 4090 でのものです。
制約と注意点
- arXiv のプレプリントであり、数値はすべて著者の報告です。本サイトではいずれも独自に再現していません。アブストラクトはコードと重みをすべて公開するとしており、再現性に関する記述ではコードは補足資料に含まれ、重みは論文の正式出版時に公開するとしています。本記事が依拠した資料には公開リポジトリのアドレスはありません。
- Kinetix の実験では、Flow-Planner は動作チャンク(H=8)を予測する MLP 方策に置き換えられ、オプティカルフローのモジュールも省かれており、比較対象は RTC と VLASH だけです。この実験が検証しているのは将来状態の認識と残差補正で、視覚を使う完全な VLA ではありません。
- DynBench は著者自身が構築したもので、デモンストレーションはルール生成です。実機評価は単一のプラットフォームと 4 タスクで、報酬は人が判定し、RL はタスクごとに個別に行っています。
- 実機のメイン表(49.0%、各タスク 5 回 × 50 試行)、設計アブレーション(48.5%、50 試行)、付録 D のベースライン値(試行数の記載なし)は互いに少しずつ違い、論文はその違いを説明していません。表をまたいで比較する際は注意が必要です。
- 著者は結論で、残差方策の汎化や、より多くのタスクとプラットフォームでの実機評価には拡張の余地があり、人と共有する環境での安全性と失敗のリスクには慎重な対応が必要だと述べています。
リンク
- arXiv 2609.39198:DSDyn-VLA: A Dual-Stream Dynamic Manipulation Framework with Motion Perception, Future Awareness, and Realtime Correction(著者:Wenhao Li、Xiu Su、Yu Han、Yichao Cao、Shan You、Chang Xu)
- 論文の HTML 全文


